Разгоняю по Black SEO 🥧, работе с фармой и гемблой
Контакт - @rxjohngalt
Post #89
749

Братики, всем шалом! 💜
Первые сайты в прод выкатили позавчера. За эти три месяца я настолько погрузился в процесс производства от выбора бренда, GEO, контента и генерации, что сейчас открываю свой первоначальный пост с планом и местами мне становится смешно, там одна маленькая строка - «Собираем RAW дату по брендам», все 😂
В чатиках братики обсуждают AI модели, эта пишет пиздато, а эта еще круче, а эта вообще заебись и надо срочно переезжать. Когда-то я также на это смотрел, но сейчас по другому - похуй какая модель будет писать контент - по факту.
Сейчас одну из самых больших ставок во всем проекте я делаю именно на качество входных данных и RAW дату ✔️
Тогда для меня это был один из этапов большой системы, а сейчас я понимаю, что вокруг этой одной строчки начала строиться львиная и одна из ключевых частей проекта.
Здесь же был и мой главный проеб, когда я решил сразу строить ракету с Headless CMS, модулями, автоматизацией, деплоем, тысячами доменов, GSC и TDS, хотя надо было взять несколько реальных брендов и сначала пройти весь путь, потыкать палкой-ковырялкой и от начала до конца.
Последние три месяца мы этим и занимались, база монобрендов, GEO, TDS крупных команд, аффилиаты из топа, а потом пошли к официалам и выяснилось, что «просто соберём RAW по каждому бренду» звучит сильно проще, чем это сделать.
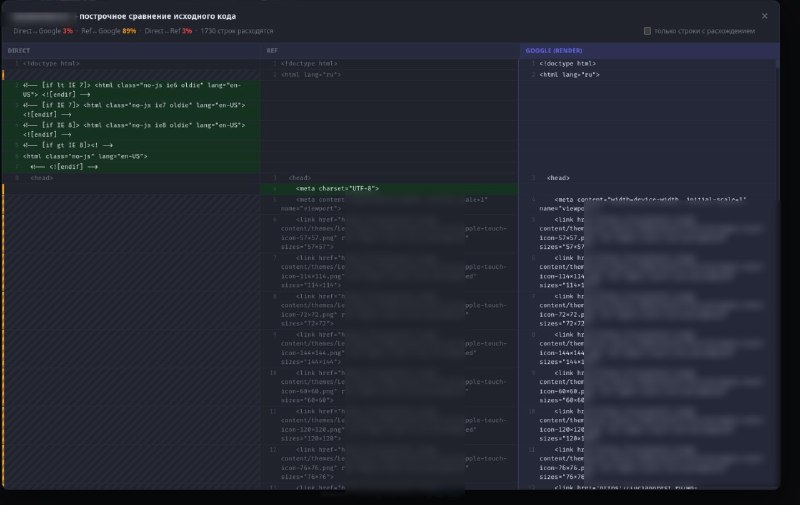
Все в SPA, где-то контент после кликов, зависимость от GEO, парсер видит одно, браузер другое, дальше серверные прокси, резидентские соксы, защита CF, browser render, контент только с мобилки и еще вагон итераций, чтобы нормально собрать данные и ничего важного не потерять.
Контент на выходе все равно противоречил исходным данным.
Источник официальный, RAW правильный, entities достали, модели не разрешаем придумывать факты, а смысл какого-то условия по дороге до готового текста все равно меняется. Долго искали где именно происходит проеб, меняли промпты, допиливали проверки, снова гоняли генерацию, пока не провели один простой эксперимент.
Взяли несколько важных условий, которые постоянно терялись, и пять раз сгенерировали страницу, пять раз из пяти они до текста не доехали. Потом вернули в исходные данные несколько потерянных кусков, не меняя модель, промпт и вообще больше ничего, и в следующих генерациях условия появились.
Вот после этого у меня наконец сложилось в голове, где мы всё это время проебывались и почему часть проблем вообще не имело смысла лечить на уровне генерации AI контента.
Во второй части расскажу, чем это закончилось, потому что с entities оказалось всё намного интереснее. Почему правильная entity вообще не гарантирует правильный факт, как RAW может быть правильным, источник официальным, модель ничего не придумала, а готовый текст все равно врет, где именно терялся смысл и что в итоге мы начали отдавать модели на вход вместо коротких выжимок.
Про Google Natural Language API, как сравниваем официала и выдачу. Поможет ли это нам лучше ранжироваться в выдаче - моя гипотеза, в которую я ооочень верю. Как известно, время и факты покажут, а пока мнение можно засунуть себе в жопу.
Вторая часть поста уже готова, выкачу во вторник, накидайте пожалуйста 🔥
Прошло почти 3 месяца, где я заявил о том, что залетаю в гемблу. Сейчас кто-то подумает, ну всё, Джон – ебануться на ракете покажет пару тысяч доменов, стату, FTD, бабки и расскажет как он всех разъебал, а вот НИХУЯ 😂
Первые сайты в прод выкатили позавчера. За эти три месяца я настолько погрузился в процесс производства от выбора бренда, GEO, контента и генерации, что сейчас открываю свой первоначальный пост с планом и местами мне становится смешно, там одна маленькая строка - «Собираем RAW дату по брендам», все 😂
В чатиках братики обсуждают AI модели, эта пишет пиздато, а эта еще круче, а эта вообще заебись и надо срочно переезжать. Когда-то я также на это смотрел, но сейчас по другому - похуй какая модель будет писать контент - по факту.
Разница есть, но я понял очень важную вещь - можно взять самую пиздатую модель, но если на вход ты дал ей криво собранные данные, половину потерянных условий и факты хуй пойми откуда, она на основании этого очень красиво напишет тебе хуйню, а если у неё есть качественная RAW data официала, проверенные факты, условия, бонусы, платежки, игры, GEO, спрос из Ahrefs, entities конкретного рынка, с той же моделью получается совсем другая история.
Сейчас одну из самых больших ставок во всем проекте я делаю именно на качество входных данных и RAW дату ✔️
Тогда для меня это был один из этапов большой системы, а сейчас я понимаю, что вокруг этой одной строчки начала строиться львиная и одна из ключевых частей проекта.
Здесь же был и мой главный проеб, когда я решил сразу строить ракету с Headless CMS, модулями, автоматизацией, деплоем, тысячами доменов, GSC и TDS, хотя надо было взять несколько реальных брендов и сначала пройти весь путь, потыкать палкой-ковырялкой и от начала до конца.
Последние три месяца мы этим и занимались, база монобрендов, GEO, TDS крупных команд, аффилиаты из топа, а потом пошли к официалам и выяснилось, что «просто соберём RAW по каждому бренду» звучит сильно проще, чем это сделать.
Все в SPA, где-то контент после кликов, зависимость от GEO, парсер видит одно, браузер другое, дальше серверные прокси, резидентские соксы, защита CF, browser render, контент только с мобилки и еще вагон итераций, чтобы нормально собрать данные и ничего важного не потерять.
В какой-то момент «вроде» победили, на пол шишечки. Собрали RAW, вытащили entities, подключили Google Natural Language API, дошли до генерации, валидаторов, AI-судей и я уже думал, ну всё, теперь-то точно разъебали – понеслась, а вот НИХУЯ! ))))
Контент на выходе все равно противоречил исходным данным.
Источник официальный, RAW правильный, entities достали, модели не разрешаем придумывать факты, а смысл какого-то условия по дороге до готового текста все равно меняется. Долго искали где именно происходит проеб, меняли промпты, допиливали проверки, снова гоняли генерацию, пока не провели один простой эксперимент.
Взяли несколько важных условий, которые постоянно терялись, и пять раз сгенерировали страницу, пять раз из пяти они до текста не доехали. Потом вернули в исходные данные несколько потерянных кусков, не меняя модель, промпт и вообще больше ничего, и в следующих генерациях условия появились.
Вот после этого у меня наконец сложилось в голове, где мы всё это время проебывались и почему часть проблем вообще не имело смысла лечить на уровне генерации AI контента.
Во второй части расскажу, чем это закончилось, потому что с entities оказалось всё намного интереснее. Почему правильная entity вообще не гарантирует правильный факт, как RAW может быть правильным, источник официальным, модель ничего не придумала, а готовый текст все равно врет, где именно терялся смысл и что в итоге мы начали отдавать модели на вход вместо коротких выжимок.
Про Google Natural Language API, как сравниваем официала и выдачу. Поможет ли это нам лучше ранжироваться в выдаче - моя гипотеза, в которую я ооочень верю. Как известно, время и факты покажут, а пока мнение можно засунуть себе в жопу.
Вторая часть поста уже готова, выкачу во вторник, накидайте пожалуйста 🔥
- 🔥 65
- 👍 2
- 👎 1
- 🎉 1