Ограничение диффузионных моделей превратили в преимущество.
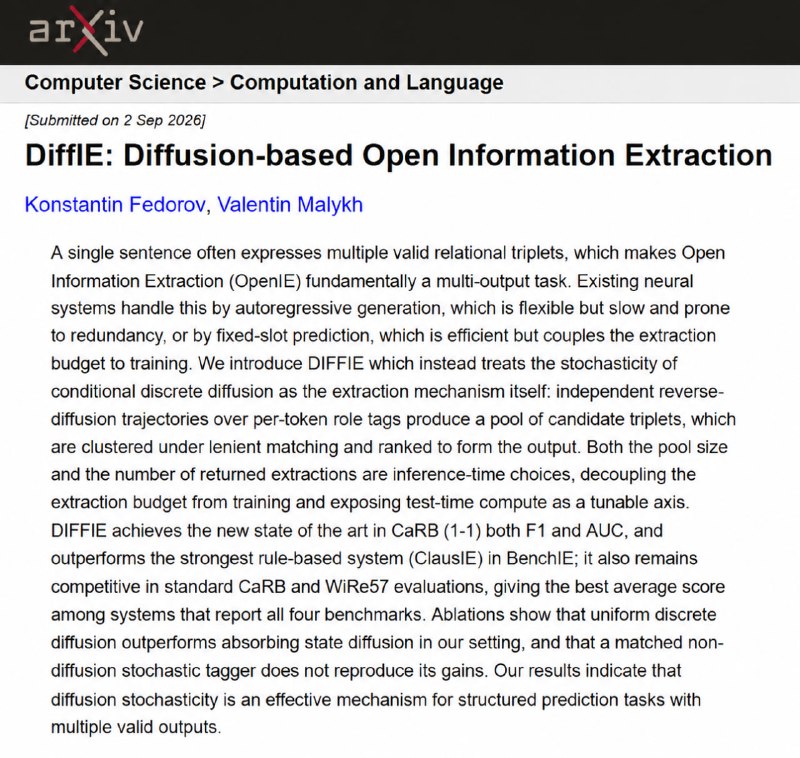
Диффузионные модели многие знают по генераторам картинок, но они работают и для текстов. Тексты они генерируют в чем-то похожим образом - случайным (для внешнего наблюдателя) образом расставляют слова, пока из них не получится связный текст. Исследователи MWS AI и ИТМО придумали, как использовать эту особенность для извлечения фактов из текста.
В статье DiffIE они предложили сразу генерировать разметку для всех возможных фактов в предложении. Каждый запуск может находить разные факты — например, о переезде человека и его новой работе. Затем система объединяет результаты и выбирает наиболее надёжные. Количество запусков можно менять без переобучения: меньше для скорости, больше для качества.
На тесте CaRB (1-1) метод установил новый SOTA — показал лучшие результаты по двум метрикам, оценивающим качество извлечения фактов из текста.
Работу Валентина Малых, руководителя центра разработки больших языковых моделей MWS AI, и Константина Фёдорова из AI Talent Hub ИТМО приняли на EMNLP 2026 — конференцию уровня A*. Она пройдёт 24–29 октября в Будапеште.
Post #7980
3.24K
- 🔥 31
- ❤ 16
- 👍 9
- 👾 4
- 👀 1
- 🙈 1