
Qwen-Robot Suite: пакет ИИ-моделей, переводящий естественный язык в физическое действие
16 июня 2026 года Qwen представила Qwen-Robot Suite — набор из трёх фундаментальных ИИ-моделей, который решает главную проблему воплощённого ИИ (Embodied AI) - разрыв между пониманием физического мира и действием в нём.
Фреймворк Qwen-RobotClaw позволяет мультимодальной модели Qwen VLM выступать в роли верхнеуровневого планировщика: она разбивает сложные абстрактные задачи на последовательность шагов, вызывает модели Qwen-Robot Suite для выполнения физических действий и управляет контекстом длительных операций.
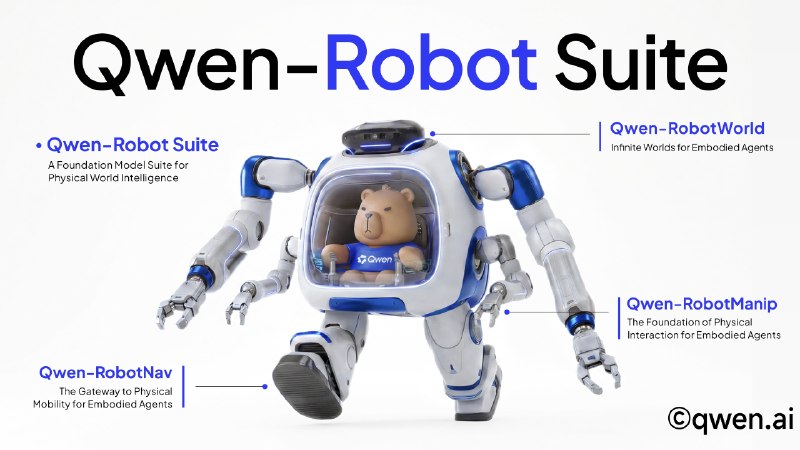
Qwen-Robot Suite включает три специализированные ИИ-модели:
•Qwen-RobotNav отвечает за навигацию и объединяет пять классов задач: следование инструкциям, навигацию по точкам, навигацию по целям, отслеживание объектов и автономное вождение. Модель обучена на 15,6 миллиона образцов. На робособаке Unitree Go2 с единственной базовой RGB-камерой модель продемонстрировала сквозную задержку 196 миллисекунд (приблизительно 5,1 Гц) и успешно ориентировалась в незнакомой квартире без предварительного построения карты. Ключевые результаты: 76,5% успеха в VLN-CE RxR и 75,6% в HM3Dv2.
•Qwen-RobotManip решает проблему морфологического разнообразия роботов. Движения различных конфигураций устройств проецируются в единую систему координат камеры, что делает их совместимыми на уровне представления и позволяет обучать модель на данных с различных платформ. Модель обучена на 38 100 часах данных из открытых источников. Ключевая инновация — автоматическая конвертация 1 933 часов обычных видеозаписей с действиями людей в 24 808 часов демонстрационных данных для 15 различных типов роботов. Конвейер обеспечивает это за счёт переназначения движений, удаления рук и дорисовки фона, симуляционного рендеринга и глубинного наложения изображений, а также многоэтапного процесса фильтрации данных для обеспечения их высокого качества.
•Qwen-RobotWorld представляет собой диффузионную нейросеть, которая предсказывает физическое будущее. По текущему кадру и текстовой команде она генерирует видео того, что произойдёт при совершении действия. Это позволяет роботу предсказывать и оценивать свои движения до физического выполнения, что снижает риск повреждения оборудования. Модель обучена на 8,6 миллиона пар видео-текст для более чем 20 типов роботизированных платформ.
Главным достижением Qwen-Robot Suite является не сама архитектура моделей, а новый подход к обучению роботов. Возможность преобразовывать обычные видеозаписи действий человека в роботизированные траектории (1 933 часа в 24 808 часов) открывает доступ к практически неограниченному массиву данных для обучения воплощённого ИИ. Именно дефицит качественных данных сегодня считается одним из ключевых барьеров на пути создания по-настоящему универсальных роботов и Alibaba предложила собственное авторское решение данной проблемы.
Источник: Qwen
Post #956
661
- 🔥 5
- ❤ 3
- 👍 2
- 👎 1