
Vision-Language Models Provide Promptable Representations for Reinforcement Learning
беркли и дипмаинд решили использовать VLM в довольно нетривиальном виде для рл - вместо того, чтобы подавать эмбеддинги влмки в ответ на текстовый запрос о действии напрямую в политику, авторы привносят то, что они называют promptable representations через текст и CoT, которые пытаются раскрыть world knowledge из модели.
то есть их метод не является instruction-following, а задает контекстуальный бекграунд (что бы это ни значило) в рамках рл формулировки
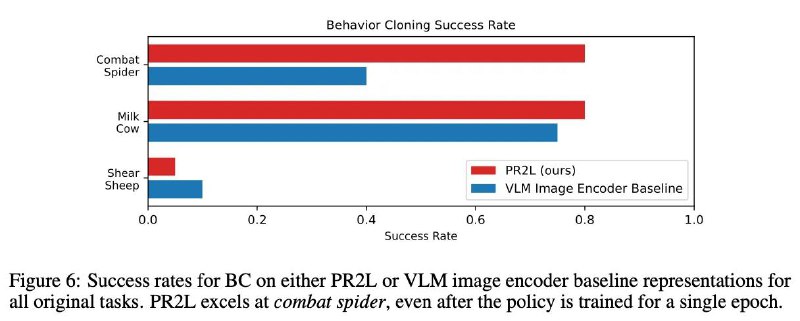
например - в майнкрафте они тестировали таску “грохнуть паука”. для этого они выдают в влм не текст “убей паука”, а что-то типа “пауки в майне черные, сейчас на кадре есть паук?”, что позволяет получить (интуитивно) более обобщенные репрезентации, которые полезны для мульти-таск сетапа и (возможно) более эффективного обучения
почему так? да потому что в принципе VLM (в данном случае InstructBLIP и PrismaticVLM) не обучены на то, чтобы принимать действия в среде (иначе это было бы VLA), а следовать инструкциям и отвечать на вопросы о картинках → так давайте и спрашивать про визуальную составляющую и семантику наблюдаемых действий, нежели сходу просить предпринять действие (это пусть решает политика)
модно-молодежно: показывают и оч жесткий sample-efficiency по сравнению с сотой на майнкрафте, мол в 10 раз меньше данных надо. верим, но имеем в виду что довольно сильно рaзнятся методы обучения
большой пункт для future work может заключаться в том, что эти промптабл промпты очень сильно подогнаны под евал среды (есть ли на картинке из майнкрафта паук)
👀 link, code (в виде юпитер ноутбука мда)
если что VLM используют активно и в роботике - например здесь
Post #841
6.07K




- ❤ 3