
LLMs Are In-Context Reinforcement Learners
продолжение банкета про ICRL
постановка почти такая же, как и в рл трансформерах на рл тасках, разве что все перекладывается на естественный язык - нету ground truth лейблов, а только свои действия модели и ревард за них + здесь авторы ввели довольно интересные рассуждения про составление большого контекста для ллмок
при заведении ин-контекст рл инференса из-под коробки не дает норм результатов, это связывают с неспособностью к эксплорейшну (который появляется у рл трансформеров из-за того, что такое свойство в основном присутствует в тренировочных данных - те самые learning histories of source algorithm)
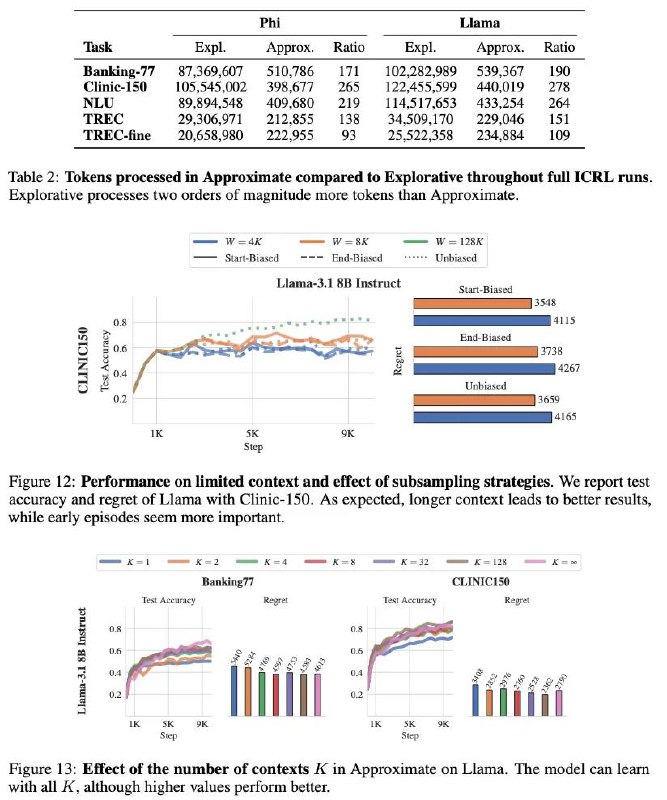
нивелируют авторы это при помощи того, что называют Explorative ICRL - для каждого инпута генерят новый контекст из рандомных эпизодов, тем самым получая вариативность и меньшую чувствительность к своим выборам → открывается больше поле для эксплора (интуитивно). параметризуется одним гипером - вероятностью добавить эпизод в контекст (по аблациям лучше выбирать не близкие к 0 или 1 значения, хотя рейндж у них не очень в экспериментах)
но! так ниче не получится кв-кэшнуть, ибо каждый раз контекст новый ⇒ сделали Approximate ICRL, где в буффере хранятся не эпизоды, а контексты из эпизодов, которые можно и кв-кэшнуть, и обновить на данном шаге контексты. при том по экспам могут модели перформить как с 2 разными, так и с 128 контекстами (но во втором сценарии лучше, уже как память позволяет)
в качестве моделей взяли мелкие лламу и phi, ибо они выдерживают контекст в 128к токенов. евалились на датасетах от 6 классов до 150 с классификацией интентов, вопросов, NLU and so on. ревард же составлялся в somewhat +1/-1 виде - словесно хвалили при правильном лейбле или говорили о неправильности аутпута (еще кстати провели аблацию на то, как лучше составлять ревард - оставлять ли только позитивную или негативную часть или все вместе. здесь тоже изучали этот вопрос, только с немного другого угла)
какие же инсайты пришли?
- только от сигнала награды (исрл) сходится с результату исл и на зеро-шоте аутперформит (просто потому что у исрл сетапа есть структурированный контекст имхо)
- перформанс получается лучше при сетапе только с позитивными ревардами, если брать только негативные или оба варианта, то получается ужасно и чуть хуже соответственно (подобные аналогии можно провести и с людьми [1] [2], но мб это я уже притянул за уши)
- Approximate не хуже Explorative
скорее всего, такое же поведение свойственно и моделям бОльшего скейла (разве что с эксплорейшном у них может быть получше при наивной имплементации исрл), остается теперь посмотреть, как ллмки будут реагировать на более информативные ревард сигналы - не только бинарные, но и действительные числа, например, которые относятся уже к более сложным задачам нлп, beyond classification
👀LINK
подслушано здесь
Post #573
452


- ❤ 1