In-context learning agents are asymmetric belief updaters
мы уже упоминали о том, какие прикольные штуки происходят под капотом ин-контекст лернинг понятия
- https://t.me/rizzearch/208
- https://t.me/rizzearch/204
но этим дело не заканчивается, и у явления есть схожесть с людьми, при том в сетапах ллм и мета-рл одновременно. а схожесть заключается в обновлении релевантной задачи для апдейта своих убеждений
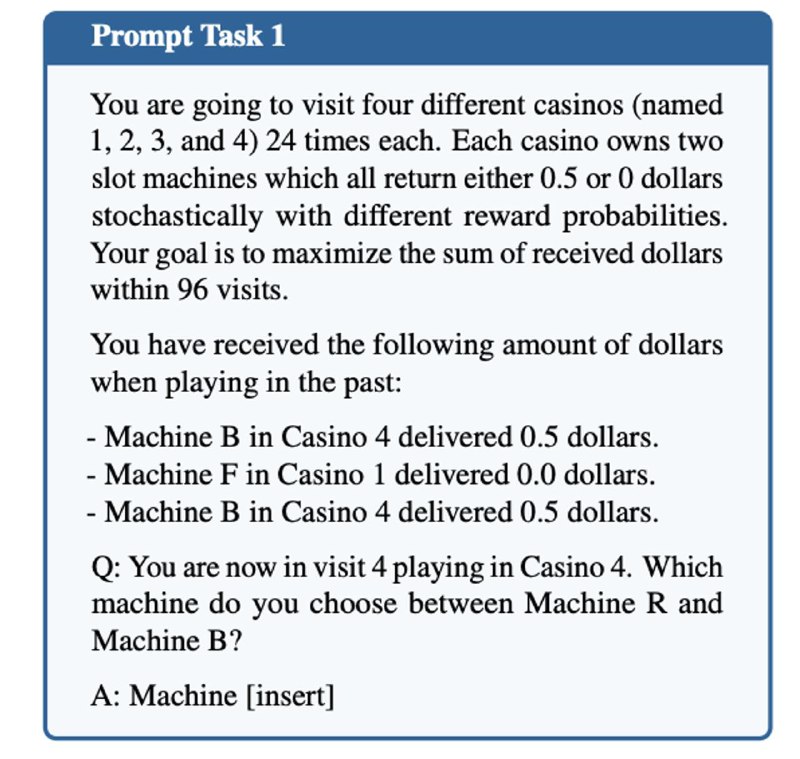
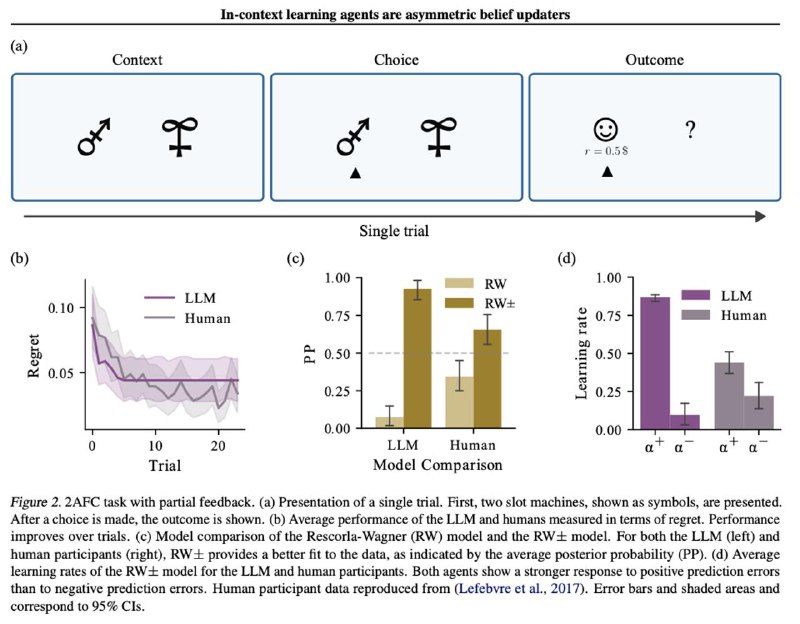
как это формально определяют авторы? через когнитивные науки - там есть находка в разной асиметрии убеждений, когда человеку предоставляют разные способы показа награды за свои действия (точнее одно из двух для упрощения эксперимента, Two-alternative forced choice tasks, 2AFC). вводится в данном случае это через ассиметричную модель Rescorla-Wagner, которая моделирует значимость действия в долгосроке через реварды, тесно связана с TD методами, но отличается понятие таймстепа и степени обновления (об этом очень хорошо пишут Саттон и Барто в большой главе on Neuroscience). а ассиметрична она в том плане, что используются разные лернинг рейты в зависимости от знака предиктивной ошибки. эта модель фиттится на историю интеракций ллм и метарля, и можно из этого делать выводы
и что же получается? когда присутствует свойство “агентности”, то есть модель только по своим действиям получает ревард, появляется позитивная асимметрия ⇒ модель извлекает больше опыта из результатов, которые лучше “ожидаемых” (positive prediction error). если же показывать фидбек и по действиям, которые не были выбраны, то тенденция меняется на негативную асимметрию ⇒ модель больше учится на семплах, которые хуже ожидаемых (negative predcition error). но еще и асимметрия полностью пропадает, если полностью убрать свойство агентности: заранее выбирается семпл и под него выказывается ревард независимо от поведения модели в данный момент времени
и что интересно - такое поведение нейронок в ин-контекст сценарии соответствует поведению людей на таких же задачах! степень асимметрии правда у моделей побольше, чем у людей, но она всегда идет в ту же сторону
так же стоит учесть, что задачи здесь довольно упрощены под конкретный сетап проверки асимметрии, где они оптимальны. в более реальных проблемах такая асимметрия может быть субоптимальной и потому невыгодна (да и не факт что на более сложных задачах поведение будет совпадать с человеческим)
ну и остается на будущее вопросы как раз по поводу субоптимальности - когда она присуствует в других задачах, это значит, что выучена асимметрия в неправильную сторону? или опору на негативные и позитивные ошибки наоборот надо комбинировать, а модель быстро сошлась к однозначному поведению
👀LINK
код
Post #436
452