
Reinforcement Learning with Action Chunking
action chunking все больше набирает популярность из-за своей практичности в имитейшн лернинг - можно сказать, что для роботики это уже необходимый элемент в пайплайне, включая pi
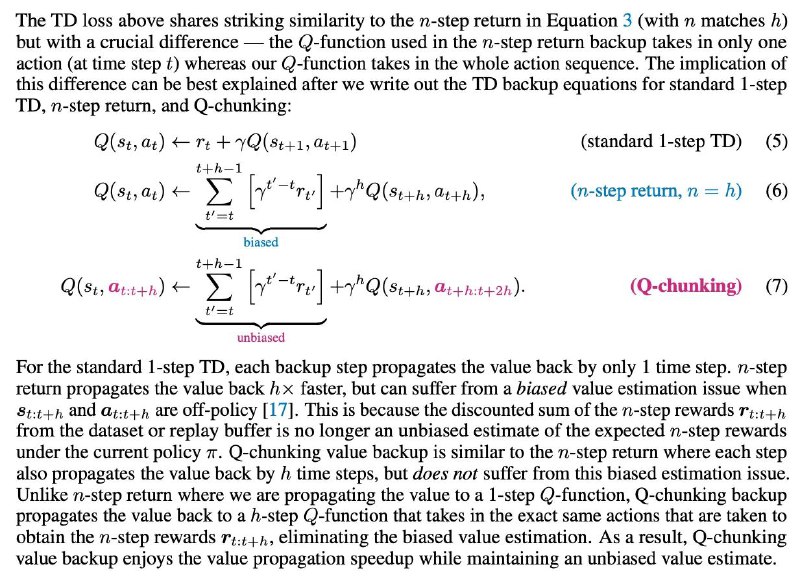
и вот сергей левин со своими студентами нацелился на применение этого трюка для классического пайплайна actor-critic q-learning’a. формулы обобщаются при том довольно интуитивно понятно и перестают быть марковскими - везде одно действие меняется на чанк действий, что даже улучшает понятие n-step return’a, где использовали для расчета значения критика n шагов вперед вместо одного, ибо тогда убирается смещение off-policy действий этого чанка действий
имплементится это через диффузию и флоу матчинг с ограничением на приверженность behavior policy в offline и offline-to-online рл сетапах. при том в сетапе с диффузией КЛ ограничение между политиками реализуют через best-of-n sampling (BFN), а с флоу матчингом сшивание идей происходит более гладко, без изменений в ключевых местах алгоритма FQL. экспы проводят над RLPD, где внутри онлайн степов батч состоит наполовину из онлайн и оффлайн буфферов
при том предикт по чанкам улучшает момент эксплорейшна, ибо, как спекулируют авторы, действия внутри одного чанка становятся более связанными относительно друг друга (в сравнении с 1-step методами) → при инференсе можем ожидать поведение получше + sample efficiency
пока и остается большой вопрос по поводу размера чанка, который сильно влияет на перформанс (на OGBench 10 действий в одном чанке у авторов лучше чем 25), а по балансу между рантаймом и sample efficiency неплохо было бы перепроверить, действительно ли обучение происходит быстрее бейзлайнов
👀 paper, code
Post #1025
1K



- 🔥 6
- ❤ 2