TGViewer
Channel Public Channel
Loser story

Loser story

@reverse13

Пишу всякое интересное про распределенные системы, базы данных и тд
https://github.com/serenedb/serenedb
https://github.com/MBkkt
Subscribers
946
Photos
153
Videos
0
Links
144

Showing posts older than #713 · Back to latest

Older Posts 13 shown
Post #712 2.1K
Я думаю многие знакомы с pmr, который формально был добавлен в C++17, а на практике в libc++ нет поддержки до сих пор.
Если не считать этого фатального недостатка, то в целом pmr может быть иногда довольно полезен.

monotonic_buffer_resource же при этом абсолютно бесполезен на уровне дизайна.
Идейно кажется довольно удобной абстракцией -- непрерывная память, которая запинена.
Реализация представляет из себя связный список блоков, размер блоков растет экспоненциально.

Но может ли кто-то объяснить почему у нее нет методов:
1) clear -- отпустить все блоки кроме последнего, для последнего считать, что он пустой
2) current_block_size/next_block_size/size, хотя бы что-то

Необходимость первого метода довольно очевидна, так же как наличие такого метода для вектора.
Необходимость же второго обусловлена тем, что иногда хочется освободить всю память (в отличие от clear), но при этом при следующем использовании начать сразу с нужного размера. И это как раз возможно, конструктор от размера есть у этого ресурса, а вот его размер нужно трекать снаружи почему то :(

Пример для clear:
... our_resource;
vector<T1> v1({our_resource});
use(v1);
v1 = {};
our_resource.clear()
vector<T2> v2({our_resource});
use(v2);
  • 👍 6
Post #711 1.92K
Loser story Вообще как бы вы решали задачу k-way merge (есть k отсортированных input, нужно получить 1 отсортированный output)? Я бы встретив такое на собесе решил бы через кучу, и с асимптотической точки зрения лучше нельзя. Но с практической можно делать меньшее (в…
В общем недавно появилось время и я доделал дерево вместо кучи,
померял и даже на простом компараторе получил ускорение на 15%.

Ещё недавно пофиксил оптимизировал довольно забавный кейс:
Дана сортированная по возрастанию последовательность уникальных чисел.
Затем по ней много ищут.
Есть две особенности:
1. В последовательности множество dense подотрезков, как правило с длиной больше 1.
2. Если все искомые числа выписать в одну последовательность, то это будет последовательность сортированных подотрезков, как правило с длиной больше 1.

Понятно что baseline здесь это обычный бинпоиск.
Но мы могли бы сохранить найденную позицию в массив.
Тогда при следующем поиске, нужно вычислить разницу между значением, которое было на этой позиции и искомым числом.
После прибавить эту разницу к прошлой позиции.
Затем проверить, что мы не вышли за пределы массива и это действительно искомый элемент.
В случае если между текущим искомым числом и прошлым был dense диапазон, мы нашли новое число.
А если не получилось все ещё можно использовать обычный бинпоиск.

Я не особо усердно бенчмаркал, так как это очевидно лучше, но даже на достаточно маленьких массивах (1e5) вышло в 2-4 раза быстрее.
GitHub Use tree instead of heap for k-way merge by MBkkt · Pull Request #530 · iresearch-toolkit/iresearch Motivation Segment tree (tournament tree) always makes at most log_2(size) count of comparison. Pessimistic heap (our previous approach) makes X count of comparison: X = log_2(size + 1) - 1 when i...
  • 👍 8
  • 👎 3
Post #709 4.53K
Не конструктивный пост, для меня C++ лучший выбор для разработки чем Rust, да у него есть очевидные преимущества над C++, впрочем верно и обратное.

Сейчас я не буду перечислять все, а расскажу об одном из наиболее важных для меня недостатков, который декларируется как преимущество, это cargo и система пакетов.
В вакууме она безусловно лучше того, что предоставляет C++ (кривые поделия, отсутствие стандарта => большинство зависимостей собирается из сорцов).

К сожалению на практике это приводит к неприятной мне экосистеме, где даже у простейших библиотек кучи зависимостей, и к тому что код библиотеки/проекта сложнее "просмотреть".

Качество кода и глубина зависимостей становятся куда менее однородными, чем при подходе сборки из сорцов.
Есть статья которая в целом отражает мое отношение к зависимостям:
https://research.swtch.com/deps

Безусловно я не считаю что все нужно писать с нуля, буквально первое, что я делаю с идеей, это ищу код который её реализует.
К сожалению часто даже найдя такой код, использовать его не является разумным.
В случае же с пакетными менеджерами, люди редко смотрят на что-то кроме наличие нужного API и количества установок.

Впрочем в си на мой взгляд есть противоположная проблема, когда библиотеки практически не используются (кроме domain specific: сжатие, криптография, етс), а в стандартной библиотеке отсутствуют контейнеры, как следствие все реализуется по 10 раз, а дефолтная структура данных для си это список (из-за своей простоты).

Резюмируя, у каждого из подходов есть свои недостатки, но контролировать, что в твоём проекте нет лишних велосипедов, сильно легче на мой взгляд, чем контролировать что все зависимости не зависят от чего то зря (да и что делать в таком случае не очень ясно).
  • 👍 20
  • 👎 7
Post #708 2.17K
Вообще как бы вы решали задачу k-way merge (есть k отсортированных input, нужно получить 1 отсортированный output)?

Я бы встретив такое на собесе решил бы через кучу, и с асимптотической точки зрения лучше нельзя.

Но с практической можно делать меньшее (в константу раз) число сравнений.
Вчера я вспомнил, что хотел померить это в arangosearch.

Ну и в общем в чем же идея?
Давайте сначала вспомним, что будет происходить в случае кучи:
Каждый раз доставая элемент нужно сделать sift down обновленной вершины:
Это в свою очередь спуск вниз на глубину log(k), к сожалению на каждом спуске нам ещё нужно проверять спускаться в левое или в правое под дерево, то есть в итоге мы получим не больше 2 * log(k)
(в плюсах и многих других языках из коробки ещё хуже, так как decrease key отсутствует, нужно сделать pop + push, что уже до 3 логарифмов, +1 потому что push это sift up, который требует не более логарифма сравнений)

Почему такое вообще происходит?
Потому что с точки зрения дерева минимумов оно у нас встроенное в сами данные, и поддерживать такую структуру немного сложнее.

Поэтому вместо этого можно поддержать дерево явно, по сути сделав дерево отрезков минимумов, такой подход называют tournament tree, и он даст ровно log сравнений

Cегодня я набросал код и вероятно завтра напишу микробенчмарки, потом еще посмотрю на перф в аранге:
https://github.com/iresearch-toolkit/iresearch/pull/476

В целом весьма очевидно что мы выигрываем, есть ли минусы? В сравнение с pop + push подходом нет, в сравнении с sift_down к сожалению да.

Главная проблема что в случае дерева нам нужно поднимать новое значение снизу, то есть логарифм сравнений мы делаем всегда.
В случае же с кучей мы опускаем значение среди других значений и если нам повезло и input-ы не пересекаются мы на каждый push в output будем делать только 2 сравнения (кроме тех где input закончился).

Резюмируя для [0;4-8] инпутов tournament tree однозначно лучший подход, относительно числа сравнений.

А дальше это зависит от данных. Если данные рандомные то все еще лучший. А вот если по какой-то причине у вас очень мало переключений инпутов или вообще disjoint диапазоны, то вероятно ручной sift down покажет себя оптимальнее :(

Можно ли что-то с этим сделать?
Наверно нет, только страдать, впрочем еще мне нравится подход с деревом тем, что это всегда фиксированное число сравнений, их число не зависит от того как именно output данные расположены в input-ах
GitHub Benchmark comparison count: tournament tree vs binary heap by MBkkt · Pull Request #476 · iresearch-toolkit/iresearch IResearch is a cross-platform, high-performance document oriented search engine library written entirely in C++ with the focus on a pluggability of different ranking/similarity models - Benchmark comparison count: tournament tree vs binary heap by MBkkt ·…
  • 👍 7
  • 👎 1
Post #707 1.68K
Давно не писал, чем я вообще занимаюсь

Читаю книжки:
1. https://nlp.stanford.edu/IR-book/information-retrieval-book.html — про идеи и алгоритмы, которые стоят за поиском.
В целом, я многое уже знал по работе, но мне нравится, то что структурирует мои знания и в целом более теоретический взгляд.
Ещё в очередной раз убедился насколько книжки с упражнениями лучше, чем книжки без них, единственный минус, в отличии от perfbook, здесь нет ответов, чтобы проверить себя (остается, либо доказывать, либо гуглить, если не уверен).

2. https://ciir.cs.umass.edu/irbook
По сути тоже самое, но якобы более практическое (из прикольного к книжке есть жаба код учебного поискового движка http://www.search-engines-book.com), по факту мне показалась более поверхностной и менее интересной.

Вообще на работе сейчас занимаюсь ускорением geo поиска, так как он работает у нас на s2, у меня периодически горит с них жопа.
Например, сделал оптимизацию для случая, когда кверить будут только точки и заодно улучшил интерфейс, чтобы не нужно было делать аллокацию на каждый вызов, PR до сих пор висит https://github.com/google/s2geometry/pull/303, потому что гугловый чел не оценил моего расширения интерфейса. Надеюсь его не сократят, а то не знаю сколько ещё ждать ответа.

В целом мне кажется историю, которая у нас сейчас: храним термы для кверинга в инвертед индексе, а потом вычисляем точную операцию, можно делать принципиально лучше, проблема в том что s2 почти не развивается, а нужно, чтобы их индекс умел в выдачу конкретных фигур в intersects/contains не только для поиска точек, но и полилиний и полигонов, вроде как они планируют это сделать, но когда — хрен его знает :(
GitHub Term indexer improvements by MBkkt · Pull Request #303 · google/s2geometry First is caps Second is points Third is points with query only points As we see index contains a lot of smaller count of terms, which is very good Of course this optimization possible only if you q...
  • 👍 12
  • 👎 1
Post #706 1.57K

Forwarded from Arelav

https://quick-lint-js.com/blog/cpp-vs-rust-build-times/
Оно конечно немного стрёмно, в духе сравнения apple clang 14 (что примерно соответствует 12-13 llvm clang) и llvm clang 15
Но любопытно и впечатляет насколько много бесполезного было сделано
Quick-Lint-Js Is coding in Rust as bad as in C++? A practical comparison of build and test speed between C++ and Rust.
  • 👍 1
Post #705 1.66K
Всех с наступающим/наступившим новым годом!
В общем надеюсь что новый год будет лучше чем этот для всех нас.

Кстати YACLib добавили в conan!
https://github.com/conan-io/conan-center-index/pull/14006
GitHub Added yaclib by TheSalvator · Pull Request #14006 · conan-io/conan-center-index Specify library name and version: yaclib/1.0.0 #14005 I've read the guidelines for contributing. I've followed the PEP8 style guides for Python code in the recipes. I've used the ...
  • 👍 21
Post #704 3.72K
Вы наверно знаете, что такое конечные автоматы.
Но возможно, как и я до недавнего времени, не слышали об FST.

По сути это тоже конечный автомат, где переход помимо входной метки содержит выходную (она может быть из другого алфавита), плюс можно добавить вес (которому нужно быть элементом полукольца только если вам нужны все свойства и алгоритмы).
Почему у этого есть отдельное название? Вероятно потому что для fst придумали алгоритмы минимизации, конкатенации и тд, которые сохраняли бы получившуюся структуру.
В целом теория неплохо описана в статье.

Еще эта структура данных примечательна тем, что имеет полезные применения:
- Используется для хранения словаря термов (и не только) в lucene и других поисковых движках. Кстати в качестве полукольца веса может быть и строка
- В распознавании речи в kaldi, статья довольно подробно описывает зачем, только учитывайте, что за исключением части раздела 2 и раздела 4 это по большей части повторение первой статьи.

Как я думаю следствием этого является наличие вменяемых имплементаций.
Например гугловая библиотека C++ OpenFST, ее используют kaldi и например мы в ArangoDB.

Поэтому если вам нужна библиотека обычных конечных автоматов (к сожалению я не встречал нормальных, в основном про fsm в компайл тайме для функций) можно использовать FST.
Например я недавно использовал для поиска наибольшего общего префикса.

Но зачем вообще в ArangoDB OpenFST? Мы используем ее в https://github.com/iresearch-toolkit/iresearch (аналог lucene), правда с некоторыми патчами.
Поставьте нам в iresearch звездочку кстати!

К сожалению OpenFST не без недостатков, что неудивительно учитывая что либа была написана еще в 2000-ых:
- bazel/make как система сборки, это типичный недостаток гугловых/старых либ, но это не большая проблема, можно написать свой простенький cmake для нужного вам (есть в iresearch)
2. То что это все живет не на условном github/gitlab/etc, хз принимают ли они патчи например, ну и в целом мне кажется это сказывается на активности разработки.
3. В либе много довольно странного API, который стоило бы задеприкейтить.
В целом ощущение что оно почти не развивается

Если же говорить про другие библиотеки fst, я видел несколько любопытных на rust:
- Попытка переписать openfst
- Реализация fst на rust, которая используется в tantivy
Собственно имплементация в lucene
Вроде бы еще что-то есть на java но я не интересовался

Еще постараюсь до нг написать про fault-injection немного и геометрию
Wikipedia Finite-state transducer finite-state machine with two tapes (input, output)
  • 👍 12
Post #703 1.61K
https://youtu.be/ugw0lQoATB4
Мне тут ютуб порекомендовал любопытный доклад про различные заброшенные опенсурс субд.
Кстати про несколько систем из списка слышал, но вообще довольно грустно

В целом как-то не было особо времени/желания писать посты, на работе как то загружено, а остальное время занимался яклибом.
Между прочим я уже скоро два месяца как в Кельне, и в общем мне тут нравится.
Мои опасения по поводу отсутствия разнообразия в местной кухне не оправдались, а работать из офиса намного лучше ;)
  • 👍 12
  • 👎 1
Post #702 1.71K
В общем я не специалист по написанию sql/etc запросов, хоть и пишу бд.

Сейчас узнал (из issue) про забавный хак: ORDER BY RAND() LIMIT N. Собственно идея в том чтобы получить N случайных записей из таблицы (зачем нужно уже это без понятия, но прикольно).
  • 👍 10
Post #701 1.96K
Post #692 2.04K
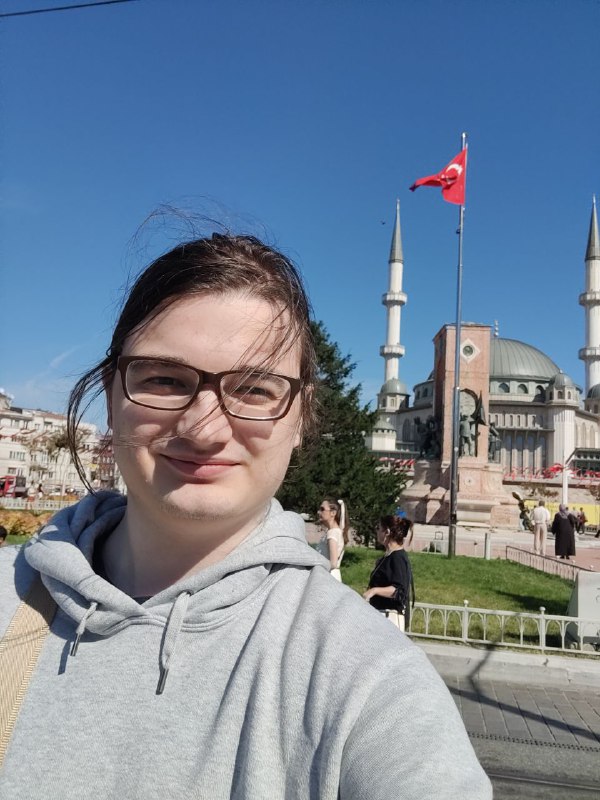
А ещё я побывал в Стамбуле!
Уже улетаю, но мне понравилось, красиво, погода была хорошей, не слишком жаркой, еда вкусная.
Думаю когда-нибудь приеду сюда еще
  • 👍 15
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →