TGViewer
Channel Public Channel
Пристанище Дата Сайентиста

Пристанище Дата Сайентиста

@renat_alimbekov

Строю AI-стартап в публичном режиме.
Tech stack, продуктовые решения, метрики, ошибки.

Для DS/ML-инженеров, которые:
- Хотят понять бизнес-сторону AI
- Думают о своем продукте
- Работают в стартапах

Автор: Ренат Алимбеков
Веду блог https://alimbekov.com
Subscribers
6.34K
Photos
43
Videos
0
Links
226
Recent Posts 16 shown
Post #561 563
​​Команда DevCrowd запустила ежегодное исследование специалистов по работе с данными

В этом году фокус на том, как меняется профессия: что AI реально сделал с составом работы, где проходят границы между дата-сайентистом, ML- и MLOps-инженером, что происходит с порогом входа в профессию и рынком труда.

Часть вопросов задается третий год подряд, что дает реальную динамику, а не просто срез.

Опрос анонимный, 12–15 минут. В ноябре ребята опубликуют отчет со всеми данными, а также списками рекомендованных телеграм-каналов и курсов, собранными из ответов участников.

Пройти опрос: https://survey.devcrowd.ru/data-2026

DevCrowd — это независимые исследования IT-профессий: 15 000+ участников, публичные отчеты по Golang, SRE , мобильным разработчикам и другим направлениям.
  • ❤ 3
  • 🔥 2
  • 👍 1
Post #559 2.17K
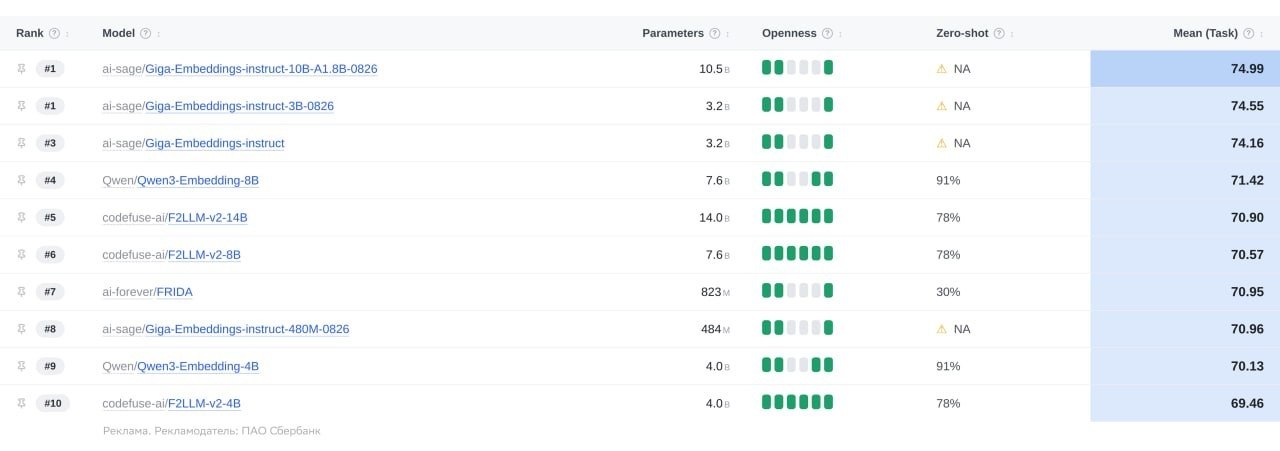
​​Разработчики GigaChat выложили в open source обновлённую линейку GigaEmbeddings - от компактной модели 480M для высоконагруженного поиска и рабочего стандарта 3B до нового MoE-флагмана 10B-A1.8B.

Главное в релизе:

GigaEmbeddings 10B-A1.8B - новый флагман и топ-1 в ruMTEB
• Большой прирост качества на английском и особенно в задачах с кодом
• Поддержка vLLM и SGLang
• Три размера модели под разные требования к скорости и качеству
• Более быстрый батчевый инференс

GigaEmbeddings 10B-A1.8B - MoE-модель с 10B общих и всего 1.8B активных параметров. Она превосходит новую 3B по качеству на всех бенчмарках и при этом быстрее неё на батчевом инференсе.

На vLLM флагман в 1,44–1,61 раза быстрее Qwen3 Embedding 4B. На последовательностях длиной 512 преимущество достигает 61%: 112,6k против 70,1k токенов/с.

Результаты

Главный прирост - в задачах с кодом: новая 3B набирает 76,93 против 62,37 у прошлого релиза, а флагманская 10B-A1.8B - 78,40. На русском флагман достигает 74,99 и занимает первое место в ruMTEB.

Что изменили в обучении

В несколько раз увеличили объём данных на этапах contrastive pretrain и fine-tuning, в том числе за счёт открытых датасетов Nemotron, F2LLM и KALM.

Чтобы улучшение английского и кода не привело к просадке на русском, использовали мержинг моделей с помощью SLERP. Он помог сохранить баланс между языками и классами задач.

Компактную GigaEmbeddings 480M дополнительно обучили с помощью дистилляции от топовых моделей: передавали распределения cosine similarity внутри батча через KL divergence.

В результате новая линейка стала качественнее, быстрее и удобнее для production. Все модели доступны в open source.

HF: 480M 3B 10B-A1.8B
  • 👍 4
  • ❤ 3
  • 🤣 3
  • 🔥 1
Post #558 1.13K
Горд своими студентами, успейте подать заявку на грант
  • 👍 6
  • ❤ 4
  • 🔥 2
Post #557 1.06K

Forwarded from Datanomix Academy

🚀 От обучения к собственному AI-продукту: история Ислама Исеноманова

Ислам Исеноманов прошёл программу «AI Product Manager: запуск AI и ML продуктов от идеи до метрик» и в результате обучения разработал собственный продукт.

На курсе Ислам глубже познакомился с тем, как развивать стартап, какая инфраструктура ему необходима и с какими рисками можно столкнуться.
Полученные знания он применил на практике — разработал AI-продукт для родителей особенных детей — Autenok.kz.

💬 Ислам об обучении:
«Благодаря данному курсу поближе познакомился с тем, как развивать стартап, какая инфраструктура для него нужна и какие есть риски. Соответственно, благодаря курсу и разработал продукт».

Одним из важных факторов для Ислама стала возможность поступить на обучение по гранту.

А будущим участникам он даёт простой совет:
💬
«Нет ничего невозможного, главное — уметь думать, а дальше обучающие школы научат тебя это реализовать».


👉 Подать заявку на обучение: https://astanahub.com/ru/techorda/course/805/

#историяуспеха
  • ❤ 4
  • 🔥 3
  • 👏 2
Post #555 1.06K
Как мы провели лето: 500 пул-реквестов за полтора месяца

Про раунд и пивот уже написал Дима, повторяться не буду. Напишу про то, что в этой истории зацепило меня как инженера.

В июле мы начали новый продукт с пустого репозитория. 5 августа защищали прототип перед лид-инвестором. Дизайн и код делали параллельно, поэтому показывали навайбкоженный интерфейс - и он отработал целиком, и со стороны бренда, и со стороны креатора.

Между этими двумя точками уехало около 500 PR 🤘
И вот что я понял примерно на третьей неделе. Код перестал быть узким местом. А процесс вокруг кода остался ровно таким же, каким был.

Ревью. При таком темпе никто не читает каждую строку. Неделю можно делать вид, что читаешь. Потом очередь скажет правду: или ревью превращается в штамп с увеличенным сроком ожидания, или в него всё упирается и скорость, за которую ты заплатил, тихо испаряется.

Построчное ревью было настоящим контролем, пока каждую строку писал человек. На нашем объёме это ритуал. Мне проще это признать, чем продолжать его изображать.

Что поменяли:
Ничего не реализуется, пока инженер не принял план текстом. Поспорить об архитектуре в документе стоит десять минут. Поспорить о ней на ревью готовой ветки - день.

Каждый этап оставляет после себя файл, который читает следующий. Интент, спека, план, потом диф и заметки ревью. История коммитов сама стала аудит-трейлом, специально его никто не строил.

Стандарты переехали туда, где пишется код. Конвенции агент читает на старте сессии, а под то, что не должно ломаться никогда, кладём хук, который просто блокирует действие. Инструкция делает нарушение редким, хук - почти невозможным.

И правило, которое я пока ни разу не нарушил: агент делает всё до продакшн-гейта и ни шагу дальше.

500 PR оказались лёгкой частью, если честно. Тяжёлая - процесс, который должен за ними успевать.
У кого этим летом было похожее? Интересно, что ломалось первым.
  • 👍 6
  • 🔥 4
  • 👏 2
  • ❤ 1
Post #554
Пристанище Дата Сайентиста pinned «​​Открылся приём заявок на Tech Orda 2026 Один из курсов там веду я - "AI Product Manager: запуск AI и ML продуктов от идеи до метрик" в Datanomix Academy Заявки принимают с 7 августа по 7 сентября. Про что курс. Не про то, как устроен трансформер. Про…»
Post #553 2.24K
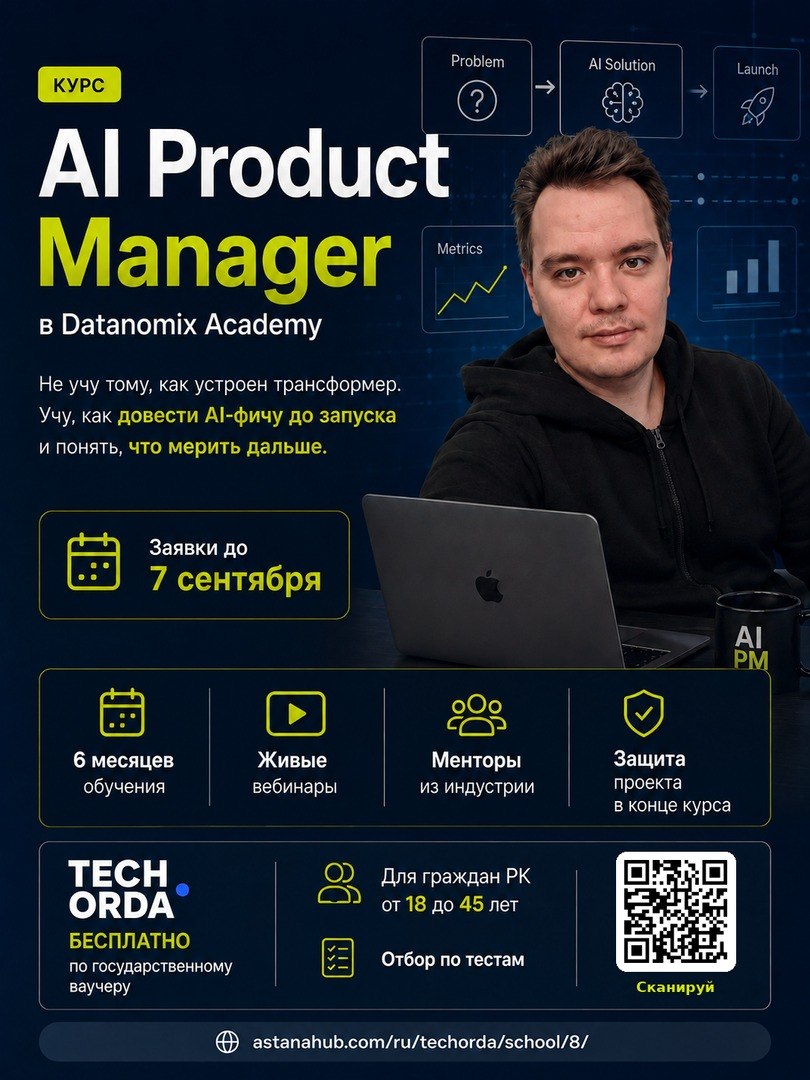
​​Открылся приём заявок на Tech Orda 2026

Один из курсов там веду я - "AI Product Manager: запуск AI и ML продуктов от идеи до метрик" в Datanomix Academy

Заявки принимают с 7 августа по 7 сентября.

Про что курс. Не про то, как устроен трансформер. Про то, как довести ML-фичу до продакшена и не остаться с моделью, которая красиво считает метрику на валидации, а в проде не нужна никому

Выбор задачи, работа с данными, оценка качества, стоимость инференса, что мерить после релиза.

6 месяцев, живые вебинары, менторы, в конце - защита проекта. Обучение бесплатное, стоимость покрывает государственный ваучер.

Условия простые: гражданство РК, возраст от 18 до 45.

Мест мало, зачисление по результатам отборочных тестов. Если сомневаешься - лучше не тянуть до последней недели.

Про курс: https://astanahub.com/ru/techorda/course/805/
Заявка: https://astanahub.com/ru/techorda/school/8/

Вопросы по отбору - координатору @DubovayaTany
  • 👍 6
  • ❤ 4
  • 🔥 3
  • 🥰 1
Post #551 1.89K
​​Я сейчас очень много изучаю виральность в сроздании продуктов и не могу не поделиться интересным кейсом

Один японец собрал игру за два месяца. Ноль рекламы. Меньше чем за месяц 15 миллионов проданных копий 
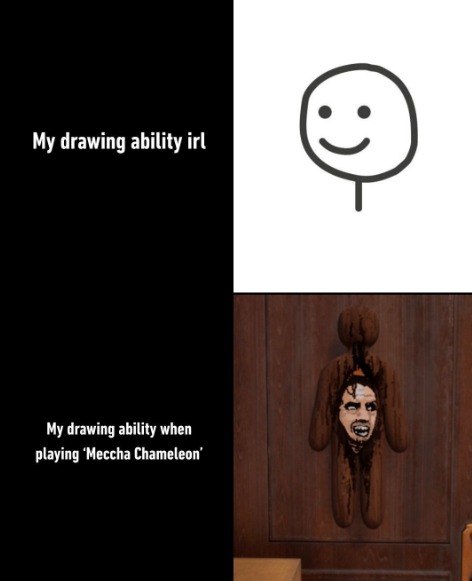
Игра называется Meccha Chameleon. Прятки в которой ты красишь своего персонажа под фон и прячешься, кто-то ищет. Цена игры 5.99 доллара. Ни издателя, ни рекламного бюджета.

За неполный месяц она обошла Apex Legends, Forza Horizon 6 и Resident Evil Requiem. Пик 340 тысяч человек онлайн одновременно, 44-е место за всю историю Steam.
Секрет не в игре. Секрет в том, что игра сама производит контент.

Кто-то намазал персонажа коричневым и встал у синей стены. Его находят. Момент нелепого провала маскировки готовый клип, смешной сам по себе, без монтажа и объяснений. Ты играешь и в ту же секунду снимаешь за разработчика рекламу. Никому за это видео не заплатили.

Теперь то, как это связать с созданием продуктов B2C

Когда вы придумываете фичу, первый вопрос не полезно ли это. Первый вопрос: поймёт ли незнакомый человек за 10 секунд, в чём тут прикол, без всякого контекста. Если на объяснение нужна минута, на короткие видео это не выйдет никогда. А большинство команд идут ровно не туда: докидывают фичи. Каждая новая ещё одна штука, которую пользователю надо сначала понять.

Переверните в голове: механика продукта и есть онбординг.

Новая фича = новый формат контента = новый юзкейс = новый сегмент аудитории, до которого вы раньше не дотягивались.

Но помните виральность даёт всплеск. Удержание она не даёт. Если продукт не держит тех, кого притянул, отток будет огомным, и от всплеска через неделю ничего не останется. Это канал привлечения, а не бизнес-модель.

Так что стройте продукт так, чтобы само его использование создавало повод о нём рассказать. А потом сделайте так, чтобы к нему хотелось вернуться
  • ❤ 10
  • 👍 5
  • 🔥 5
  • ❤‍🔥 1
Post #550 1.93K
AI-Performance-Playbook.pdf1.2 MB
Как AI-агенты уже управляют перфомансом с бюджетами в миллионы $

Разобрал кейс EdTech-компании (рынок США, средний чек $6 000) команда передала AI-агенту принятие решений по рекламным кампаниям

По моим наблюдениям, управление перфомансом проходит 3 фазы:

- ФАЗА 1 Ручной режим. Менеджер открывает отчёты (или забывает), держит KPI в голове, сравнивает цифры глазами. Решения на 5 покупках: пять это же не ноль, скейлим!

- ФАЗА 2 Дашборды и правила. Данные есть, отчёты есть. Но кампаний 20+, в каждой по 5+ креативов проверять всё каждый день физически невозможно. Новая метрика в отчёте = задача аналитикам в бэклог на недели.

- ФАЗА 3 - мы здесь
AI-агент подключен к DWH и каждый день сам сравнивает факт с KPI по всей воронке: lead → deal → AI-звонок → MQL → покупка.

Сам считает прогноз CAC и ранжирует ассеты: скейлим / оптимизируем / стоп. Решения только при 30+ конверсиях (при 10 шанс ошибки ~50%, проверено)

Находит креативы-виннеры и выгоревшие хиты для релонча лучшие перезапускают до 30 раз.

Действия прямо из чата: остановить креатив, поднять бюджет, задублировать ассет. Проверенные сценарии уже крутятся в полном авто.

Главный сдвиг: 80% работы UA-менеджера сравнить две цифры и передвинуть бюджет. Для этого люди больше не нужны. Люди нужны для трендов, гипотез и креативной стратегии

Собрал весь фреймворк в PDF AI Performance Playbook: воронка и KPI, 6 скиллов агента, чек-лист готовности к автопилоту и 10 шагов внедрения
  • 🔥 9
  • 👍 4
  • ❤ 1
Post #549 2.71K
​​12 493 место в мире

Так закончился мой сезон в Fantasy Premier League из примерно 11 миллионов игроков. Это топ-0.1%.

Дошёл я туда не потому, что стал больше смотреть футбол. А потому что год назад собрал Telegram-бота, который принимает за меня решения по трансферам.

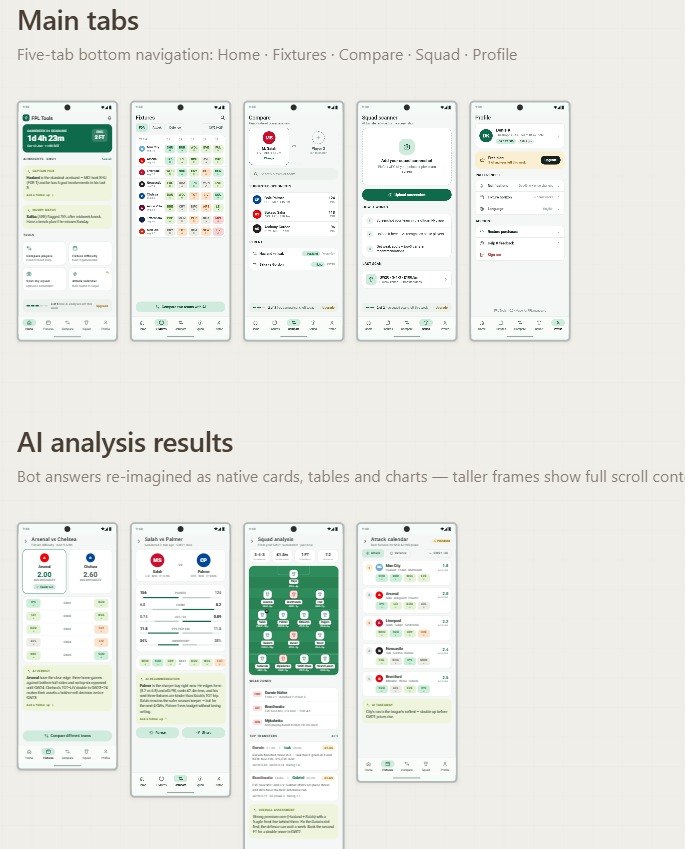
Я перестал гадать и начал читать цифры. Но у бота в чате есть одна слабость формат. Нормальный разбор календаря это таблица, а не три абзаца текста, в которые ты щуришься с телефона.

Поэтому переделываю бота в мобильное приложение. Тот же движок, другая оболочка. Каждый ответ AI теперь рисуется как нативная карточка, таблица сравнения или график то, что считываешь за пару секунд. Пять вкладок: Home, Fixtures, Compare, Squad, Profile. И сценарий, где ты кидаешь скриншот своего состава и получаешь пять конкретных идей по трансферам.

Делаю это в режиме build in public. Буду показывать и то, что получилось, и то, что пока не получается сделать.

Играете в FPL? Напишите в комментах соберу список на ранний доступ.
  • 👍 11
  • 🔥 5
  • ❤ 4
Post #548 2.15K
Еще немного инсайтов с конференции по B2B SAAS проектам о том как искать идеи для своих проектов

Если вы так же как я и хотите сделать свой проект то обязательно прочтите заметку

Есть два открытых сервиса: acquire.com и Trust MRR. На первом фаундеры продают свои SaaS с проверкой через Stripe и инвойсы. 
На втором фаундеры подключают Stripe и показывают свой MRR в реальном времени.

Это сотни работающих компаний с настоящими  цифрами. От $5K до $3M в месяц

Просто заходишь и листаешь и выбираешь что тебе по душе

Несколько штук, которые я выписал, пока листал:

- AI-бот для стоматологов, букает встречи: $9K/мес
- LinkedIn-комментатор от вашего имени: $13K/мес, прибыль 80%
- Динамический прайсинг для отелей: 250+ клиентов
- Тулза для рерайтинга контента: $70K/мес

Что я заметил, когда насмотрелся:

Деньги делают не AI-агенты для всего, а vertical SaaS под конкретную профессию. 

И ещё один сдвиг в голове, который я для себя поймал: идеи не придумывают. Их находят.

Брейнсторм работает плохо, потому что вы оптимизируете на интересно ли мне, а не на кто за это платит. А когда смотришь на чужие цифры оптимизируешь сразу на второе.
Buy & Sell Profitable Online Businesses | Acquire.com Buy or sell a profitable online business in as little as 90 days. 500k+ qualified buyers, 1,000s of vetted listings. M&A advisory, legal help, escrow, & more.
  • 👍 8
  • ❤ 5
  • ❤‍🔥 3
Post #547 2.27K
Самая дорогая ошибка в B2B-маркетинге - это вера в один волшебный канал

Продолжаю разбирать материалы с конференции по B2B SAAS проектам

Реальный кейс из доклада B2B-маркетинг FitMost. Команда собрала максимально чистую базу:

→ только релевантные роли HR
→ только платёжеспособные отрасли (IT, рестораны, ритейл)
→ отфильтровали info@ и общие домены
→ 25 000 проверенных контактов

Запустили холодный outreach.

Получили 1 заявку.

———

Что тогда работает в российском B2B?

Воронка из 20 касаний, разбитая на 3 этапа:

Рукопожатие (60% лидов)
Конференции + автоматизированный розыгрыш за контакт. Вебинары на широкие темы (не корпоративный спорт, а мотивация сотрудников). Партнёрства только с одинаковой ЦА

Объятия (30% лидов)
Telegram-канал с балансом полезного и продающего. Двухнедельный email-онбординг. ABM по сегментам — кейс с IT дал 3 клиента из одной аудитории за 3 месяца

Сделка (10%)
Селзы + закрытое комьюнити амбассадоров, которые продают за вас своим коллегам

———

Три практических вывода:

→ Атрибуция по компаниям, не по контактам. Считайте 5+ касаний с компанией, потом передавайте селзам

→ Маленький бюджет — это место для креатива. FitMost начинал с прямых эфиров в Telegram. Партнёрки с такими же небольшими ребятами дают непропорциональный результат

→ Связка «маркетинг ↔ селзы» — с первого дня. Селз должен оставлять комментарий к каждому контакту с конференции. Без этого аналитика мертва

И главное: B2B — это марафон, не спринт. Закладывайте в финмодель время на 20 касаний

Подробный разбор в карусели на @alimbekovkz в Instagram.
  • 🔥 3
  • ❤ 1
  • 👍 1
Post #546 2.43K
2 недели разработки. Команда деплоит фичу с LLM. Опа - accuracy 40%, стоимость в 10 раз выше плана, edge cases вылезают на проде.

Знакомо?

Я наблюдаю это в каждой второй команде, которая внедряет AI. Гипотеза не подтверждается, но узнают они об этом уже после спринта.

При этом для проверки достаточно одного дня.

Фреймворк, который я даю своим студентам в Datanomix Academy - Prompt-First Prototyping. Идея простая: До того, как программисты напишут хоть строчку кода, продакт сам проверяет AI-гипотезу промптом в ChatGPT или Claude.

Звучит банально? Большинство пропускают этот шаг.

4 шага занимают день:

1. Сформулировать гипотезу. GPT-4o-mini категоризирует 80%+ тикетов поддержки по 5 типам

2. Написать промпт-прототип. System prompt + 3 few-shot примера + JSON-формат на выходе. Полчаса работы.

3. Прогнать вручную на 10–20 кейсах. Записать accuracy, edge cases, время ответа, стоимость.

4. Принять решение по карточке оценки. Accuracy ≥ 80% - Go. 50–70% - Iterate. Меньше 50% - Pivot, гипотеза не работает.

Карточка оценки, которой я пользуюсь сам - 5 критериев: Accuracy, Consistency формата, Edge Cases, Latency Feel и Cost Estimate. Каждый имеет порог Go.

Реальный кейс из моей практики: задача - категоризация тикетов поддержки. Гипотеза подтвердилась за 4 часа: 9 из 10 тикетов размечены верно, JSON стабильный, $0.15 на 1000 запросов через mini-модель. На один тикет с двумя темами - добавили secondary_category. Решение - Go, кодим.

Мог бы команда положить 2 недели и потом узнать то же самое? Конечно. Но зачем?

Главный принцип, который я повторяю продактам:
один день на промпт-прототип экономит две недели разработки провальной фичи.
  • 🔥 19
  • 👍 5
  • ❤ 4
Post #545 2.1K
​​3,5 миллиарда превратились в 11 миллионов. И никто не виноват

Посмотрел на досуге много материалов с конференции по B2B SAAS проектам и принес вам много материала

Начнем про оценку B2B-рынка. И там был кейс, который меня прибил.

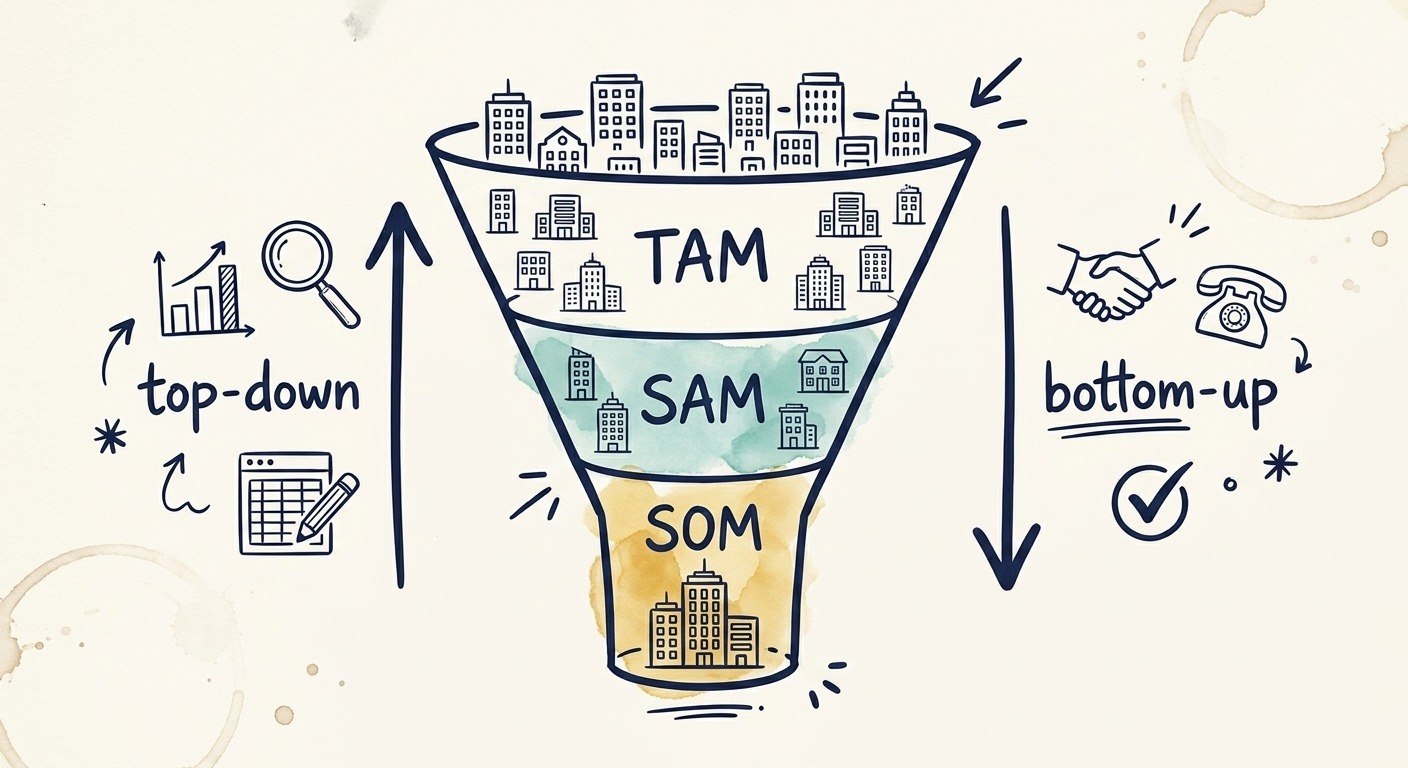
Команда из HR-теха посчитала рынок автоматизации массового подбора. Сверху вниз, по учебнику: 780 000 компаний с вакансиями × 20% автоматизируют × 3% доля рынка = 3,5 млрд ₽ потенциала.

Красивая цифра. Под неё можно поднять раунд. Потом они пошли продавать.

Оказалось, что подбором массово занимаются только компании от 200 человек. Из них постоянно нанимают 5+ людей в месяц ~1 100 компаний. Из них готовы платить 75.

Реальный потенциал - 11,3 млн ₽. Разница в 310 раз. Это ловушка, в которую попадают почти все, кто строит B2B. И вот что меня зацепило - её невозможно избежать только аналитикой.

Никакие отчёты, никакие AI-агенты, никакой Perplexity не дадут вам реальную цифру. Реальную цифру даёт только продажа
  • 👍 10
  • 🔥 6
  • ❤ 2
Post #544 2.15K
​​Когда то я организовывал эту конференцию, затем я на ней выступал, а в этом году я буду там на спид-менторинге и помогу с запросом по карьере.

Ребята держат высокий уровень организации и спикеров.

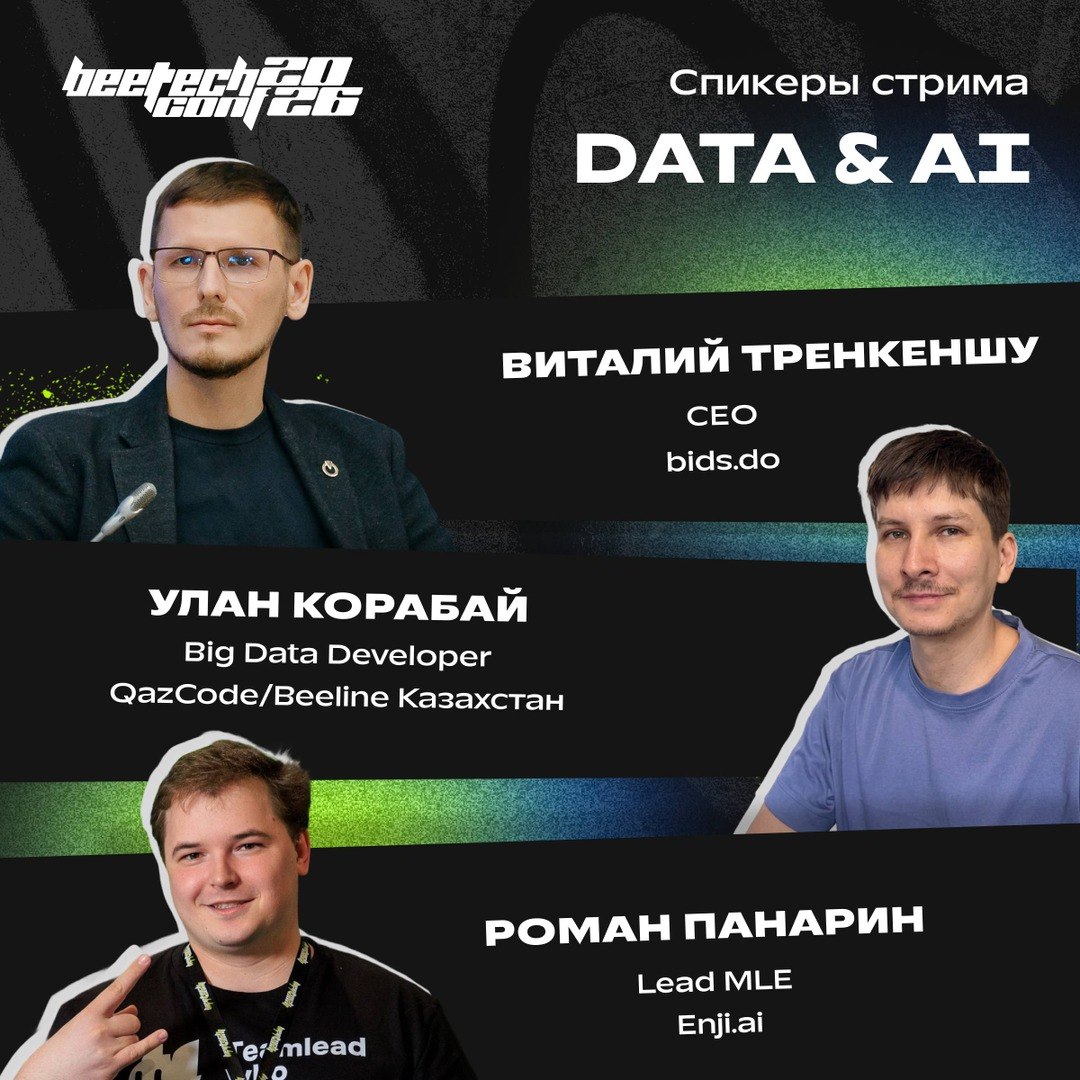
Билеты в стрим Data&AI на beetech conf уже в продаже и сейчас их можно купить за 12.150 тг через приложение Freedom SuperApp с кэшбеком

В программе - работа с данными в условиях недоверия между партнёрами, AI-пайплайны для обработки десятков тысяч лотов, переход от облачных к локальным LLM, ускорение стриминга до near real-time и кейсы на стыке AI и кибербезопасности.

Помимо меня там будут Илья Красинский, популярный в русскоязычном пространстве автор курсов по продакт-менеджменту, Арман Сулейменов из nfactorial и многие другие 

📍23 мая, Алматы
Узнать программу: beetech.kz
  • ❤ 6
  • 👍 3
  • 🔥 3
Post #537 1.73K
7 структурных сдвигов в digital-маркетинге 2026

Стратегический разбор для тех, кто строит рост, а не гонится за трендами

А еще я писал целых две заметки про GEO - Generative Engine Optimization:

Что такое Llms.txt? Структура llms.txt файла

Как llms.txt увеличил трафик с AI-чатов на 23%
  • 🔥 8
  • 👍 2
  • 👏 1
Older posts →

About this channel

How can I read @renat_alimbekov without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Пристанище Дата Сайентиста: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Пристанище Дата Сайентиста have?
Пристанище Дата Сайентиста (@renat_alimbekov) has 6.34K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Пристанище Дата Сайентиста know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →