TGViewer
Channel Public Channel
Raxys Studios

Raxys Studios

@raxysstudios

Made with honor in North Caucasus
https://raxys.app
Subscribers
669
Photos
120
Videos
14
Links
63

Showing posts older than #105 · Back to latest

Older Posts 16 shown
Post #104 430

Forwarded from Йорги

Бросить бы все и начать учить агульский
Post #102 434
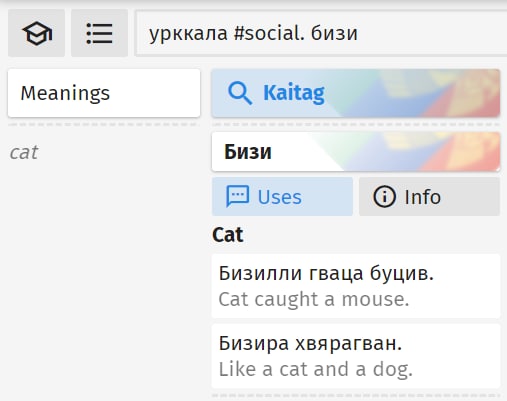
Разработка первой рабочей версии словаря постепенно подходит к концу. Ещё нужно доделать редактор и оптимизировать внутренние алгоритмы, но по пользовательскому функционалу — всё на месте.

Вкратце об интерфейсе:
— В самом верху строка ввода (1), где набирается поисковый запрос (о синтаксисе запросов было рассказано ранее). Там же левее есть кнопки переключения расширенного режима и избранных списков.
— Сразу под ними есть ряд кнопок, первая из которых это "meanings / list" (2). Если выбрана эта категория запроса, система будет искать среди смыслов по всем языкам.
— Продолжая всё тот же ряд, правее располагаются кнопки выбора языков (3). При выборе какого-либо языка, система будет искать сначала формы в этом языке, а затем смыслы всех найденных форм — в других языках.

Пока доступны лишь по 100 слов по каждому из 5 языков, но этого должно хватить, чтобы оценить взаимодействие с системой. По академическим причинам работа ведётся в отдельном репозитории, и в середине мая модуль будет перенесён на основной сайт. Желающие могут опробовать приложение по временной ссылке, а я буду рад любым замечаниям.
Post #101 411
Помимо свободного поиска, будет возможность просматривать заранее подготовленные наборы слов. Например, "основные цвета", "числа от 1 до 10", "основные понятия родства", и т.п.
Post #99 396
В словаре для каждого слова по умолчанию будет показана лишь основная информация — переводы, примеры, заметки, формы. Но можно будет включать расширенный режим, при котором будет также отображаться грамматическая разбивка форм и примеров, семантические и грамматические теги.
Post #96 361
Логика запросов также претерпевает улучшения.

— поиск по тегу: "#color" покажет "белый", "чёрный", "зелёный", ...
— поиск по началу формы или смысла: "+sleep" покажет "sleep", "sleepless", ...
— поиск по окончанию формы или смысла: "-one" покажет "one", "alone", "bone", ...
— поиск по точному совпадению формы или смысла: "!car" покажет только "car", а не "care" или "scar".
— поиск по вхождению в форму или смысл: "believ" покажет "believe", "believer", "unbelievable", ...

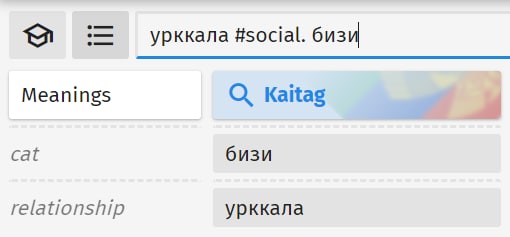
А ещё, можно будет объединять запросы, разграничивая их точкой. Например, "#color" будет означать "покажи все цвета", "уркка #social" — "покажи смыслы слова уркка, которые относятся к социальным явлениям", а "!one. !two. !three" — "или один, или два, или три", т.е. покажет все три слова.
Post #94 6.3K
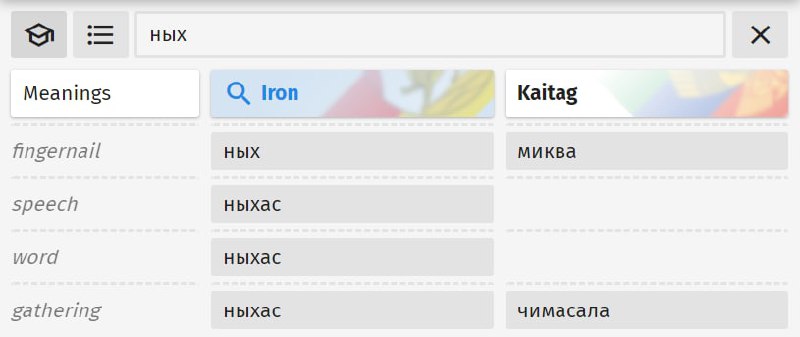
Слова группируются по смыслам. Если слово имеет несколько подходящих смыслов, то оно отображается под каждым из них. Если раскрыть слово на одном из его смыслов, то все дубликаты погаснут.

Так, при поиске иронской формы "ных", "ныхас" отобразилось под смыслами "речь", "слово", "собрание". При раскрытии "ныхас" в строке со смыслом "слово", остальные кнопки с этим словом погасли (но и на них тоже можно нажать), показывая, что все они - одно слово.
Post #93 344
Raxys Studios Что касается словарных единиц, то мне сейчас представляется следующая структура данных по каждому слову \ словосочетанию (на примере "кошки", где * - поисковое поле). — *значения: cat. — *словоформы (падежи, рода, числа): бизи, \bizi\, cat бизилли…
Строение словарной единицы.

У слова есть применения. Каждое использование состоит из значения и смысловых меток (1) (они определяют понятие), из заметок (2) (например, пояснение к значению и образцу), и из образцов (3) (примеры предложений или словосочетаний).

У слова так же есть грамматические метки (4), заметки (5) (например, этимология, родственные слова), и грамматические формы (6) (склонения, спряжения, множественное чисто, и т.п.).
Post #92 368
Кому интересно, могут уже сейчас поиграть на сайте с разделом словарей, чтобы понять, что получается. Это первый наивный прототип, который я показывал на конференции. Там около 200 слов по Кайтагскому, Кюринскому, Керенскому, Иронскому. Выбирайте хоть все 4 языка разом, и тыкайте в кнопки. Формат взаимодействия со словарём, в целом, по окончанию забега не изменится. Работа в этом забеге (до середины мая) ведётся над технической частью — поддержка больших объёмов данных, улучшенный поиск, и т.д.
Post #91 357
Что касается словарных единиц, то мне сейчас представляется следующая структура данных по каждому слову \ словосочетанию (на примере "кошки", где * - поисковое поле).
— *значения: cat.
— *словоформы (падежи, рода, числа):
бизи, \bizi\, cat
бизилли, \bizi-lli\, cat-ERG
бизий, \bizi-j\, cat-DAT ...
— примеры употребления:
бизилли гваца буцив, \bizi-lli gʷɑt͡sɑ b-ut͡s-iβ\, cat-ERG mouse N-catch-PST, cat caught a mouse ...
— заметки (могут быть для разъяснения смысла, этимологии, чего-то другого);
— *тематические тэги (цвет, анатомия, природа, и т.д.): animal, domestic ...
— *грамматические тэги (часть речи, класс существительного, вид глагола, и т.д.): noun, neuter ...

Вроде это самые нужные куски информации. Если у кого-то есть мысли, буду рад выслушать (желательно до конца недели, потому что сроки). Если в этом "забеге" не удастся, так на будущее.
Post #90 5.58K
Размышляя над словарём, я видел 2 модели.

Первая - это стандартное серверное приложение. Наподобие https://www.ironau.ru/vortaro.php или https://gaf.lezgichal.ru/. Когда сайт - лишь средство связи с сервером, где хранятся слова и осуществляется поиск.

Вторая модель - мобильное оффлайн приложение, которое скачивается с Google Play / AppStore. Все слова у тебя на телефоне, и ты можешь искать без интернета.

Как это часто бывает с техническими проблемами, здесь нет единственно верного решения. Каждая модель имеет свои преимущества и недостатки, и лучше всего было бы постараться реализовать гибридную модель.

С той инфраструктурой, что имеет наш сайт, раздел словарей реализуется в следующем виде. Пользователь заходит на карту, выбирает языки, открывает словарь. Начинается загрузка словарных данных в кэш браузера. Далее эти загруженные словари доступны на компьютере или телефоне и без интернета.

Плюсы такого подхода:
— После начальной загрузки, автономный доступ к словарями.
— Возможность заносить новые слова, которые будут доступны другим пользователям.
— Полная открытость всех языковых данных, которые всё так же буду храниться в репозитории.

Минусы:
— В худшем случае, если не получится далее улучшить кэширование, придётся ждать секунд 20 при каждой смене языков. Тесты показали, что 4 языка, по 12 тыс. (пустых) словарных единиц в каждом, загружаются и заносятся в локальное хранилище за 11 секунд.
— На данный момент на сайте нет встроенного механизма оповещения об обновлении языковых данных. Так что пользователь не имеет возможности прямо на сайте узнать, если в исходный словарь была загружена новая порция данных, и ему нужно перезагрузить локальную копию.
Post #89 337
Заполнение разговорника временно (до конца мая) приостановлено. На это есть две причины.

Чтобы от сайта была польза, для него нужны материалы, а чтобы были материалы - нужны люди. За прошлые пару неделя я несколько раз пытался объяснять инструменты редактирования. И только тогда я осознал, насколько мои инструменты сложны. Потому что, как разработчик, я не могу оценить тяжесть этой системы для человека со стороны, который к тому же и не программист. И я не знаю, как это положение можно поправить. Очевидно, нет смысла в упрощении самой системы в ущерб функционалу. Тогда, наверное, нужно будет создавать обучающие видеоролики, писать текстовые руководства. Плотно займёмся этим летом.

Вторая причина в том, что я теперь работаю над сайтом в рамках двух учебных предметов. Это очень хорошо, но это ещё и накладывает побочные, чисто академические задания, на выполнение которых я и должен временно переключиться.

Вот так, в ближайший месяц буду писать о ходе разработки словарей. Пока что всё ещё есть совершенно непонятные для меня моменты в реализации, поэтому сейчас активно исследуем разные технологии.
Post #88 418

Forwarded from За языки РФ

Интервью со спикером нашей конференции Магомедом Магомедовым на портале Global Voices

AM: What are your hopes for the future of Kaitag and other local languages?

MM: I used to think that everything was lost, but now I believe that even a single passionate person with a cheerful attitude and the right tools can turn the tide of the battle. Most importantly, we have small but passionate local communities with individuals working hard to reclaim their intellectual sovereignty. And then—this is my part—we have technologies to facilitate our activities and explore innovative solutions. The future is exciting for those of us who aspire to use for good and multiply the intellectual assets provided by our languages and our culture.

https://globalvoices.org/2021/03/28/the-watchtower-on-the-mountain-of-dagestans-indigenous-languages/
Global Voices The watchtower on the mountain of Dagestan's indigenous languages Kaitag, a language variant of the Dargwa family, is spoken in Dagestan's mountainous villages, but has a limited digital presence. Digital activists like Magomed Magomedov are working to change this.
Post #87 4.69K
Итак, на прошедшей конференции я более подробно рассказал про внутреннее устройство системы, про простые алгоритмы соединения языков на ходу, и про общее состояние проекта. Также я показал первый эксперимент со словарём (начиная с 39й минуты). Продолжая идею прямого связывания языков, я постарался сделать так, чтобы можно было ввести слово, например, на Иронском, и получить его Дигорский перевод. Или ввести слово на одном из дагестанских языков, и получить его перевод на других родственных языках.

Как и с другими частями приложения, связь между нашими языками идёт через английский, и он тоже отображается в интерфейсе, но выполняет, скорее, побочную функцию. Английский перевод всегда отодвинут на второй план и не является центральной частью композиции интерфейса. Как и с разговорником, тот формат, в котором я стремлюсь разработать словарь, является нетривиальной задачей, и есть большая вероятность, что довести до качественного уровня не получится. Но я постараюсь. В конце концов, насколько я знаю, пока что в природе нет ни прямого кабардино-адыгейского, ни ироно-дигорского словарей, а параллельные переводы дагестанских языков вообще покажут очень много интересного. Алыхьым жиӏэм, мы будем в этом первыми.

Теперь о разговорнике. Заполнение идёт своим чередом (если не считать перерыв на прошлой неделе ввиду выступления), и уже составлены 3 раздела. Начиная со следующей недели я планирую увеличить длительность итерации с 2х до 3х недель. За предыдущие циклы я увидел, как мне приходилось вносить правки во фразы практически в последний момент. Теперь к проекту присоединяются новые языки, и я больше не могу позволить себе такое. Поэтому дополнительная неделя будет использована для тестирования и конечных правок.

Итого:
первая неделя - выбор тематики новой главы и составление фраз;
вторая неделя - занесение корпуса на сайт и тестирование его на моём языке;
третья неделя - заморозка главы корпуса и начало перевода на другие языки.

Увеличение длительности цикла также позволит мне выделить время для более активной разработки словаря, который сейчас находится в самой ранней стадии. А также это позволит координировать работу по переводам и помогать остальным участникам в работе с инструментами. Я несказанно рад, что к проекту присоединяются Адыгейский (опсэу, Фатима) и Лезгинский (сагърай, Самир).
YouTube Магомед Магомедов | Республика Дагестан - Портал кавказских языков Avzag
Post #79 392
Post #78 344
Пока мы ждём видео с недавней конференции, чтобы поделиться последними новостями по проекту, вот интересный взгляд на родной язык на примере Удмуртского. Поразительно, насколько практически всё сказанное в статье относится и к моему языку, и, полагаю, к другим языкам Кавказа.
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →