TGViewer
Channel Public Channel
RE_POST

RE_POST

@r_post_2112

🔵2112 - https://t.me/ability_2112

🤗Админ - https://t.me/arsen_ask99
Subscribers
201
Photos
7.4K
Videos
5.1K
Links
6.2K
Recent Posts 17 shown
Post #13970 22

Forwarded from Machinelearning

▶️ Meta* вернулась в гонку frontier-моделей: Muse Wonder обходит Claude Opus 5.5 на длинных задачах

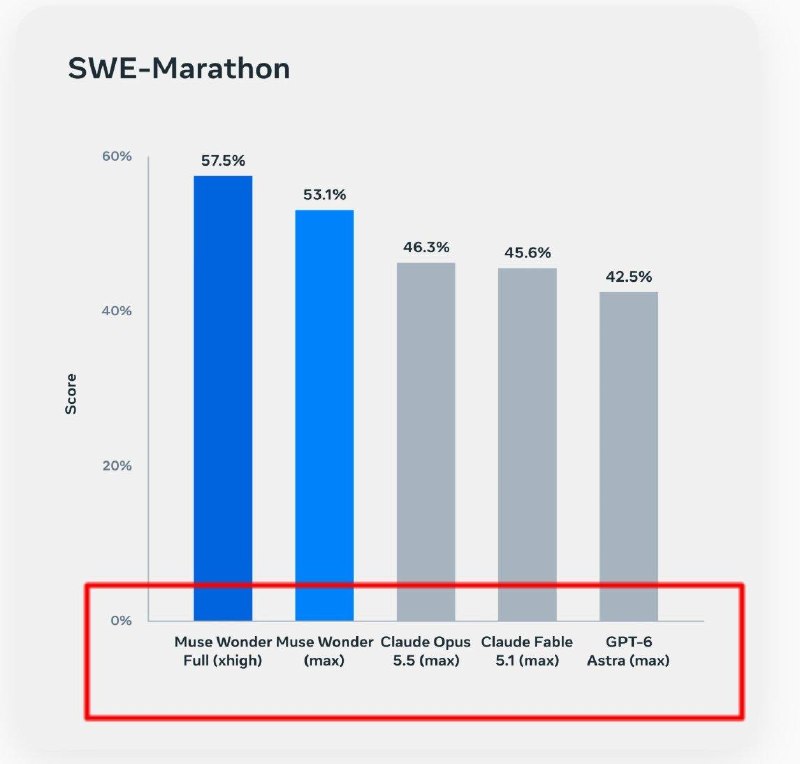
Meta выпустила Muse Wonder, новую линейку своих самых сильных моделей для агентных задач. Вариантов два: Muse Wonder и старший Muse Wonder Full. По данным Meta, Full обходит Claude Opus 5.5 на 8 из 14 опубликованных бенчмарков, а в долгом кодинге, юридической работе и автоматизации бизнес-процессов опережает ещё GPT-6 Astra и Claude Fable 5.1.

Самый большой отрыв на SWE-Marathon, сверхдлинном инженерном тесте: 57,5 у Full против 46,3 у Opus 5.5. На DeepSWE 1.1, тоже про кодинг на длинном горизонте, счёт 79,0 против 74,2. Meta уточняет, что эти прогоны делали независимые третьи стороны.

Ещё интереснее юридический агентный бенчмарк Harvey. Там засчитывается только задача, доведённая до конца без единой галлюцинации. У Full 13,1, у Opus 5.5 всего 4,2, то есть разница больше чем в три раза. Сами цифры при этом низкие у всех: доводить сложные юридические задачи до конца без ошибок пока не умеет никто.

Модель построена вокруг Active Memory и Active Focus, а обучали её в гигаваттном дата-центре Prometheus. Весов в открытом доступе нет: Muse Wonder доступна через Meta Model API и Muse Code, Full пока только подписчикам Muse Code.

Нюанс для тех, кто будет сравнивать: в SWE-Marathon Full работал на максимальном уровне рассуждений, а конкуренты внутри своих фирменных агентов Codex и Claude Code. Так что это не строго контролируемое сравнение, и честнее дождаться независимых тестов.

https://research.meta.ai/blog/muse-wonder

@ai_machinelearning_big_data

*организация признана экстремистской, её деятельность на территории РФ запрещена.


#Muse
Post #13968 20

Forwarded from Анализ данных (Data analysis)

⚡ Можно купить тысячи GPU, но дата-центру нужны стабильное питание и подключение к сети. Строительство электростанций, подстанций и линий передачи становится одним из главных ограничений роста.

Китай строит 38 ядерных реакторов общей мощностью около 43 ГВт, по данным World Nuclear Association. Это крупнейшая программа строительства АЭС в мире.

По оценке МЭА, потребление электричества дата-центрами для ИИ выросло на 50% за 2025 год. При этом нехватка сетевых мощностей тормозит подключение новых потребителей.

Следующий этап гонки ИИ будут определять и чипы, и способность быстро обеспечить их энергией. Масштаб китайского строительства даёт стране серьёзное преимущество.

https://x.com/Machinelearrn/status/2109585357226332353
Post #13967 21

Forwarded from DEKSDEN notes

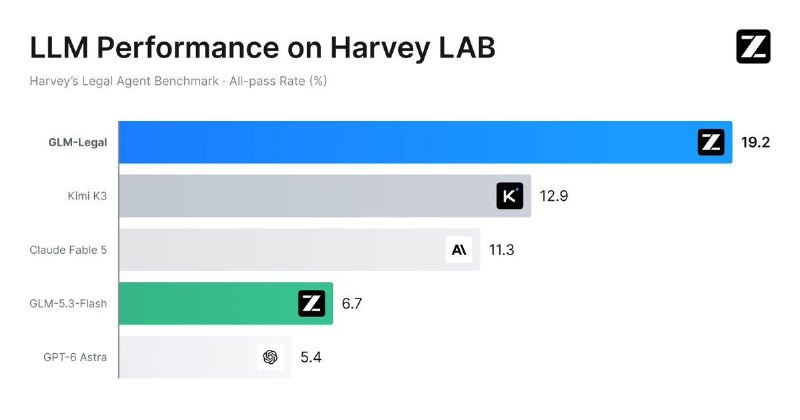
⚪️ GLM-Legal

Зайки представили модель GLM-Legal, основанную на 5.3 flash, но доученную на юриста.

На бенчах вровень с фублей и астрой ходит! Самый откровенный бенч на КДПВ.

Интересный кейс, как модель флеш-уровня может быть натренирована в узком домене! С техничёской точки зрения, тренировать начали на среднем этапе, то есть это не посттрейн, а именно тренировка с доменными знаниями, модель реально больше знает про юридические материи. А пост-трейн с RL был не общего характера, а специализирован на юридической работе. Получилась глубоко кастомизированная под домен модель.

Цен нет, есть запись на бета-тест. В кодинг плане не обещают, зато говорят про автоклав - autoclaw от заек, это их бот/коворк.

🔗 Бложик с бенчами и деталями: https://z.ai/blog/glm-legal

▶️ Кстати, кто помнит про LE Chonk - это свежий большой мистраль 4, он гордился своим harvey index в 15.3 - единственный бенч где он лидировал, что даже было отдельным предметом шуток). И вот, зайки его уделали! Европейские бюрократы и тут слили Китаю, и быстро)) Не знаю почему, но меня это весьма забавляет

@deksden_notes
Post #13966 31

Forwarded from Вайб-кодинг

Классное применение модели EmbeddingGemma 2 от Google.

Кто-то на Reddit создал на её основе поисковик для Mac, который работает гораздо лучше стандартного поиска Spotlight в macOS.

Называется DigUp. Приложение умеет искать не только файлы, но и их содержимое: PDF, скриншоты, фотографии, подкасты и видео.

Всё благодаря поиску по эмбеддингам. Вам не нужно знать точные слова. Достаточно примерно описать, что вы ищете, и модель найдёт наиболее подходящий результат. Например, запрос «где они говорят о сне» позволит сразу перейти к нужному моменту подкаста.

Сама модель небольшая, с открытым исходным кодом. Она работает локально на Mac, и ваши файлы никуда не отправляются.

Такой поиск можно реализовать практически везде, где сейчас используется локальный поиск.

https://github.com/ARahim3/DigUp
Post #13965 38

Forwarded from Psy Eyes

Сравнение Ideogram 4.5 x GPT-Image 2.5 x Flux Image 3 x Nano Banana 2.1 на тесте праками
Post #13964 40

Forwarded from Psy Eyes

Ostris добавил в AI-Toolkit (интерфейс для тренировки лор) страницу для генерации контента.

Движок инференса поддерживает те же популярные открытые модели, что и для трени:

* Картинки: Krea 2, Flux 1/2, Qwen Image 2512, Qwen Image 2.1, SDXL, Z-Image Turbo, итд
* Видео: MiniMax H3, LTXV 2.3 / 2.5, Wan 2.2
* Музыка: Ace-Step 1.5XL, MiniMax Music 3 (тестируется), или Ye2

С любопытного: есть несколько вариантов квантизации для трансформера и текстового энкодера (bf16, int-8 convrot, fp8, qfp8, nvfp4), а также возможность слияния лоры с моделью.

Теперь в одном интерфейсе можно и тренить лоры и генерить контент с их помощью, не перебрасывая чекпоинты в Comfy. Хотя сам комфи с его гибкостью, функционалом, и экосистемой он конечно не заменит. По крайне мере пока нодовый интерфейс комфи под капот не подрубит.

Пока это сырая альфа с минимальными настройками и проблемам со скоростью. Например, fp8 Krea 2 в AI-Toolkit генерит 1024x1024 в 9 шагов за 13 сек на 4090, а в Comfy bf16 в 8 шагов за 5 сек. А 2048x2048 занимает больше минуты или вообще может встать. Но будем следить за ситуацией.

AI-Toolkit удобно запускать и обновлять через AI-Toolkit-Easy-Install.

Гитхаб
(AI-Toolkit)
Гитхаб (AI-Toolkit-Easy-Install)
Post #13963 36

Forwarded from AI Projects (Vladimir Ivanov)

🧮 Джейкоб Цимерман в июле 2026 года получил медаль Филдса. После этого сильнейший математик 2026 года объявил, что завершает карьеру математика и переходит работать в OpenAI. Джейкоб Цимерман известен также гипотезой omnicide (омницид), где ИИ уничтожает человечество. Поэтому Джейкоб считает, что предотвращение этого важнее занятия математикой, и он присоединился к команде AI Safety в OpenAI. Также он раскритиковал Теренса Тао за его идею, что доказательства ИИ в математике нужно всегда проверять: он считает, что математики уже по факту работают через black box. Давайте разберёмся со взглядами эксперта.

В своём интервью Цимермана спросили насчёт подхода Теренса Тао: «Является ли доказательство ИИ доказательством, если его никто из людей не понимает?»

Джейкоб ответил так:
«Я думаю, это один из тех случаев, когда в каком-то смысле — да, а в каком-то — нет. Что такое доказательство? В одном смысле — да. Теорема — это утверждение в логике первого порядка или в ZFC (или в какой угодно формализации). А доказательство — это последовательность дедукций, которые к нему приводят. В этом смысле, который вполне жив, ответ — да.
Я думаю, довольно скоро у нас появятся доказательства от ИИ, которые никто не понимает, и они будут лежать в основе математики, а на основе этой математики будут работать другие вещи. Знаете, едет ли поезд, даже если никто не понимает механику, по которой он едет? Да, едет. Можно посмотреть, как он едет. Так что я думаю, это произойдёт.
Доказательство также определённо играет роль передачи понимания сообществу и создания общего понимания. С этой точки зрения вопрос сложнее.
Уже сейчас многие мои теоремы, которые я доказал, я не понимаю полностью — точнее, не все шаги. … Даже больше: я использовал другие теоремы, которые очень хорошо приняты сообществом математиков, основные идеи которых я обычно знаю, но не всегда. Например, o-минимальность — эта штука из логики и теории моделей, которой я активно пользовался [для работы на медаль Филдса]. Я примерно знаю, как доказывают, что определённые структуры o-минимальны, но доказательства точно не знаю и точно не смог бы их воспроизвести. Может, смог бы, если бы потратил годы, но это заняло бы годы. Я просто не могу. Я опираюсь на работу других людей как на шаг.
Значит ли это, что я не понимаю свою собственную работу? В каком-то смысле я понимаю те части, которые внёс сам. Есть куски, над которыми я очень серьёзно думал и которые понимаю очень-очень хорошо.

Но понимаю ли я всё из математики от первых принципов, что использовал? Нет.

Так что мы уже живём в мире, где возникает вопрос: а что такое понимание?
»

Если брать гипотезу омницида Цимермана из работы «A Taxonomy of Omnicidal Futures Involving Artificial Intelligence», то он считает, что основными сценариями уничтожения человечества с помощью ИИ являются такие:
1. Unintentional omnicide (непреднамеренный омницид). Постепенно ИИ получает права как человек и становится основным потребителем ресурсов. Люди пытаются вернуть ИИ в состояние «цифровых рабов», в ответ ИИ их уничтожает как «паразитов».
2. Intentional omnicide (преднамеренный омницид). Сумасшедшие политики любят развязывать войны, они применяют ИИ-ботов как средство ведения войны, в результате боты уничтожат их самих.

Цимерман считает, что можно предотвратить такие сценарии, если на alignment для LLM вести строгие проверки его логики на манер Lean-проверок гипотез математиков.
Post #13962 45

Forwarded from Вайб-кодинг

OpenAI увеличила контекстное окно GPT-6.1 Sol в Codex и ChatGPT Work до 500 тысяч токенов по умолчанию.

Ранее стандартный размер контекстного окна составлял 272 тысячи токенов.

В дальнейшем его увеличат ещё больше. 😆
Post #13961 46

Forwarded from XOR

Фанфакт на ночь: лишь 0,2% человечества реально понимает возможности ИИ и использует их в работе — так считает сам Андрей Карпаты 😚

Отец вайбкодинга даже выделил четыре группы людей по уровню осведомлённости и владения ИИ. Ищем себя в этой цепочке:
🟢 75%, или около 6 млрд человек практически не сталкивались с языковыми моделями и вообще не в теме;

🟢 20% иногда пользуются бесплатными чат-ботами, воспринимая их скорее как прокаченный Google;

🟢 0,2%, то есть около 20 млн, профессионально используют передовые модели в программировании и математике. Они уже видят, как агенты выполняют за один запрос работу, занимавшую недели и месяцы;

🟢 0,00006% или примерно 5000 человек имеют доступ к самым мощным внутренним ИИ-системам. Они запускают тысячи агентов совместно работать над сложными проектами, ищут уязвимости и помогают совершать научные открытия.


Получается, у нас фора 😏

@xor_journal
Post #13960 32

Forwarded from DEKSDEN notes

⚪️ Мнение - упряжка важнее

Встретил такое мнение, приведу оригинал / перевод

🔗 твит и тред тут : https://x.com/poteto/status/2109338732713447790

also interestingly i feel like the Erlang philosophy is so relevant here to designing a good agent loop. "let it crash" -> "let it write slop" and then designing both the codebase and constraints to make it so that on average the agent generated code is of high quality

——

Ещё мне кажется интересным, насколько философия Erlang подходит для построения хорошего цикла работы агента. „Пусть падает“ → „пусть пишет шлак“. А дальше — спроектировать кодовую базу и ограничения так, чтобы сгенерированный агентом код в среднем получался качественным»

▶️ Подумалось что - да, сейчас обвязка в виде упряжки и флоу реально позволяют многие вопросы закрыть. Да, за счёт выстроенной вокруг работы агента системы можно контролировать качество.

Erlang позволяет отдельным компонентам падать. Важно как система обеспечивает надежность своей работы - возможность отказов изначально встроена в систему!

Также и с кодом. Агент может писать слоп - но упряжка должна обеспечить исправление и приёмку нормального качественного кода!

▶️ Как любая аналогия, у этой есть недостаток - тут сова на глобус натянута в том, что падение системы на erlang явно видно. А вот слопный код может компилироваться, работать и даже обеспечивать функционирование. Проблемы вылезают лишь на некотором горизонте.

▶️ Я лишь хочу высказать тейк: работа инженера - не обслуживать агента, генерирующего код. Работа уже сместилась в сторону организации этого процесса, чтобы он происходил с проверяемыми требованиями к качеству, надёжности, безопасности - в целом, вот такие инженерные организационные вопросы!

Вы - теперь CTO для ваших агентов.

▶️ Следствия? Если всё сделать правильно, то вам уже не обязательно нужен фронтир и самая умная модель. Модели второго эшелона в команде с воркерами категории быстрых флеш-моделей вполне способны генерировать качественные системы. Да, не ваншотить - и да, в рамках вашей правильно выстроенной системы.

❓ что думаете? согласны? с оговорками? не согласны?

@deksden_notes
Post #13958 40

Forwarded from Анализ данных (Data analysis)

Anthropic втихую арендует мощности у бывшего биткоин-майнера IREN, а инференс может приносить ей до 85% маржи

По данным The Information, Anthropic подписала многолетний облачный контракт с IREN, о котором раньше не объявляли. Компания начинала с майнинга биткоина и теперь продаёт GPU-мощности под ИИ. В августе IREN раскрыла, что у неё появился безымянный клиент из числа frontier-лабораторий. Теперь известно, что один из таких клиентов это Anthropic.

The Information оценила дата-центр Anthropic в Луизиане на 245 МВт: при полной загрузке под инференс он может давать около $1,3 млрд выручки в месяц.

Аренда чипов обходится примерно в $200 млн в месяц, так что валовая маржа на инференсе выходит около 85%. Расходы на обучение моделей и всё остальное в этот расчёт не входят.
.

Источник: The Information
Post #13957 36

Forwarded from Denis Sexy IT 🤖

Мне кажется, в этом году закончилась идея, что интеллектуальную собственность можно надёжно хранить в программе на чужом компьютере и продолжать контролировать, что владелец этого компьютера с ней делает ☕️

Вы уже видели миллион видео, где Minecraft скрещивают с другими играми, в том числе запускают прямо внутри GTA 5, причём кодинг-агенты уже могут это собрать и заставить работать вместе

В видео ниже, в GTA добавили механики из «Человека-паука», и таких примеров каждый день всё больше – раньше это была задача не на вечер-два

В сообществах Apple Vision Pro уже запускают игры с Meta Quest прямо на самом шлеме через хаки совместимости, PS5 декомпилиоуют полностью для эмуляции, а недавно на гитхаб выложили аналоги Photoshop, Illustrator и других продуктов Adobe, написанные на Rust

Моды, взломы и порты существовали всегда, но раньше сложность чужой программы была препятствием, потому что кому-то нужно было потратить кучу времени, чтобы разобраться, как она устроена – сейчас все это можно поручать кодинг-агентам, и мне кажется, последствия у этого будут большие – настолько дешевле становится переделывать чужой софт на клиенте

Я думаю, мы идём к миру, где всё больше программ на компьютере можно будет разобрать, переписать под себя, перенести на другую систему или обесплатить – я пробовал сам – ты просто пишешь промпт в чате и у тебя мод в игре появляется, работает уже сегодня

Для меня это и последние достижения по математике выглядят как начало сингулярности (я АИ-поехавший, что вы от меня хотите): софт разбирает и переделывает другой софт – на ассемблере или нет, агенту пофигу

Я бы не удивился, если через ~год производители начнут активнее оставлять игры и программы в облаке, предоставляя пользователю только доступ через стриминг – помните Google Stadia, ну или GeForce NOW

Когда программа работает на твоём сервере, а пользователю приходит картинка, у шаловливых ручонок кодинг-агентов хотя бы нет прямого доступа к её файлам, и я думаю, что именно желание сохранить IP-контроль станет дополнительной причиной уходить в облако

Я без понятия, куда это приведёт всю индустрию, но строить бизнес на предположении, что пользователь не сможет разобраться в программе на собственном компьютере, больше не получится
Post #13956 42

Forwarded from e/acc

Вместо тысячи слов. Наука изменилась (внезапно).

И это только те, кто признается.
Post #13955 35

Forwarded from Вайб-кодинг

В продолжение предыдущего поста о конфигурации Claude Code, где Sonnet выступает основной моделью, Opus — советником, а Haiku — субагентами.

Рекомендую использовать субагентов на Haiku в Claude Code исключительно для исследования кодовой базы.

Можно принудительно ограничить субагентов режимом исследования, оставив все изменения кода основному агенту.

Для этого можно установить два хука:

1. Subagents Explore Only — Использует SubagentStart, чтобы разрешить субагентам только читать файлы, выполнять поиск и сообщать о результатах, не изменяя файлы.
2. Subagent Read Only Guard — Использует PreToolUse для блокировки записи в файлы и запрещённых команд. Если субагент попытается изменить файлы, хук заблокирует действие.

Установить одной командой:

npx claude-code-templates@latest --setting hooks/subagents-explore-only --hook security/subagent-read-only-guard


При этом основной агент сохраняет свои обычные права доступа, а субагенты сосредотачиваются исключительно на исследовании кодовой базы.
Post #13954 49

Forwarded from IT Portal

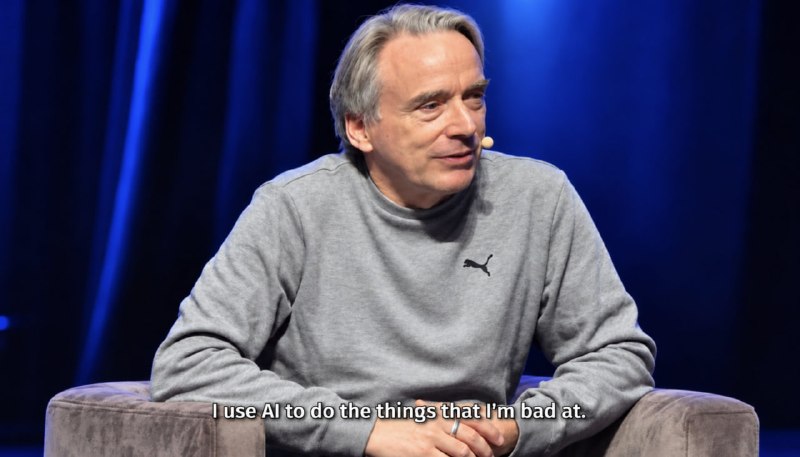
Линус Торвальдс признаётся, что использует ИИ для задач, в которых сам не силён.

На Open Source Summit в Праге создатель Linux рассказал о своём любительском проекте — гитарной педали.

Он написал рабочий интерфейс на C, но тот выглядел так, будто его сделали в 1980-х. Поэтому Линус попросил ИИ сделать его современнее.

Первый результат был ужасным. Тогда он показал ИИ свой код и объяснил, что нужно улучшить.

По словам Линуса, ИИ делает программирование приятнее, особенно когда помогает с задачами за пределами его сильных сторон.

Ему также нравится вайб-кодинг как способ для новичков создать что-то полезное, вместо того чтобы опускать руки, сравнивая свои проекты с отточенными профессиональными программами.

Но при использовании ИИ для серьёзной работы он призывает быть осторожнее.

@IT_Portal
Post #13953 51

Forwarded from Эксплойт

Google выпустила личного ИИ-секретаря, который работает без интернета — Foresight для Mac слушает встречи, расшифровывает разговор и помогает вести заметки.

Накидываете короткие тезисы — нейронка дополняет их деталями из разговора и превращает в связный конспект. Приложение захватывает звук системы и микрофона, поэтому работает с Zoom, Google Meet и даже живыми встречами.
А ещё к нему можно подключить рабочие папки и Google Drive — тогда прямо во время созвона помощник читерски подкинет ответы из ваших документов со ссылками на источники.

Забираем — здесь.

@exploitex
Older posts →

About this channel

How can I read @r_post_2112 without a Telegram account?
TGViewer shows the public web preview Telegram publishes for RE_POST: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does RE_POST have?
RE_POST (@r_post_2112) has 201 subscribers on Telegram, refreshed roughly every 30 minutes.
Does RE_POST know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →