TGViewer
Channel Public Channel
📢 Load & Performance

📢 Load & Performance

@qaload

Избранные материалы о тестировании производительности.
Чат и источник тем: @qa_load
Subscribers
940
Photos
92
Videos
12
Links
128

Showing posts older than #214 · Back to latest

Older Posts 14 shown
Post #213 383
Привет любители производительности!

Как подружить Gatling и JUnit 5

Вызов Java-метода
import io.gatling.app.Gatling
Думаю что вы уже знаете, как вызвать Gatling программно

Gatling.main(gatlingArgs);

но вот незадача — там в конце main-вызова есть
.MODULE$.exit(this.fromArgs(args));

и этот код завершит текущий процесс, включая и Junit 5 процесс — все просто схлопнется, но нагрузка выполнится до конца, а вот сделать какой-то assert или обработку в Junit уже не получится

Вызов Scala-метода
import io.gatling.app.`Gatling$`
Можно запустить Scala-класс явно, без Java-обертки которая вызывает exit в конце

`Gatling$`.`MODULE$`.fromArgs(gatlingArgs)


Тут все получится и тест не завершится. Но он не упадет если внутри Gatling сработали ассерты.

Добавить проверку статуса
import io.gatling.app.`Gatling$` + код возврата
Чтобы внутренние ассерты сработали надо еще добавить проверку кода:
  ┌─────────────────────────────┬───────────┬──────────────────────┐
│ Scala case object │ Exit code │ Значение │
├─────────────────────────────┼───────────┼──────────────────────┤
│ StatusCode.Success │ 0 │ Всё ок │
├─────────────────────────────┼───────────┼──────────────────────┤
│ StatusCode.InvalidArguments │ 1 │ Ошибка аргументов │
├─────────────────────────────┼───────────┼──────────────────────┤
│ StatusCode.AssertionsFailed │ 2 │ Assertions провалены │
└─────────────────────────────┴───────────┴──────────────────────┘

Проверка на Kotlin может выглядеть вот так
val exitCode = `Gatling$`.`MODULE$`.fromArgs(gatlingArgs)
if (exitCode != 0) {
throw AssertionError(
"Gatling simulation ${simulationClass.simpleName} failed with exit code $exitCode" +
if (exitCode == 2) " (assertion failures — check Gatling report for details)" else ""
)
}
  • 🔥 3
Post #212 327
Привет любители производительности!

Согласно аналитике с levels, habr, … в нагрузке в 2026-м платить стали больше, особенно в GPU и AI-проектах

Если есть ускорение за счет AI, использование облаков, k6 и Rust, если уже не просто скрипты, а SRE-путь, …

И всем же интересно что качать, чтобы доходы росли? И здорово понимать, какие вообще сейчас доходы

Вот тут 4 анонимных опроса про локацию, доход, технологии и тренды:

🤩https://t.me/qa_load/170588/170590

🤩https://t.me/qa_load/170588/170593

🤩https://t.me/qa_load/170588/170595

🤩https://t.me/qa_load/170588/170596

Примите участие в них. Они закроются через месяц автоматически и обсудим результаты. Сравним тенденции и данные аналитиков с тем что видят любители нагрузки своими глазами
Telegram Viacheslav Smirnov in QA — Load & Performance Опрос 1: Локация и Грейд (Макрорегионы) 🇷🇺 🇧🇾 РФ и РБ (Middle+) / 🇷🇺 🇧🇾 РФ и РБ (Senior / Lead / Arch) / 🇺🇦 🇲🇩 Вост. Европа: Украина, Молдова (Middle+) / 🇺🇦 🇲🇩 Вост. Европа: Украина, Молдова (Senior+) / 🇰🇿 🇦🇲 Центр. Азия и Кавказ: КЗ, УЗ, АМ, ГЕ (Middle+)…
  • 👍 5
  • 😁 2
Post #211 361
Привет любители производительности!

Появилась задача тестировать текстовый поиск, текстовый индекс и большие тексты. И подумал — а где мне взять внятный текст большого размера?

Выбор пал на книгу:

🤩https://github.com/dendibakh/perf-book
🤩Denis Bakhvalov - Performance Analysis and Tuning on Modern CPUs

под лицензией "Creative Commons Zero v1.0 Universal"
🤩https://github.com/dendibakh/perf-book/blob/main/LICENSE

В формате MarkDown это 460 КБайт текста. Если сделать статью где будет две таких книги подряд — 920 КБайт, а если три — 1300 КБайт.

Сама книга отличная. И я сразу нашел узкие места, она оказалась еще и очень удачной !!!

Следующая версия YouTrack будет с оптимизациями касательно статей и более быстрой обработки крупных текстов
  • 🔥 6
  • 👍 2
Post #209 352
Привет любители Linkedin и производительности!

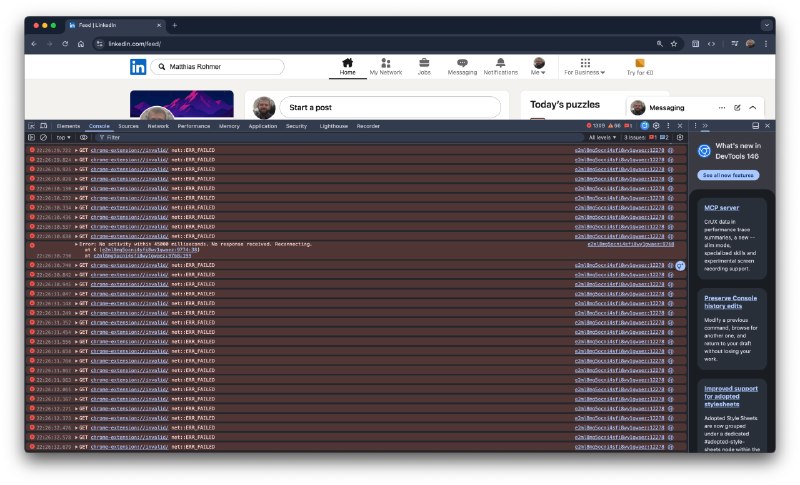
Я слышал про это, но думал, что это шутка. Но в Linkedin встроен детектор расширений браузера Chrome. Написан он коряво и просто перебирает все возможные расширения через HTTP-запросы. И вот сработал для меня сейчас. Проверяется 4278 расширений (на фото 1309 уже проверено) — сайт понятно не грузится и тормозит жестко

Кто-то на...кодил 🤦‍♂️ знатно на главной странице

А расширений у меня в браузере нет. Вот незадача. Лишь тормоза и нагревание воздуха

Из крутого в Sources сейчас по умолчанию показывается сколько раз каждая строка кода выполнилась — профилирование включено по умолчанию

И раз уж этот пост про linkedin — https://www.linkedin.com/in/v8v/ — добавляйтесь в контакты 🤗
  • ❤ 2
Post #208 352
Привет performance lovers!

Наткнулся на статью
https://jbachorik.github.io/posts/stackprofile-jfr

Где Jaroslav Bachorik (https://www.linkedin.com/in/jbachorik/) рассказывает про jfr-shell и как это можно использовать и как консольную утилиту для работы с профилированием и как MCP-сервер (как основу для скиллов)

И понял что делаю тоже самое. Я тоже работаю над вопросом "When Did That Hotspot Happen?". Мои скрипты генерируют HTML вместо TUI, но идея та же — получение флейм-графа на основе конкретного временного диапазона, группы потоков и паттерна стектрейса:

🤩Выделить блоки из стектрейсов (например, SearchSuggestions.getQueryFeatures)
🤩Подготовить таймлайн с блоками (сверху)
🤩Определить аномалии (outliers) — это необычно долгие блоки среди всех и среди таких же блоков
🤩Выделить временной диапазон с аномалиями и группу потоков (у меня это в 99% случаев потоки qtp)
🤩Агрегация всех блоков с выбранным именем из этого диапазона времени и группы потоков в итоговый флейм-граф

Я сейчас использую YourKit, но думал все что надо перейти на JFR тоже или сделать такой код чтобы и JFR и YourKit поддерживались. А вот получается для JFR уже есть инструменты. И это очень круто!!
  • ❤ 3
  • 👍 2
Post #207 327
Привет performance lovers!

Придумывал как анализировать данные профилирования в pipeline (автоматически)

И придумал схему с InfluxDB

Длительность

🤩1 минута — через такое время после проблемы срабатывает алерт
🤩15 минут — через такое время после запроса данных профилирования, формируется готовый к анализу файл
🤩30 минут — столько времени занимает анализ файла профилирования и формирования отчета
🤩60 минут — в файле профилирования хранятся данные за последние 60 минут с момента сохранения файла

Проблема

В общем, процесс не быстрый
🤩за 1+15 минут успеет случится до 16 алертов

Отработать каждый из них отдельно неэффективно. Ведь у нас есть файл за 60 минут, все 16 алертов туда поместятся

Нужен накопитель

🤩а что если накапливать информацию по необработанным алертам в InfluxDB и отрабатывать их группами

Выбрал тут InfluxDB потому что оказалось просто отправить по HTTP в это хранилище сообщение-метрику

И тот механизм который отправляет алерты через HTTP WebHook в мессенджер, также отправляет теперь и сообщение в базу данных

Нужно теперь обработать алерты

Вот это сложная часть. Пока есть только идеи, как можно это сделать. Дорабатываю инструменты, дроблю и уточняю алерты

Надеюсь, получится через год передать автоматике тот процесс, который сделал уже вручную сотню раз
  • ❤ 4
  • 👍 2
Post #204 435
Привет Performance lovers!

Оценим отчет по тесту:
🤩Запросы инструментом подаются ровно (верхний график)
🤩А вот ответы в 09:13:10 и дальше нестабильны (нижний график)

Если бы запросы подавались нестабильно, то я бы подумал, что дело в периодической сборке мусора JVM на стороне инструмента нагрузки

Но тут ответы нестабильные, скорее всего дело в периодической сборке мусора JVM на стороне нагружаемого сервера

И действительно — данные телеметрии, которые собираются инструментом профилирования, показывают что это G1 OLD Generation сборка мусора именно в моменты этих всплесков (коллега у меня называет их "вздрыжнями" 😄)

Я пока не настроил полноценное Observability временных тестовых стендов, которые создаются во время работы pipeline. Использую только YourKit snapshot который записывается в каталог логов при остановке процесса и логи приложения. А build-агент потом создает zip-архив с файлами

В дальнейшем сделаю и отправку логов и отправку метрик. Для начала хватает YourKit-а и логов

Возможно, само профилирование потребляет много ресурсов. А может быть нагрузка очень высокая для такого малого тестового стенда. А может стоит добавить некоторые оптимизации
  • 👍 5
Post #203 367
Привет Performance lovers!

На фото интересный вариант визуализации данных семплирования приложения за 1 час

🤩3600 точек по горизонтали (по количеству секунд и стек-трейсов)
🤩500-800 точек по вертикали (по количеству потоков)

а цветами обозначено состояние потоков:
🤩вот видно, в конце, справа, как произошла недолгая блокировка 🔴
🤩а в середине, были активны Async-потоки, которые ждали ответов от внешних систем 🔵
🤩еще видно как пул потоков jetty постепенно уменьшается, а потом jetty делает всплеск и запускает новую партию активных потоков
  • 👍 5
  • ❤ 2
  • 🔥 1
Post #202 497
В инструменте FlameGraph Брендена Грегга есть возможность визуально показать на графе новые/другие части другим цветом. Делается за счет того, для каждой строки можно сохранить какой сейчас используется цвет, а потом переиспользовать его при формировании графа для нового профилирования, для которого будет задана другая расцветка

Описано это вот тут — как переиспользовать палитру
https://github.com/brendangregg/FlameGraph?tab=readme-ov-file#consistent-palette
Вот есть два примера
- https://github.com/brendangregg/FlameGraph/blob/master/demos/palette-example-broken.svg
- https://github.com/brendangregg/FlameGraph/blob/master/demos/palette-example-working.svg

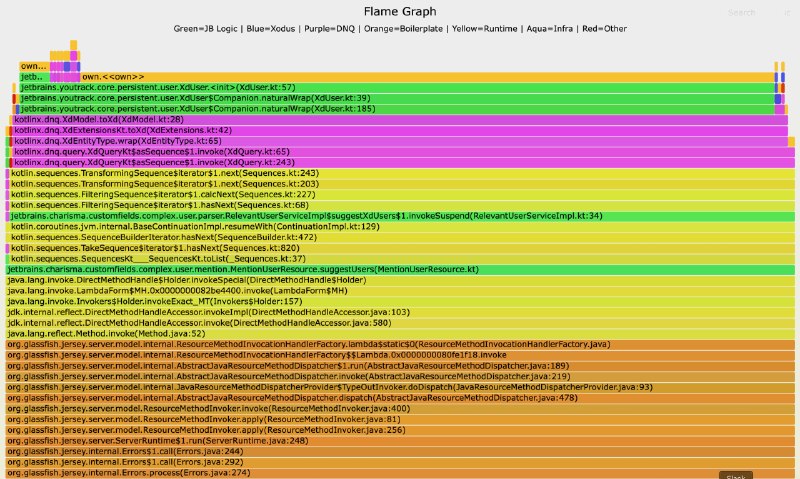
А мне захотелось чтобы все вызовы методов работы с БД были одного цвета, все вызовы бизнес-логики другого, ...

Поэтому придумал категории, префиксы категорий и цвета категорий:

# Jetty HTTP server
org.eclipse.jetty.=JETTY_BOILERPLATE

# Jersey JAX-RS (javax.ws.rs. must be before javax. for longest-prefix-wins)
org.glassfish.jersey.=JERSEY_BOILERPLATE
javax.ws.rs.=JERSEY_BOILERPLATE

# Kotlin standard library and coroutines
kotlin.=KOTLIN_STDLIB
kotlinx.coroutines.=KOTLIN_STDLIB

# JVM runtime
java.=JVM_RUNTIME
javax.=JVM_RUNTIME
jdk.=JVM_RUNTIME
sun.=JVM_RUNTIME
com.sun.=JVM_RUNTIME


Вуаля, немного кода, несколько часов отладки, и получаются слои во FlameGraph разных цветов
  • 🔥 3
Post #201 485
Привет performance lovers!

Мы вместе с коллегой занимаемся Observability as code, и обнаружили что для хранения информации по сотне тысяч сервисов InfluxDB (v1) быстро и просто принимает метрики (если вставлять пачками по 10 000), но медленно потом отдает группировки, а вот Postgres позволяет и записать метрики и быстро показать

Думаю надо будет попозже сделать отчёт сравнение. Потому что такие возможности как LIMIT и SLIMIT мы не попробовали даже для InfluxQL:

https://docs.influxdata.com/influxdb/v2/query-data/influxql/explore-data/limit-and-slimit/

И сравнивали на запросе
SELECT * FROM …

Продолжение следует
Подписывайтесь на канал и жмите на 🛎️
Influxdata LIMIT and SLIMIT clauses | InfluxDB OSS v2 Documentation Use the LIMIT and SLIMIT clauses to limit the number of points and series returned in queries.
  • ❤ 5
Post #199 457
Привет performance lovers, любители книжек и разработки!

Как выше в блоке про книги писал что мне понравилась книга «Двадцать два несчастья» про доктора Епиходова. В рассказах у него есть виртуальный помощник, который/которая помогает ему людей лечить.

А у меня есть AI-агент, который помогает мне код писать. И есть разные подходы, как выполнить сложную задачу и как это описать AI-агенту. Один из способов, может и дорогой, но рабочий такой — дописать в конец непростого задания строку
Запланируй 22 задачи

И если без этого модель пробует в лоб решить задачу, как написание парсера или анализатора или эмулятора. То после такой постановки задачи все начинается не с выполнения, а с планирования десятка шагов (да, получается не всегда 22 задачи, иногда 5, иногда 15). А потом пару раз пройти по списку задач и оценить, где чего не хватает. Так получается тестируемый результат. Небыстро, но мне нравится

Пробую написать скрипты анализа файлов профилирования JVM. Написать к файлам профилирования API, которое решает те задачи, которые решаю смотря на эти данные. Вроде, простая задача. Но ее же не описать одним шагом и запросом. А вот если разбить на десятки, то уже лучше
  • 🤔 3
  • 🔥 1
Post #197 399
Когда и как нагружать MCP?

1️⃣ Почему вопрос возник

Возможно, в вашем продукте появился MCP (Model Context Protocol), и у команды нагрузки появилась задача нагрузить систему по этому протоколу. Так в YouTrack появился MCP сервер, и возникла задача нагрузки

2️⃣ Когда нагружать

Сначала я эту задачу отложил, нагрузки по MCP не ожидалось, поэтому сосредоточился на мониторинге. Вся начальная работа шла вокруг того, как сделать MCP-вызовы наблюдаемыми

Да, таким образом нашли несколько неоптимальных методов, которые внутри делали слишком много. Например, при запросе одного поля получали все поля и возвращали одно — а стали и запрашивать и возвращать только одно поле. Небольшие ошибки были

И вот сейчас уже, когда есть статистика использования (спасибо ранним пользователям) и время — стало удобнее сделать тесты производительности

3️⃣ С чего начать

Мне понадобилась хотя бы минимальная статистика о том, что люди (модели) используют. Конечно же, данные, больше данных — больше узких мест. И знание, как пройти аутентификацию.

Тут мне частично повезло
🤩https://www.jetbrains.com/help/youtrack/server/model-context-protocol-server.html
И для моего случая достаточно использовать токен в заголовке, и не пришлось использовать OAuth с редиректами. К 2026-му году версий OAuth уже несколько, в ходу OAuth 2.1. И возможно, ваш новый сервер будет поддерживать именно его. А возможно, у вас пока тоже будет простой вариант аутентификации

Вот несколько полезных ссылок:

🤩https://oauth.net/2.1/
🤩https://stackoverflow.blog/2026/01/21/is-that-allowed-authentication-and-authorization-in-model-context-protocol/

По первой описаны отличия версий 2.1 от 2.0. А по второй есть схема и примеры аутентификации для тестового MCP-сервера. В случае с SSE еще появится шаг с получением SSE-токена

И даже если код писать в паре с агентами, то знать варианты реализации и как поставить задачу нужно человеку

*️⃣ Неочевидные выводы

Хоть MCP на слуху и популярный протокол, большую нагрузку это не создает. Тестирование производительности можно не ставить предусловием к добавлению MCP

Хоть MCP может работать в непростых для тестирования вариантах, как SSE pooling и OAuth 2.1, также есть и более простые для тестирования варианты, как HTTP и аутентификация по токену

Или мне повезло и это эффект выжившего. Пусть и вам повезет!
  • 🔥 1
Post #193 572
Hello performance lovers!

Мне понадобилось написать тесты на десятки методов (HTTP API, SSE, WebSocket) и для каждого метода есть еще по несколько вариантов Query String или тел запросов

Также мне хотелось использовать Gatling throttle, для ровной нагрузки по RPS. А для этого надо было сделать сценарии длиной в один запрос — только так работает throttle

Сделал каждый запрос реализацией интерфейса IEndpointChainBuilder
🤩это позволило работать с каждым из них в едином виде
🤩например, добавлять такие методы в Registry методов где будет указан вес метода (влияет на вероятность вызова) и Lambda которая вызывает IEndpointChainBuilder.build()

За основу профиля нагрузки взял randomSwitch().on(...)
🤩это позволяет запускать все методы с весами
🤩подметоды методов можно тоже запускать с весами (randomswitch может быть вложенным)
🤩веса вычисляет класс-утилита Registry, который на вход принимает количества и сам вычисляет проценты в этой группе

Так как часть методов связаны — некоторые ответы являются основной для других запросов, — то добавил механизм Adapter-ов которые добавляют общие классы-хранилища (потокобезопасные Queue или Map) в связанные запросы
🤩атомарные запросы связаны не через Gatling Session, а через общие Queue и Map, заданные через Adapter-ы

Получился расширяемый проект
🤩легко добавить новый метод
🤩легко скорректировать актуальное количество (вес) каждого метода

Чтобы было проще отлаживать добавил к заголовкам каждого запроса X-TEST-NAME, где содержится имя теста:
🤩по заголовкам запроса легко отследить запрос на прокси-сервере как ProxyMan.io

Концепт написал и отладил руками, опираясь на знание Gatling DSL. И когда первые тесты были готовы и отлажены, то за работу по добавлению новых методов и вариаций тел и параметров запросов взялся AI агент Junie, который встроен в 💻 ItelliJ IDEA

Закодировать методы и добавить адаптеры по спецификации агент может с помощью как Gemini так и Opus, выбор модели не так важен

Отладка пока осталась на мне. Но процесс понятный
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →