TGViewer
Channel Public Channel
📢 Load & Performance

📢 Load & Performance

@qaload

Избранные материалы о тестировании производительности.
Чат и источник тем: @qa_load
Subscribers
935
Photos
92
Videos
12
Links
128
Recent Posts 19 shown
Post #254 72
Привет любители производительности!

Если вы ищите что почитать, то вот тут собралась отличная папка с каналами и чатами про IT, авторы которой поддерживают друг-друга

Что внутри папки:
- Каналы разработчиков: авторы показывают крутые фишки, заметки с полей, релизы, библиотеки и многое другое 🙂
- АI, чат боты и вайбкодинг: куда без этого, кто-то ещё работает руками?😁
- QA и ИБ каналы, опытные специалисты делятся своими знаниями и помогают в группах/комментариях
- Целый список крутых авторских каналов, которые не позволят заскучать😀
В этой папке все очень-очень актуальное, то что не будет пылиться в архиве телеграмма


А если наоборот хотите вернуться в прошлое и еще не знали, что в цифровых библиотеках тоже можно брать книги, читать, возвращать. И думаете как найти свои старые книги с пожелтевшими страницами. То загляните в архив и открытую библиотеку.
Например, многим будет интересно прочитать первые две части Дюны
🤩 https://openlibrary.org/books/OL7500941M/Dune (фильмы 1-3 по этим двум частям). И в декабре-январе многие будут смотреть третью часть фильма
Или энциклопедии
🤩 https://archive.org/details/20210402_202104
🤩 https://archive.org/details/rosmen_encyclopedia_zhivoi_mir_1997
(у меня были обе эти книги)
Или какие-то старые журналы по радио

🤩 В OpenLibrary, как много где, бывает так, что книга доступна для чтения, но вскоре становится доступна лишь в настоящей библиотеке поблизости. Но, все книги из читательского билета, которые вы начинали читать — продолжают быть открытыми. Поэтому тут даже полезно начать что-то читать и отложить на время — так сохраннее
Telegram Папка RIA You’ve been invited to add the folder “Папка RIA”, which includes 30 chats.
  • ❤ 1
Post #253 200
Привет!

Сделал видео про несколько мониторов и несколько простых инструментов

Да и настроил утилиты

Скоро зима, походы к озерам и водопадам будут редкими. Но буду что-то по производительности записывать

Отличных вам выходных! Глядите в оба (монитора) 🤗
  • 🔥 9
Post #252 245
Кажется, удача меня любит

Чуть базу данных не сломал, но разграничение прав помогло

🍿 История

Взял в работу две задачи — настроить мониторинг баз данных и настроить восстановление баз данных из бекапов с разными тестовыми данными. По задаче мониторинга подготовил параметры подключения. И параметры подключения с RO-доступом, более того, только с доступом до статистики pg_stat_*. И сделать такую роль было непросто. Все круто с этой задаче, но роль было сделать сложно. Одна база данных оказалась с таблицами в схеме public (не в схеме %{service_name}, а в схеме по умолчанию для postgresql). И на нее действуют DEFAULT PRIVILEGES, а они такие, что у роли pg_monitor в том числе есть права на чтение и работу с TABLES, SEQUENCES, FUNCTIONS. Хотя это не видно явно:


CREATE ROLE pg_monitor WITH
NOSUPERUSER
NOCREATEDB
NOCREATEROLE
INHERIT
NOLOGIN
NOREPLICATION
NOBYPASSRLS
CONNECTION LIMIT -1;

GRANT pg_read_all_settings TO pg_monitor;
GRANT pg_read_all_stats TO pg_monitor;
GRANT pg_stat_scan_tables TO pg_monitor;

И надо было заморочиться чтобы забрать права по умолчанию. В общем — в чем-то даже спорный был момент, надо ли было так аккуратно поступать с правами.

Подготовил по второй задаче скрипты и параметры, бекапы сделал. Начинаю тестировать восстановление. И тут запара, другая запара ..., а все эти connection strings длинные и похожие ...

Беру connection string (взял из списка, который готовил для мониторинга), передаю в скрипт восстановления БД и запускаю. А он мне пишет — прав нет на операцию

pg_restore: error: could not execute query: ERROR: must be owner of table ...

Я сначала не понял, да как так. Я же админ, а прав нет — должны быть. А потом как понял, что это большая удача 🍀

🐤 Причина

Я взял строку подключения, вообще, к другой базе данных и восстанавливал в нее бекап не для нее. И все получилось хорошо (а точнее ничего не получилось), только потому, что строки подключения для мониторинга были с минимальными привилегиями

А ведь когда-то я мониторинг настраивал с админскими правами и принцип минимальных привилегий не соблюдал. Сразу представил себя тем человеком, который в первый рабочий день систему роняет и все эти анекдоты. Уфф

💡 Что тут можно подумать

1️⃣ Может не стоит делать сразу две задачи. Может не стоит попадать в запары и запариваться, а если уж запара есть, то не брать две задачи 🙂
2️⃣ И очень круто, что для мониторинга, даже для тестового, использовал минимальные привилегии, а не админские

Если бы были админские права, то базу данных я бы незаметно сломал. Я бы потом не сразу понял почему в ней есть таблицы от другой базы данных?
  • 🔥 5
  • ❤ 3
Post #251 251
Привет performance lovers!

Недавно слышал совет:
делать обработку данных, как можно ближе к источнику

И вот как это применилось на примере k6 сценария, где у меня получилась проблема производительности на ровном месте

Проблема

Тест устроен так, что в нем
1️⃣выбираются данные из БД
2️⃣данные выгружаются в JSON
3️⃣JSON читается и построчно кладется в Redis как list
4️⃣k6 тест в котором несколько vus последовательно читает записи из Redis по индексу
5️⃣отправляются запросы которые делают операции с записями

Проблема производительности возникала на шаге 5️⃣когда много VUS начинали работать с данными из одной группы.

Причины

Так получилось потому, что данные из БД выбираются отсортированными по ID группы в начале. Поэтому в конце этой цепочки много vus начинают обрабатывать записи принадлежащие одной ID группы. И эта группа блокируется.

Первый подход к решению

Такой бы блокироки не было, если бы все разные VUS обрабатывали бы разные группы. Подумал я. И начал править шаг 4️⃣ где VU-ы выбирают какие данные они будут обрабатывать. Cделал интересную логику, где каждый VU берет себе кусочек тестовых данных и работает с ним, а к тестовым данным обращается по индексу с примерно такой логикой:


exec.vu.idInTest *
dataset.length /
exec.test.options.scenarios.NAME.vus +
exec.vu.iterationInInstance


Тут 1-й пользователь обрабатывает начало списка, а 100-й конец списка (100-й подсписок). Поэтому не возникает ситуации что все 100 vus взялись за одну и ту же область с одной и той же ID группы. Но логика получилась довольно непростой. Потому что вы понимаете — если хочется обработать все записи без пропусков и без повторов, то просто применить индекс не получится. На границе отрезков что-то потеряется и округлится, а что-то обработается дважды. А нужны специальные проверки на случай что VUS-ов больше, чем длина тестовых данных.

Второй подход к решению

А более простым решением оказалось в модификации шага 1️⃣
Еще при выгрузке данных из БД убрать сортировку данных по ID группы, а сортировать по ID записи (случайный GUID). Записи сразу перемешиваются, и в тесте можно просто обращаться к ним через


exec.scenario.iterationInInstance

или

exec.scenario.iterationInTest


Такое решение позволяет сделать простой-простой скрипт k6, но не пропустить тестовые данные
  • ❤ 1
  • 🔥 1
Post #250 267
Привет performance lovers!

Видео выше сделано, отчасти, потому, что другие люди проложили этот маршрут за годы до. И он стал более доступным. Тоже стал думать, какой урок я получил за последние четыре-пять лет? Что изменилось в работе? В нагрузке?

⚡ Изменилась скорость изменений. Теперь уже нормально увидеть результат запланированного через дни и недели. Не через годы

🙈 А раньше я сразу умножал сроки в несколько раз и исходил из таких оценок. И это старая привычка стала проблемой для наших дней

Откуда такая привычка пришла? Так получилось из-за того, что я почти никогда не видел результаты изменений в те сроки, которые были в плане, а работы нужно было проделать много больше планируемой. Шутка про домножение сроков есть в разных книгах, где-то без деталей, где-то с деталями. Например Фредерик Брукс («Мифический человеко-месяц») вывел правило: разработчики обычно оценивают только время на написание кода. А проект это сумма, где планирование занимает 1/3 времени, написание кода — 1/6, а тестирование и отладка — половину всего времени. И вот тестирование с отладкой стали x3 от кодирования, а весь проект x6. Это никому не нравилось, но такой был консенсус. Другие книги говорили, что менеджер попросит сократить сроки в 2 раза, возможно, потому что умножая все на 6, менеджеры не попадали в свои ожидания. Поэтому другие книги советовали сразу умножать все в два раза. Хаос, а не математика с планированием, согласитесь? И простая истина была такой:
хорошие дела быстро не делаются


Так лет 15 назад меня научили менять вещи планомерно делая дело, и что к изменениями окружающие будут относиться последовательно меняя мнение о них:
- что-то странное
- в этом что-то есть
- а так всегда и было

И на интервале пятнадцать ... пять лет назад, я долго делал и делал что-то, пока не находились люди, которым это нравилось тоже. А потом дело шло хорошо. Вообще "долго делал и делал что-то" не звучит как изменение, согласитесь? Но вот такой улиточный способ был рабочим. Он действительно работал.

Также улиточная скорость была вокруг меня по роду работы - нередко это некая старая система, которая работала годами и будет работать еще годы спустя, но ее надо ускорить. Поэтому у меня сложился подход к работе, что сначала попробовать ускорить систему конфигурациями и настройками или количеством узлов, как-то понять систему и настроить, потому что ее не поменять скорее всего. Понимание системы, часто связанное с мониторингом, и изменение конфигурации для меня стало синонимом быстрого способа изменений. Добавление индексов в БД тоже стало синонимом быстрого способа изменений. А вот переписывание системы или миграция на новую систему - что-то на долгом и богатом. Да, я буду в этом участвовать, но результат будет не скоро. Такая была установка, которая была проверена на множестве проектов

А лет пять-шесть назад изменения стали происходить быстрее. И сначала я жил по инерции, умножая в голове сроки и прикидывая скоро работы сверху надо будет сделать. А потом стал видеть результаты. Более быстрые, потом еще более быстрые. Легкость этих результатов иногда была удивительной. И не сразу, но это наблюдение поменяло меня и то как дела делаются

⭐ Не домножайте сроки, иногда и делите, возможно это подтолкнет к поиску нового решения или даст импульс и веру другим людям, которые делают это дело вместе с вами

Если вы уже привыкли домножать. И стали энтерпрайз-человеком, то это может мешать при работе в стартапе, например. Это может мешать при работе на некоторых проектах. Знать эти старые техники можно и нужно, знать откуда и почему они взялись тоже. Их можно будет применить при случае. Будем надеяться, что таких случаев будет меньше и меньше

А красная точка на видео — это я благодарный моим родным, друзьям и людям сделавшим этот маршрут. Отличных вам выходных!
  • 🔥 6
Post #249 330
Привет performance lovers!

Утилита GitHub cli упростила мою работу на этой неделе: https://cli.github.com/

Думаю вы слышали истории, что разные инструменты генерируют много кода и так сложно стало делать review кода. Да нет же. Пройти ревью стало сложнее, ведь разные инструменты как Copilot подключились к процессу и они хороши, не очень глубоки, но хороши. Если они что-то заметили, то там вокруг еще много чего поправить стоит и перечитать и переосмыслить

Мне понравилось удалять код — наиболее правильный способ исправить разные несостыковки между документацией и тестом, между тестами в целом. Часто в тестах есть разные уже устаревшие куски которые использовали год назад и их оставили в коде на всякий случай, но этот случай так и не настанет никогда. А теперь Copilot задает вопрос — а почему есть вот такая функция и вот такая, первая не будет работать — и да, не будет, стоит удалить ее вообще

Copilot теперь это мой большой брат (старший), присматривает за порядком

А программирую тесты я в IDEA, в ней работает моя младшая сестренка-помощника Junie, она легко удаляет код, не забывает ничего.

Но мне надо было подключить Junie и IDEA ко всем комментариям которые Copilot оставил на GitHub. Как это сделать?? MCP скажите вы — да нет наверно отвечу я. Уже подключил так много разные MCP, что достиг лимитов. Я еще пробовал использовать Docker Desktop как Hub для MCP — но в нем точно такие же лимиты на количество методов MCP как и везде — 100 методов. Все выглядело так, что как-то передавать комментарии одного агента другому у меня не получится

https://cli.github.com/manual/gh_pr_view
gh pr view [<number> | <url> | <branch>] [flags]

вот эта команда мне помогла соединить все
если я работаю в репозитории который залит на github и в этом же репозитории есть PR с номером 42 то использую вот такую команду

Сначала я пробовал текстовый вид

gh pr view 42

но время от времени он возвращал мне старые результаты без новых комментариев и статусов, из-за кеширования и несогласованности кешей или еще из-за чего-то

И я перешел на JSON-формат, сначала со всеми полями вообще:

/opt/homebrew/bin/gh pr view 42 --json additions,assignees,author,autoMergeRequest,baseRefName,baseRefOid,body,changedFiles,closed,closedAt,closingIssuesReferences,comments,commits,createdAt,deletions,files,fullDatabaseId,headRefName,headRefOid,headRepository,headRepositoryOwner,id,isCrossRepository,isDraft,labels,latestReviews,maintainerCanModify,mergeCommit,mergeStateStatus,mergeable,mergedAt,mergedBy,milestone,number,potentialMergeCommit,projectCards,projectItems,reactionGroups,reviewDecision,reviewRequests,reviews,state,statusCheckRollup,title,updatedAt,url 2>&1


тут полезное поле это
🤩latestReviews — самые свежие комментарии, это стоит передавать
тут самое большое поле это
🤩reviews — все комментарии с историей, если их уже много, то можно это поле убрать

а потом только на часть полей

/opt/homebrew/bin/gh pr view 42 --json number,title,state,body,baseRefName,headRefName,latestReviews 2>&1


И передав такую команду в агента помощницу можно быстро передать в нее контекст по ревью кода. А там уже решить как с комментариями быть — исправлять или дорабатывать и усложнять или удалять и упрощать. А может быть будет сделан вывод — что все нормально и исправлять ничего не нужно

Когда все будет доработано то можно обновить и body (описание) всего PR-а:
/opt/homebrew/bin/gh pr view 42 --json number,title,state,body,reviews 2>&1

вот так можно получить и первоначальное описание и все правки которые были сделаны в ходе ревью и сформулировать обновленное описание.

Если же вы в ходе review делаете небольшие новые git commit с правками и commit message с описаниями доработок, то финальное описание можно будет получить по локальной истории, без походов в github
GitHub CLI Take GitHub to the command line
  • ❤ 4
Post #248 355
Привет performance lovers!

По результатам разборов нескольких недавних задач производительности понял, что

🚩 профессионально читаю логи

Еще профессионально смотрю на метрики, но по ним часто становится понятно, что нужно

🚩 логи почитать

Пока что мне очень нравится такая простота само описания

❓ как бы вы описали свою работу простыми словами

А на видео зеркало озера Seebensee — красивое место

https://www.google.com/search?q=Seebensee
  • ❤ 1
  • 🐳 1
Post #247 440
Привет performance lovers!

Заметил за собой, что у меня нет привычки делать code review

А я сейчас работаю в команде и у нас общий репозиторий со скриптами и фреймворком. И я старший инженер, а значит от меня ожидается быстрое и качественное ревью (также как порядок в задачах, отчетах и других вещах которые становятся привычкой и базовым стандартом работы)

Для привычки завел себе тетрадный листок, там клеточек примерно на месяц

▫️🗓🗓🗓🗓🗓🗓🗓
🗓✔️✔️⭐⭐⭐⭐⭐

Надеюсь через месяц стану мастером ревью

А на видео река Дунай в городе Регенсбург. Красивый город. И там сейчас проходит праздник дультфест (как октоберфест)
  • 🔥 9
Post #246 468
Привет performance lovers!

Знаете почему алерты могут не приходить, когда система под нагрузкой?

Я сделал алерты на базе логов — есть в логах ошибки — приходят алерты. И это исправно работало целый год. Думал я, что исправно. А на той неделе добавил вычисление метрик по логам — количество логов с разными статусами за последнюю минуту стало метрикой. И выяснилось, что метрик нет в моменты высокой нагрузки. И алертов тоже нет в эти моменты

А под нагрузкой логов больше, они кладутся в очередь и начинают попадать в систему анализа логов с задержкой. И в системе анализа логов (OpenSearch) логов нет за последние 3 минуты, 4, … доходит до 6-ти. А проверка выполняется по последней минуте. И в этой минуте проблем не обнаружено 🙈 а они как раз таки есть

🚩🚩〰️〰️〰️📳〰️📳
🚩🚩〰️〰️📳〰️〰️📳
🚩🚩〰️📳〰️〰️〰️📳

Вот когда сделал и метрики по логам за последнюю минуту, то сразу это заметил. В результате и метрики и алерты чуть изменились

Стал собирать метрики за широкое окно:

📳🚩🚩〰️〰️〰️〰️📳

А также собирать метрики из прошлого за узкое окно с разными смещениями:

🚩🚩〰️📳〰️📳〰️〰️
🚩🚩📳〰️📳〰️〰️〰️
🚩📳🚩📳〰️〰️〰️〰️
📳🚩📳〰️〰️〰️〰️〰️

У метрик появились labels:
🟤window
🟤offset

Логика визуализации чуть сложнее стала и логика алертов тоже. Но зато теперь они есть

А на видео горы и кузнечики стрекочут
  • 🔥 6
  • ⚡ 2
Post #245 438
Привет performance lovers!

Научился совмещать занятия нагрузкой и мониторингом. Раньше у меня не получалось, тесты быстро выполнялись и нужно было изучать результаты. Стал делать тесты подольше, на 2 часа. И пока они бегут — можно поработать в Grafana 😄

Не нашлось видео воды, но вот есть видео как дождь падает на озеро. Это вид с вершины горы. В оригинале я там говорю, но с ветер такой сильный, что слышно только порывы ветра. Поэтому наложил звук Infinite Perspective

Лицензия Creative Commons Attribution 4.0 на использование трека Infinite Perspective, исполнитель: Kevin MacLeod: https://creativecommons.org/licenses/by/4.0/
  • 🔥 8
  • ❤ 2
Post #244 451
Привет performance lovers!

Прошла еще одна нагрузочная неделя. У меня получилось разобраться в сборке мусора Go (GOGC: 1000 норм), автоматизировать сбор метрик от эфимерных тестовых стендов (использовал Prometheus Push Gateway и цикл с двумя curl-ами), от души поговорить с коллегами. И вот думаю, что полезного написать? Чтобы пригодилось многим и чтобы это еще не было написано в интернете и модели про это не знали?

Кажется самое интересное что сделал на этой неделе — выбрал в каком кабинете буду работать

Я оказался в интересной ситуации — мои коллеги в Чехии и Польше, а я в Германии. Есть коллеги с которыми часто общаюсь, но рядом с ними нет свободных столов. Это отличный повод выбрать рабочее место самостоятельно.

❓Куда пойти нагрузочнику

Команда производительности IDEA сидит плотно, рядом с ними мест не нашел. Подумал — а может к лучшему, да и я из другого проекта, но было бы круто поработать рядом с ними

Команда автоматизации тестирования тоже сидит плотно (трое в кабинете на троих). Подумал — а может и к лучшему

Стал искать рядом с разработчиками — а разработчиков много, сидят они повсюду, нашел кабинет на шесть мест, где уже знаю трех из пяти человек, а в кабинете напротив еще и дружище работает

В офисе почти все рабочие места в кабинетах заняты, есть некоторое количество пустых, их видно в Envoy. Вот, я открыл карту свободных мест и стал смотреть по карте этажей:

— на какие этажи ходил
— в каких кабинетах был
— где я видел друзей
— где сидит команда
— кого я знаю

И получилось не так много вариантов. А потом написал другу — не будет ли кто против, если перееду к нему? Там простой стол, без тумбочек и полочек, но зато есть вид из окна 🤩 это я люблю. Забронировал пока в Envoy свободный стол на две недели в вперед. Это оказался очень полезный сервис

Итого получается такая рекомендация

✔️ используйте внутренние сервисы чтобы найти свободные столы
✔️ работать рядом с друзьями это хорошая рекомендация
✔️ маленькие мелочи как вид из окна также важны
✔️ эти выборы можно сделать самостоятельно, а если что-то идет не гладко — может это к лучшему

Думаю, что следующая неделя будет еще лучше. Чего и вам желаю 🍀

А на видео водопад, который вытекает из горного озера и переходит в чистейший ручей. Это в городе Garmisch-Partenkirchen. Если кто-то из вас проходит собеседование в YouTrack QA Performance с релокацией в Мюнхен, то напишите, как все получится — рабочее место освободил и все прибрал, красивые места вокруг разведал 🙂
  • ❤ 6
Post #243 402
Привет performance lovers!

Приоткрыл дверь в мир трассировки для себя через Grafana Tempo. Я уже открывал его через Zipkin и Jaeger. А теперь новая глава

Сначала не получалось и было все не так. Надо было заглянуть вглубь в API, в доку и в видео. И как пошло, что уух

Тут столько скрытых бриллиантов! Знакомо ли вам, что сложно ускорять запросы вида

select * from table where id in ($1, …, $1000) and name=$10001


И почти во всех инструментах вы увидите только начало запроса

select * from table where id in ($1, $2, $3

Что позволяет предположить — нужен индекс по полю id. A то что в нем есть часть с

and name=$10001

так и останется тайной — индекс по полям (id, name) без этого знания сложно создать. И в Grafana Tempo точно также, но только в UI. А если скачать трейс — там все есть. И это очень очень круто!!

Хотя бы ради этого стоит попробовать OpenTelemetry и Grafana Tempo

С завершением еще одной нагрузочный недели вас и отличных выходных 🤗
  • ❤ 7
Post #242 447
Привет performance lovers!

Снова выходной. И нашел вам реку с рыбками и лебедями.

Из нового — я стал Performance Engineer-ом, у-хуу. Был экспертом, software engineer-ом, SDET-ом, и вот стал Performance Engineer-ом. Опрос в чате показал, что это одно из самых популярных названий нашей профессии

Отличных вам выходных 😊
  • 🔥 10
  • ❤ 4
Post #241 542
Привет Performance lovers!

❓ Вы запускаете тесты с ноутбука или в CI/CD?
❓ А как вообще лучше?

Кажется я теперь достаточно опытен, чтобы ответить что-то на опытном —
Это зависит от ...


Оказалось, что если я хочу запустить тест на 9 часов или на 19 часов, то в CI/CD такой тест может встретить ограничения
🤩 на длительность работы pipeline (а тест нужен долгий)
🤩 на максимальный объем output-лога, который может вместить запуск (а инструменты нагрузки много чего любят писать в консоль)
🤩 ...

И в таком случае вполне можно
🤩 создать станцию в надежном облаке и запускать тест оттуда (руками)
🤩 или использовать ноутбук и оставить его работать на ночь

Если интернет и VPN стабильны, а нагрузка небольшая, но долгая, то почему бы и да?

У всего есть лимиты, и лимиты CI/CD инструмента тоже есть. Интересная тема. Я как-то не сталкивался с ней, не приходилось. Не делал тесты стабильности огромной длительности и не генерировал тестовые данные через API с 🦆 утками, а вот теперь столкнулся и оказался новичком. А отвечаю на опытном 😄

Пусть тесты крутятся, пойду спать. И вам доброй ночи!
  • 🔥 4
  • ❤ 3
  • 👍 3
Post #240 527
Привет Performance lovers!

Есть ли у вас Performance Review? Как часто это проходит?

Скорее всего есть, да. Скорее всего 1-2 раза в год

Сделал для себя еженедельное ревью и использую начиная с февраля этого года

На фото выше основные блоки такой системы

1️⃣ Как Perf-инженер занимаюсь очень разным, а по роли я SDET-инженер. Поэтому при составлении профиля компетенций взял за основу компетенции для самых разных ролей. В основе SDET, но добавил и SRE и Developer

2️⃣ Чтобы мои компетенции и навыки были актуальными добавил много требований из текстов вакансий. На сайте JetBrains Career коллеги описали уже много всего того что ожидают видеть в своих командах, технологии, приоритеты, решения

3️⃣ Полученные расширенные описания разделил на грейды, мой текущий это Senior 1, а следующий Senior 2 — поэтому им уделил максимальный приоритет

4️⃣ А потом сделал очень простого агента который по очень простому MCP получает тексты задач которые сделал за последнюю неделю и оценивает их на соответствие целям — цели согласованы с руководителем команды в начале года, то что в целях указано, то важно. А что не указано — не важно и стоит обсуждать, если оно появляется в задачах. Целей всего пять. Они написаны в коротком md-файле. Задач за неделю делаю тоже 5-6. Тоже немного текста

5️⃣ Каждую цель-задачу можно выполнять просто выполнив или же хорошо выполнив или же принеся пользу еще и другим командам — если кратко, так примерно и очень в общем разделяются грейды. И есть второй механизм оценки, который берет подробные описания каждого грейда для моей роли и сравнивает результат выполнения задачи с такими критериями. Чтобы это можно было оценить автоматически я стал при выполнении задач писать не просто — Done, а указывать результат, например, процент ускорения, экономию, ... разные метрики которые ранее пропускал — если не постараться и не описать их, то и у других людей не найдется времени этот результат увидеть

💡 Цель такая — делать 80% задач стабильно на текущий грейд и не ниже, а 20% задач делать на следующий грейд, принося пользу другим командам

6️⃣ Есть также очень простой слой-механизм который говорит — что эта задача кажется сделана на уровень Junior/Middle, а вот если бы были в ней вот такие признаки/результаты/... — то она бы была задачей следующего уровня. Получаются рекомендации. Я их читаю и стараюсь применять в задачах которые буду делать на следующей неделе. Выполненные уже не переделываю — что было то было

7️⃣ Все такие микро performance review делаются чтобы в конце года получилось хорошее performance review — получится ли оно хорошим посчитаю по осени, как говорится. А как промежуточный результат — стал гораздо лучше вести задачи, закрывать их быстрее, описывать результаты в них, а не просто выполнять

🔮 Использую для этого модель Google Gemini, она хорошо работает с вызовами MCP и получением моих задач, хорошо сравнивает тексты, выдает результат по шаблону. Стоит это недорого. Для меня ни сколько (у меня есть лимит на токены на месяц, ни разу за него не вышел) — писать код куда затратнее. А возможный экономический эффект от такого может окупить затраты

Тут используется три очень простых агента, у каждого своя роль — цели, оценка результатов по грейдам, оценка результатов оценки и выдача нескольких рекомендаций на следующую неделю. На вход они получают MD-файлы и мои задачи, а на выходе дают другой MD-файл в котором есть таблица а в ней колонка или с галочками — OK/не-OK или примерный Грейд или приоритет того, что стоит улучшить

Если все получится (пожелайте мне удачи 🤗) расскажу подробнее. Но вы такое повторить сможете за вечер. Чтобы организовать три агента/скила в pipeline можете использовать вот такой шаблон — https://github.com/DenisSergeevitch/agents-best-practices — очень удачный шаблон для создания pipeline-ов и согласования работы агентов/скилов
  • 👍 10
  • ❤ 5
  • 🔥 1
Post #238 464
Заметил, что старую сине-фиолетовую рубашку я оставил дома и лет пять уже не носил, да и в Омске давно не был, да и бороду постриг 😊 — в общем много причин было сменить фото

Теперь в другой рубашке, когда встретимся — не перепутаете уже 🤗
  • 🔥 20
  • 🤝 2
Post #237 444
Смотрите что нашел. Это был вечер среды, не было совещаний, я сел рефакторить тесты и выполнил около пяти задач подряд

И у меня вырос уровень энергии, не упал, а вырос

Писал код вместе с Junie, ставил галочки в задачке и amend-ил коммит, который озеленял тесты

Делайте рефакторинг — это заряжает
  • ❤ 6
  • 🤣 1
Post #236 403
Привет Performance lovers!

Сделал раскраску таблицы access logs по принципу — хорошие адреса 💙 синие, 💚 зеленые, 💛 желтые

А вот адреса разных DDoS-еров 💔 красные. Сделал за счет regexp в таблице в Grafana

Сначала вставил в таблицу 2900 правил, получил таблицу весом в 2.4 МБацт — и такая большая доска/таблица отказалась сохраняться в базу данных Grafana

❓ Вы знали что есть лимит на максимальный размер доски — а вот он есть 🤦‍♂️

Поэтому сжал правила — использовал больше правил вида

13.37.*.*


вместо списка правил под каждый диапазон:

13.37.1.*
13.37.2.*
13.37.3.*
…


Так таблица сжалась в 3 раза, доска сжалась тоже и все стало работать быстрее и лучше

Теперь когда смотришь на список источников запросов, то быстро считывается откуда готовилось нападение и было ли оно вообще

Хостеры Web2Objects, UAB code200, Servers.com, … — основные источники проблем производительности. Можно их сразу заблокировать в правилах доступа ваших публичных проектов. Вряд ли ваши клиенты используют эти площадки для работы с вашим API, а вот проблем они создать могут
  • 👍 2
  • 🔥 1
Post #234 370
Привет Performance lovers!

Знаете ли вы что в мире есть 100 млрд типов людей:
1️⃣ Хранят тесты в отдельном репозитории
2️⃣ Хранят тесты вместе с сервисом

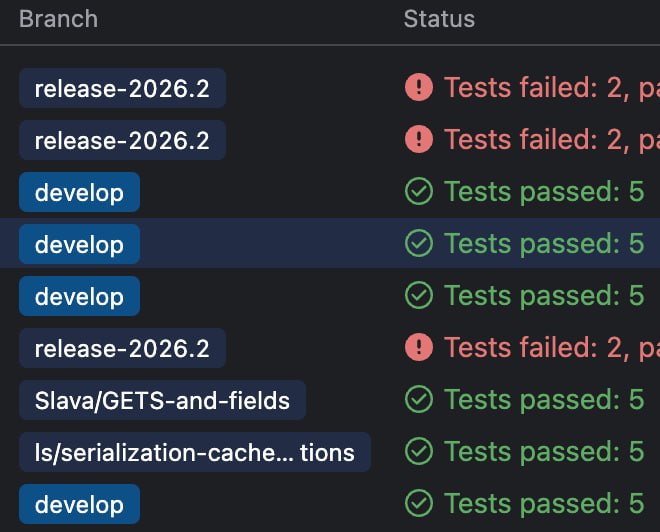
Я был человеком типа 1️⃣, а стал 2️⃣. Все круто, но если сделать правку в самой свежей версии, например, поправить параметры приложения на тестовом стенде, то автоматически эти изменения в предыдущие ветки (релизы) не добавятся

И вот тесты в ветке develop (все последние изменения и продукта и тестов) проходят ✅ отлично, а в ветке release-2026.2 (релизный проект и чуть более старые тесты) изменения не дошли ❗️ нужно еще сделать 🍒 cherry-pick

🎚 Убедиться, что версии актуальны
git fetch origin


🎚 Сделать ветку на базе стабильной ветки (release-2026.2):
git checkout -b fix-perf-tests-2026.2 --no-track origin/release-2026.2

❓ Тут может быть скрытая угроза, когда внешней веткой для локальной fix-perf-tests-2026.2 станет не origin/fix-perf-tests-2026.2, а origin/release-2026.2. И вы очень не хотели бы случайно разломать релиз. Чтобы такой привязки не происходило добавлен флаг --no-track. В целом он не особо нужен для создания веток, но тут он для перестраховки


🍒 Перенести нужный коммит
git cherry-pick -x 89006ee2


Тут могут возникнуть конфликты, например, вы там меняли .gitignore и этот файл .gitignore также был изменен кем-то кто обновлял релизную ветку. У меня получилось, что конфликты в моих же файлах — я их правил

Без 💻 IDEA бы с трудом разбирался в консоли, как верно сделать git cherry-pick --continue — а тут есть удобный диалог. IDEA очень помогает

Можно нажимать Accept Yours (первую кнопку) почти всегда, но бывает интересно нажать Merge ... и посмотреть на изменения еще раз

🎚 Проверить, что все прошло хорошо
git log -n 1
git diff HEAD~1 HEAD --name-only

Что только тесты были перенесены, а не что-то лишнее.

🎚 А потом опубликовать ветку и сделать мерж:
git push -u origin fix-perf-tests-2026.2

❓ Тут для перестраховки явно добавлен флаг -u чтобы в origin точно создалась ветка origin/fix-perf-tests-2026.2, при настройках git по умолчанию такое не требуется, но при некоторых настройках просто git push origin мог бы попробовать залить все сразу в release-2026.2 (смотри предыдущий ❓), это почти никогда не возможно — но тут у нас двойная перестраховка от такого случая

Много плюсов от размещения тестов вместе с проектом, но есть вот такие 🎚 5-7 шагов. В которых есть ❓ нюансы еще.

Может быть вы из тех счастливых людей, что не хранят тесты в репозитории или не пишите их совсем. Но раз вы дочитали до этой строки, то буду надеяться на полезность этой заметки 😊
  • 🔥 3
Older posts →

About this channel

How can I read @qaload without a Telegram account?
TGViewer shows the public web preview Telegram publishes for 📢 Load & Performance: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does 📢 Load & Performance have?
📢 Load & Performance (@qaload) has 935 subscribers on Telegram, refreshed roughly every 30 minutes.
Does 📢 Load & Performance know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →