Всё самое интересное из мира Python
Сотрудничество, реклама: @devmangx
Работаем с @Spiral_Yuri
РКН: https://clck.ru/3GMMF6
Post #5548
8K
 PY
@pythonportal
Showing posts older than #5549 · Back to latest
Counter из модуля collections. Counter() вернет словарь с тем, сколько раз каждый элемент встречается в последовательности. Допустим, мы хотим узнать, сколько раз имя Peter встречается в следующем списке. Можно использовать Counter(). См. ниже:from collections import Counter
list1 = ['John', 'Kelly', 'Peter', 'Moses', 'Peter']
count_peter = Counter(list1).get("Peter")
print(f'The name "Peter" appears in the list '
f'{count_peter} times.')
The name "Peter" appears in the list 2 times.
for. Мы заводим переменную-счетчик и увеличиваем ее на 1 каждый раз, когда находим имя Peter в последовательности. Это наивный способ. См. ниже:list1 = ['John', 'Kelly', 'Peter', 'Moses', 'Peter']
# Create a count variable
count = 0
for name in list1:
if name == 'Peter':
count +=1
print(f'The name "Peter" appears in the list'
f' {count} times.')
The name "Peter" appears in the list 2 times.
count(), который позволяет посчитать количество вхождений конкретного элемента. Мы можем использовать count(), чтобы посчитать, сколько раз Peter встречается в списке.list1 = ['John', 'Kelly', 'Peter', 'Moses', 'Peter']
print(f'The name "Peter" appears in the list '
f'{list1.count("Peter")} times.')
The name "Peter" appears in the list 2 times.

20 переменной x и 30 переменной y, а потом меняем их местами: x становится 30, а y становится 20. Этот способ называется упаковкой и распаковкой кортежа (tuple packing/unpacking).x, y = 20, 30
x, y = y, x
print('x is: ', x)
print('y is: ', y)
x is 30
y is 20
x и y.x = 20
y = 30
# шаг первый
x ^= y
# шаг второй
y ^= x
# шаг третий
x ^= y
print(f'x is: {x}')
print(f'y is: {y}')
x is: 30
y is: 20
# Используем арифметические операции
x = 5
y = 10

x = x + y
y = x - y
x = x - y

print("After swapping:")
print("x =", x)
print("y =", y)
After swapping:
x = 10
y = 5
x и y были фактически поменяны местами. После обмена x содержит исходное значение y (10), а y содержит исходное значение x (5).
if obj == None, используйте if obj is Noneobj == None
obj значением None. Вместо этого вы спрашиваете, равен ли объект None.obj is None
obj == None
__eq__ у объекта. То есть сам объект решает, что значит "равен None". А этот метод можно переопределить.obj это экземпляр класса, в котором __eq__ реализован так, что при сравнении с None возвращается True (даже если объект на самом деле не None), тогда obj == None может ошибочно дать True.class Weird:
def __eq__(self, other):
return True # Всегда утверждает, что равен
obj = Weird()
print(obj == None) # True
print(obj is None) # False
obj == None возвращает True из-за кастомного поведения оператора __eq__ в классе.obj == None результат не всегда предсказуем.obj is None
is, который нельзя переопределить. Это значит, что результат всегда будет одинаковым и предсказуемым.is проверяет идентичность объектов, то есть указывают ли две ссылки на один и тот же объект. Поскольку None это singleton (единственный экземпляр), obj is None это правильный и самый эффективный способ такой проверки.obj is None вместо obj == None ради предсказуемости и эффективности.sort() сортирует список по возрастанию (по умолчанию).sort() работал, элементы списка должны быть одного типа. Нельзя сортировать список со смешанными типами данных, например числа и строки.sort() есть параметр reverse; чтобы отсортировать список по убыванию, установите reverse=True.list1 = [2, 5, 6, 8, 1, 8, 9, 11]
list1.sort(reverse=True)
print(list1)
# [11, 9, 8, 8, 6, 5, 2, 1]
sort() это строго метод списка (list). Его нельзя использовать для сортировки set, tuple, string или dictionary.sort() не возвращает новый список; он сортирует существующий список на месте (in place).sort(), он вернет None. Пример ниже:list1 = [2, 5, 6, 8, 1, 8, 9, 11]
list2 = list1.sort(reverse=True)
print(list2)
# None
sort() есть необязательный параметр key, который позволяет настроить поведение сортировки.key вместе с lambda-функцией, можно реализовать такую кастомную сортировку. См. ниже:students = [
("Alice", 22),
("Bob", 20),
("Charlie", 24)
]
# Сортируем студентов по возрасту, используя lambda-функцию как key
students.sort(key=lambda students: students[1])
print(students)
# [('Bob', 20), ('Alice', 22), ('Charlie', 24)]
sort() является стабильным (stable), то есть сохраняет относительный порядок равных элементов в отсортированном списке."Alice" и "Bob" одинаковый возраст, их порядок останется прежним. Это и называется стабильной сортировкой (stable sorting). См. пример:students = [
("Alice", 22),
("Bob", 22),
("Charlie", 24)
]
# Сортируем студентов по возрасту, используя lambda-функцию как key
students.sort(key=lambda students: students[1])
print(students)
# [('Alice', 22), ('Bob', 22), ('Charlie', 24)]
"Alice" и "Bob" не изменился, потому что у них одинаковый возраст.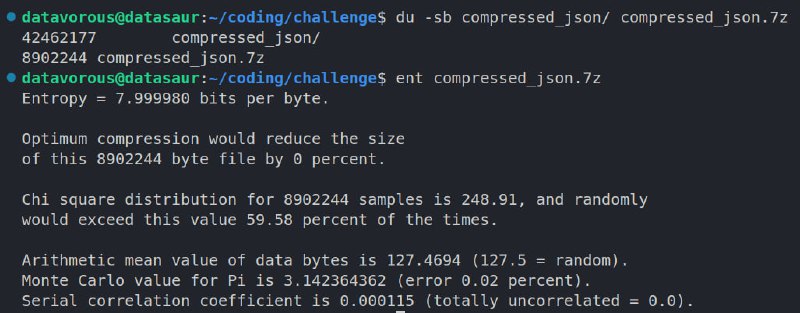
gzip, это ~53 МБ, а 7z ~45 МБ.7z и ужал до 8,9 МБdatetime. Метод now() возвращает объект datetime, представляющий текущие дату и время в соответствии с системными часами. Метод strftime() форматирует время для нужного вывода. Этот код показывает, как использовать модуль datetime вместе с методом strftime(), чтобы получить отформатированную строку времени в формате часов, минут и секунд.from datetime import datetime
time_now = datetime.now().strftime('%H:%M:%S')
print(f'Текущее время: {time_now}')
Текущее время: 17:37:28
date из модуля datetime. Ниже используется метод today():from datetime import date
today_date = date.today()
print(today_date)
2023-09-20
calendar. Мы можем импортировать этот модуль, чтобы вывести календарь. С календарём можно делать много разных вещей.month из модуля calendar и передадим год и месяц в качестве аргументов. См. ниже:import calendar
month = calendar.month(2022, 4)
print(month)
calendar. Например, с его помощью можно проверить, является ли заданный год високосным или нет. Давай проверим, високосный ли 2022 год.import calendar
month = calendar.isleap(2022)
print(month)
False

@pydantic будет заниматься JSON-сериализацией на стороне Rust 🦀|) или оператор (**). Ниже у нас есть два словаря: first_dict и second_dict. Мы будем использовать эти два метода, чтобы объединить словари. Вот код:|)first_dict = {"kelly": 23,
"Derick": 14, "John": 7}
second_dict = {"Ravi": 45, "Mpho": 67}
combined_dict = first_dict | second_dict
print(combined_dict){'kelly': 23, 'Derick': 14, 'John': 7, 'Ravi': 45, 'Mpho': 67}**)*. Оба словаря заключены в фигурные скобки и разделены запятой.first_dict = {"kelly": 23,
"Derick": 14, "John": 7}
second_dict = {"Ravi": 45, "Mpho": 67}
combined_dict = {**first_dict, **second_dict}
print(combined_dict){'kelly': 23, 'Derick': 14, 'John': 7, 'Ravi': 45, 'Mpho': 67}