TGViewer
Channel Public Channel
Python Portal

Python Portal

@pythonportal

Всё самое интересное из мира Python

Сотрудничество, реклама: @devmangx

Работаем с @Spiral_Yuri

РКН: https://clck.ru/3GMMF6
Subscribers
50.2K
Photos
2.9K
Videos
488
Links
1.3K

Showing posts older than #5405 · Back to latest

Older Posts 19 shown
Post #5404 8.22K
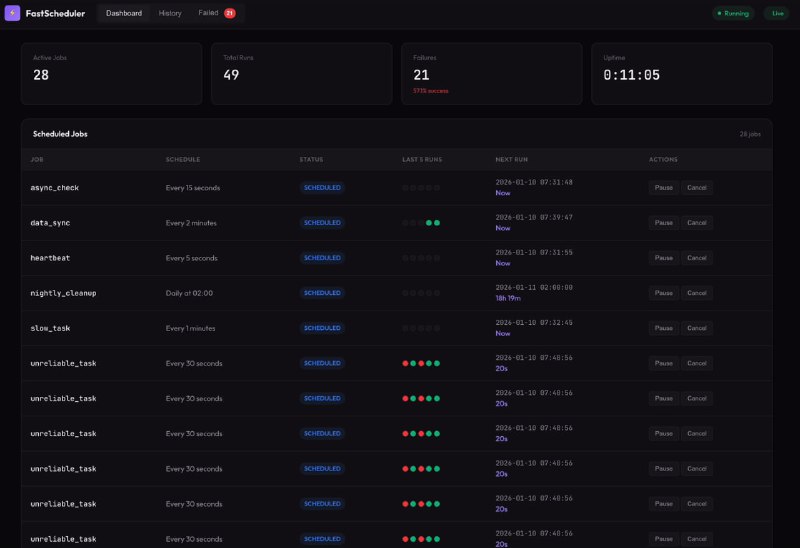
Писать планировщик задач на Python через стандартную библиотеку хоть и просто, но возможностей там немного. Как только появляются асинхронные задачи, работа с таймзонами, ретраи при фейлах и похожие кейсы, становится тяжко. 😢

На GitHub нашел FastScheduler, это опенсорсный легковесный таск-планировщик для Python. Поддерживает async, таймзоны, Cron-выражения и еще имеет визуальную панель.

За счет очень аккуратного синтаксиса на декораторах задачу можно описать одной строкой. Есть разные варианты расписаний: интервалы, конкретное время, Cron и т.д. Асинхронные функции работают из коробки.

Установка через pip в один шаг, а для персистентности доступны разные хранилища вроде SQLite и PostgreSQL. После рестарта сервиса состояние задач не теряется.

👉 @PythonPortal
  • ❤ 17
  • 👍 8
  • 🔥 3
Post #5402 9.11K
Как вам эти 30 незаменимых приемов при программировании на Python 🤭

👉 @PythonPortal
  • ❤ 46
  • 🔥 30
  • 👍 8
Post #5401 8.85K
инженеры смотрят, как все остальные вайб-кодят приложения

👉 @PythonPortal
  • 😁 67
  • 👍 28
  • 🤣 15
  • ❤ 5
  • 🔥 1
Post #5400 9.12K
Этот чувак буквально за 6 минут объясняет, как с нуля собрать алгоритмический хедж-фонд для трейдинга. Я видел, как команды годами до этого доходят.

Жесть 🙌

👉 @PythonPortal
  • 👍 39
  • ❤ 8
  • 🔥 6
Post #5399 8.73K
Библиотека алгоритмов по робототехнике, которую должен знать каждый инженер📚

PythonRobotics это open-source коллекция Python-кода и учебник по алгоритмам робототехники, сделанные Atsushi Sakai.

На GitHub у проекта 27.2k звёзд и 7k форков, так что добавить в закладки вообще без вариантов

Там покрыто всё: от локализации (EKF, particle filters, histogram filters) до SLAM (FastSLAM, ICP matching), планирования пути (A*, RRT*, Dijkstra, D*, potential fields, state lattice), трекинга траектории (Stanley, LQR, MPC), навигации манипуляторов, воздушной навигации и даже планирования для двуногих роботов.

Что в нём особенного? Он сделан так, чтобы его было легко читать и понимать: минимум зависимостей и практичные, широко используемые алгоритмы.

Каждый алгоритм идёт с визуальными анимациями, математическими объяснениями и рабочим кодом.

Документация по сути это полноценный учебник по алгоритмам робототехники, бесплатно доступный онлайн.

Требования простые: Python 3.13+, NumPy, SciPy, Matplotlib и cvxpy.

И всё.

Это учебный ресурс с 2,201 коммитом, вкладом от 138 разработчиков и активной поддержкой. Одни только анимации (они лежат в отдельном репозитории) уже стоят того, чтобы их изучать.

Если ты учишь робототехнику, собираешь автономные системы или преподаёшь алгоритмы, это тот самый ресурс. Лицензия MIT, так что можно свободно использовать и в исследованиях, и в коммерческих проектах.

Ссылка:

https://github.com/AtsushiSakai/PythonRobotics


P.S. Вот как выглядит хороший open-source: образовательный, практичный, отлично задокументированный и комьюнити-драйвовый. Добавь в закладки. 🔖

👉 @PythonPortal
  • 👍 22
  • ❤ 8
Post #5398 8.11K
Когда оперативка бесконечная

👉 @PythonPortal
  • 😁 84
  • 👍 24
  • 🤯 18
  • 💊 4
  • 😢 3
  • ❤ 2
Post #5396 8.28K
Задеплой любую ML-модель как MCP-сервер.

LitServe: самый простой способ выкатывать агентов, RAG и вообще любые ML-модели. Теперь есть поддержка MCP.

Полностью open-source.

👉 @PythonPortal
  • ❤ 11
  • 👍 7
Post #5395 8.67K
Клонируй любой голос по 5-секундному аудиоклипу.

VoxCPM это open-source проект, который делает TTS принципиально иначе.

большинство TTS-систем сначала переводят речь в дискретные токены. это становится бутылочным горлышком и ограничивает, насколько “живым” может быть звук.

VoxCPM вообще пропускает токенизацию. он моделирует аудио в непрерывном пространстве через end-to-end diffusion autoregressive архитектуру.

в итоге получается речь, которая реально звучит по-человечески.

вот что в нем особенного:

> контекстно-зависимая генерация: читает текст и сам подбирает нужную просодию, эмоцию и темп. ручной тюнинг не нужен.

> zero-shot клонирование голоса: даешь короткий аудиоклип, и он ловит не только тембр, но и акцент, ритм и эмоциональный окрас.

модель обучали на 1.8 млн часов билингвальных данных (английский и китайский)

* поддерживает streaming synthesis
* работает и с full fine-tuning, и с LoRA
* простой Python API: pip install voxcpm

VoxCPM1.5 гоняет на 44.1kHz sampling rate и имеет 800M параметров. поэтому звук заметно более четкий и натуральный.

лицензия Apache-2.0

👉 @PythonPortal
  • ❤ 13
  • 💊 6
  • 👍 3
  • 😢 1
Post #5393 9.51K
Теперь можно парсить почти любой документ одной моделью на 1.7B параметров.

Она называется dots-ocr. Одна система, которая умеет работать с текстом, таблицами, формулами, изображениями и PDF на 100+ языках.

Без отдельного OCR-пайплайна. Без моделей под конкретные задачи.

100% исходный код 👏

👉 @PythonPortal
  • ❤ 33
  • 👍 9
Post #5392 8.4K
Расширенный алгоритм Евклида.

1) Что такое расширенный алгоритм Евклида


Для двух целых чисел a и b и их НОД, то есть gcd(a, b), выполняется линейное уравнение с двумя переменными:

a·x + b·y = gcd(a, b) (1)

Расширенный алгоритм Евклида это способ найти одну пару целочисленных решений (x, y), которая удовлетворяет (1).

2) Алгоритм расширенного алгоритма Евклида

Перед тем как перейти к сути, вспомним обычный алгоритм Евклида.

Для двух целых a и b следующими шагами получаем:

gcd(a, b) = rₙ (2)

Сама цепочка делений с остатком:

a = b·q₀ + r₀
b = r₀·q₁ + r₁
r₀ = r₁·q₂ + r₂
...
rₙ₋₂ = rₙ₋₁·qₙ + rₙ
rₙ₋₁ = rₙ·qₙ₊₁

Теперь посмотрим на первую строку:

a = b·q₀ + r₀
r₀ = a − b·q₀

То есть r₀ можно выразить как линейную комбинацию a и b.

Подставим это во вторую строку:

b = r₀·q₁ + r₁
b = (a − b·q₀)·q₁ + r₁
b = a·q₁ − b·q₀·q₁ + r₁
r₁ = −a·q₁ + b·(q₀·q₁ + 1)

Получается, r₁ тоже выражается через a и b.

Если повторять эту операцию, то каждый rᵢ (0 ≤ i ≤ n) можно представить как сумму кратных a и b.
Значит, в конце:

rₙ = k·a + l·b

А из (2) получаем:

k·a + b·l = gcd(a, b) (3)

Это та же форма, что и (1). Сравнивая (1) и (3), получаем:

(x, y) = (k, l)

и эти k и l будут одной из пар целочисленных решений.

3) Реализация расширенного алгоритма Евклида

Опираясь на вышеописанное, реализуем расширенный алгоритм Евклида:

# extended_eucledean.py
def extended_eucledean(a, b):
if b == 0:
return (1, 0)
else:
xd, yd = extended_euclid(b, a % b)
return (yd, xd - a // b * yd)


Очень просто, правда?

Ну всё. Пока. 🛌

👉 @PythonPortal
  • 🔥 19
  • 🤯 9
  • ❤ 8
  • 👍 3
  • 🤣 2
Post #5391 8.18K
Обесценивание профессии "инженер":

👉 @PythonPortal
  • 🤣 90
  • 👍 6
  • ❤ 2
  • 🔥 2
  • 👀 1
Post #5390 8.27K
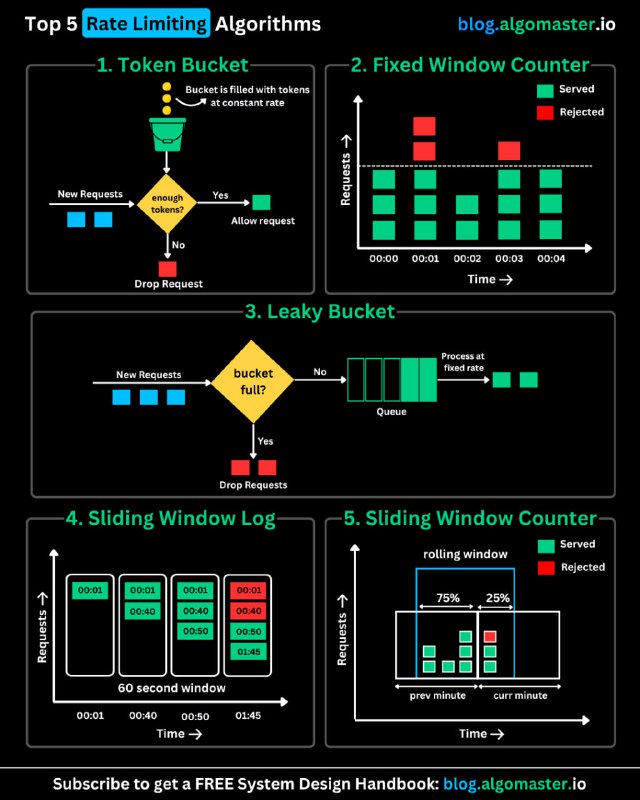
Топ-5 алгоритмов rate limiting, которые стоит знать:

➡️Token Bucket
Ведро пополняется токенами с фиксированной скоростью. Каждый запрос съедает 1 токен.
Если токенов нет (ведро пустое) -> запрос троттлится.
Отлично, когда надо разрешить короткие всплески, но держать среднюю скорость запросов.

➡️Fixed Window Counter
Делит время на фиксированные окна (например, по минуте).
Считает запросы в текущем окне. Если счётчик превысил лимит -> блок.
Просто внедрить, но есть проблема со всплесками на границах окон.

➡️Leaky Bucket
Представь очередь, которая “протекает” с постоянной скоростью.
Если новые запросы переполняют очередь -> они дропаются.
На выходе получается ровный, предсказуемый поток запросов.

➡️Sliding Window Log
Хранит timestamp для каждого запроса.
На каждый новый запрос выкидывает старые timestamp’ы за пределами окна и считает оставшиеся.
Очень точно, но дороговато по памяти на больших объёмах.

➡️Sliding Window Counter
Гибрид Fixed Window и Log.
Делит окно на мелкие бакеты и считает скорость через взвешенную сумму.
Хороший баланс точности и расхода памяти.

Какой из них вы чаще всего используете в проде?

👉 @PythonPortal
  • 👍 11
  • ❤ 7
  • 😁 1
Post #5389 9.4K
Лучшие репозитории GitHub для изучения ИИ с нуля в 2026 году:

1. Андрей Карпаты
https://github.com/karpathy/nn-zero-to-hero

2. Hugging Face Transformers
https://github.com/huggingface/transformers

3. FastAI/fastb
https://github.com/fastai/fastbook

4. Made-With-ML
https://github.com/GokuMohandas/Made-With-ML

5. ML System Design
https://github.com/chiphuyen/machine-learning-systems-design

6. Awesome Generative AI guide(
https://github.com/aishwaryanr/awesome-generative-ai-guide

7. Dive into Deep Learning
https://github.com/d2l-ai/d2l-en

👉 @PythonPortal
  • ❤ 12
  • 👍 3
Post #5388 9.84K
Когда джун всё таки переписал проект на своём языке

👉 @PythonPortal
  • 😁 131
  • ❤ 13
  • 👍 1
Post #5387 9.45K
Коллекция книг по машинному обучению и искусственному интеллекту в формате PDF: забираем

👉 @PythonPortal
  • ❤ 18
  • 👍 2
Post #5386 9.55K
Что если бы ты мог увидеть всё дерево зависимостей одной командой?

Отлаживать конфликты версий можно только когда понимаешь, какие пакеты от чего зависят. Но вручную разбирать эти связи в куче вложенных зависимостей это уныло и долго.

uv tree делает это автоматически: выводит полный граф зависимостей, чтобы ты мог отследить любой пакет и понять, откуда он подтянулся.

Ключевые возможности:

✅Полная визуализация зависимостей
✅Помечает зависимости, для которых есть доступные обновления
✅Показывает, какие пакеты зависят от конкретной библиотеки
✅Фильтрует дерево, чтобы показать только зависимости выбранного пакета

Установка uv: pip install uv

👉 @PythonPortal
  • ❤ 20
  • 🔥 2
Post #5384 9.13K
В CPython ускорили reference counting

В CPython основа управления памятью это reference counting: у каждого объекта есть счётчик ссылок, и при каждом “взял/отпустил” он инкрементится/декрементится. В цикле, который крутится очень много раз, это превращается в ощутимый оверхед и лишние записи в память (да, даже чтение переменной = запись из-за refcount).

С Python 3.14 добавили новую байткод-инструкцию: LOAD_FAST_BORROW.

Что меняется:

- раньше LOAD_FAST грузил локалку и поднимал refcount
- теперь LOAD_FAST_BORROW грузит локалку без инкремента
- есть ещё “склеенные” опкоды типа LOAD_FAST_BORROW_LOAD_FAST_BORROW (две загрузки за один opcode)

Зачем это нужно:

- меньше дергаем refcount в hot-path
- меньше мусора в CPU cache
- быстрее на циклах, где ты постоянно читаешь одни и те же локальные переменные

Но оптимизация включается не всегда. CPython применяет её только когда может доказать безопасность через статический анализ времени жизни (по CFG):

- значение используется “локально” и быстро потребляется
- не утекает в heap/генераторы/кадры
- источник не перезаписывается так, чтобы сломать “borrow”

Это похоже на упрощённые Rust lifetimes/borrowing, только на уровне байткода.

👉 @PythonPortal
  • 👍 20
  • ❤ 9
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →