
Meta недавно закрыла одну из самых больших болей в RAG
Большинство RAG-систем просто жгут бюджет. Они вытаскивают 100 чанков, когда тебе реально нужно 10. Они заставляют LLM переваривать тысячи нерелевантных токенов. В итоге ты платишь за вычисления, которые вообще не нужны.
Meta AI это порешали.
Они сделали REFRAG, новый подход к RAG, который сжимает и фильтрует контекст еще до того, как он попадет в LLM. Результаты звучат дико:
▪️в 30.85 раза быстрее time-to-first-token
▪️контекстные окна в 16 раз больше
▪️в 2-4 раза меньше обрабатываемых токенов
▪️обгоняет LLaMA на 16 RAG-бенчмарках
Чем REFRAG отличается:
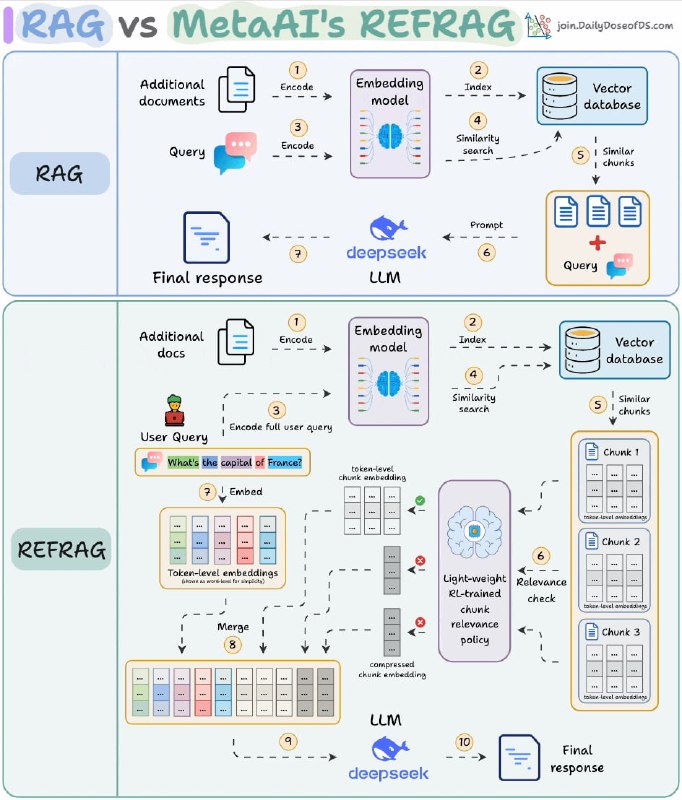
Классический RAG просто сваливает все в LLM. Каждый чанк. Каждый токен. Даже мусор, который не по делу.
А REFRAG работает на уровне эмбеддингов:
↳ сжимает каждый чанк в один эмбеддинг
↳ RL-политика (обученная через reinforcement learning) скорит каждый чанк по релевантности
↳ только лучшие чанки разворачиваются и отправляются в LLM
↳ остальное остается сжатым или вообще отфильтровывается
То есть LLM обрабатывает только то, что реально важно.
Пайплайн простой:
1. Закодируй документы и сохрани их в векторной базе
2. Когда приходит запрос, как обычно достань релевантные чанки
3. RL-политика оценивает сжатые эмбеддинги и выбирает лучшие
4. Выбранные чанки разворачиваются в полные token-эмбеддинги
5. Отклоненные чанки остаются одиночными сжатыми векторами
6. Все вместе уходит в LLM
Итог: можно прогонять в 16 раз больше контекста в 30 раз быстрее без потери точности.
Ссылка на доки
👉 @PythonPortal
Post #5498
7.33K
- 🔥 30
- ❤ 8
- 👍 4