


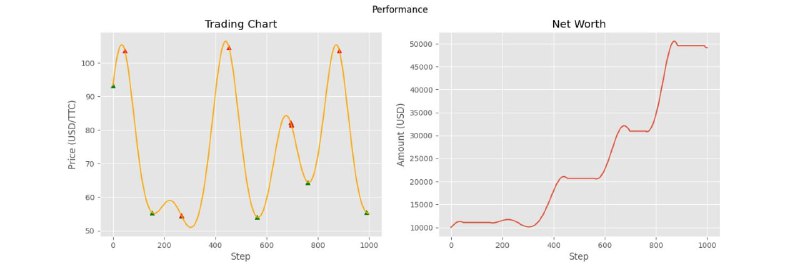
Представляют TensorTrade — опенсорсный Python-фреймворк для трейдинга на базе обучения с подкреплением (RL / AI).
По словам Quant Science :
TensorTrade — это фреймворк для сборки, обучения, оценки и деплоя торговых стратегий на RL, использующий стек:
- numpy
- pandas
- gym
- keras
- tensorflow
Пример: обучение и оценка стратегии с Reinforcement Learning
Шаг 1: формируем датасеты для тренировки и валидации
Готовим два CSV, один под обучение, второй под тест.
import yfinance
import pandas_ta  #noqa

TICKER = 'ITRD'  # TODO: подставь свой тикер
TRAIN_START_DATE = '2021-02-09'  # TODO: замени на свою дату начала обучения
TRAIN_END_DATE = '2021-09-30'    # TODO: замени на свою дату конца обучения
EVAL_START_DATE = '2021-10-01'   # TODO: замени на свою дату начала валидации
EVAL_END_DATE = '2021-11-12'     # TODO: замени на свою дату конца валидации

yf_ticker = yfinance.Ticker(ticker=TICKER)

# Загружаем данные для обучения
df_training = yf_ticker.history(start=TRAIN_START_DATE, end=TRAIN_END_DATE, interval='60m')
df_training.drop(['Dividends', 'Stock Splits'], axis=1, inplace=True)
df_training["Volume"] = df_training["Volume"].astype(int)

# Технические индикаторы
df_training.ta.log_return(append=True, length=16)
df_training.ta.rsi(append=True, length=14)
df_training.ta.macd(append=True, fast=12, slow=26)

df_training.to_csv('training.csv', index=False)

# Загружаем данные для оценки
df_evaluation = yf_ticker.history(start=EVAL_START_DATE, end=EVAL_END_DATE, interval='60m')
df_evaluation.drop(['Dividends', 'Stock Splits'], axis=1, inplace=True)
df_evaluation["Volume"] = df_evaluation["Volume"].astype(int)

# Те же индикаторы для оценки
df_evaluation.ta.log_return(append=True, length=16)
df_evaluation.ta.rsi(append=True, length=14)
df_evaluation.ta.macd(append=True, fast=12, slow=26)

df_evaluation.to_csv('evaluation.csv', index=False)
Шаг 2: конфигурация
В конфиг-словарь кладём нужные параметры, включая имя CSV, который будем читать. (3 скрин)
Шаг 3: запуск через Ray
Инициализируем Ray, пробрасываем параметры и имя функции, создающей окружение (create_env из примера выше), и запускаем пайплайн. (4 скрин)
Дальше: Reward Agents
Reward Agents позволяют интегрировать систему вознаграждений, чтобы агент оптимизировал стратегию под конкретную метрику (например, прибыль). По сути, это даёт нормальный цикл RL-тюнинга под реальные цели. (5 скрин)
Какой следующий шаг, если хочется заняться этим по-серьёзке?
- разобраться с базой и посмотреть, как собирали свой хедж-фонд на Python
👉 @PythonPortal