pdfplumber - это библиотека Python для извлечения информации из PDF-документов. Она предоставляет простой в использовании интерфейс для извлечения текста, таблиц и изображений из PDF-файлов. Также вы можете извлекать таблицы из PDF в виде объектов pandas DataFrame, извлекать изображения из PDF и извлекать метаданные о PDF-документе.
В этом примере мы используем функцию pdfplumber.open() для открытия PDF-файла example.pdf.
Внутри оператора with мы перебираем все страницы PDF-файла с помощью цикла for. Для каждой страницы мы вызываем метод extract_text() для извлечения текстового содержимого. Извлеченный текст сохраняется в переменной text.
Выполнив этот код, вы сможете извлечь и распечатать текстовое содержимое каждой страницы PDF-файла.
Стоит отметить, что pdfplumber является мощным инструментом, но точность извлеченного текста сильно зависит от качества и форматирования самого PDF.
Один из способов узнать количество определенных букв в строке максимально быстрым методом – использовать метод count для строки. Этот метод принимает символ или подстроку и возвращает количество их вхождений в строку.
Этот метод является достаточно быстрым, так как использует внутренние оптимизации CPython, которые работают на низком уровне. Он также не требует дополнительной памяти, за исключением простой переменной, используемой для хранения результата.
Для перевода формата аудио из mp3 в mov вам понадобится использовать специализированные библиотеки для обработки аудио файлов в Python. Одной из таких библиотек является FFmpeg.
В этом примере мы используем функцию input() из библиотеки ffmpeg для указания входного файла, а затем функцию output() для указания выходного файла. Затем мы запускаем процесс конвертации с помощью функции run().
Исполняемый файл — это файл, который может быть установлен или запущен на компьютере без использования дополнительного программного обеспечения или библиотек.
Быстрая сортировка (quicksort) — это один из наиболее известных и широко применяемых алгоритмов сортировки. Она основана на использовании стратегии "разделяй и властвуй".
В этом коде мы выбираем элемент в середине списка в качестве "опорного". Затем мы создаем три списка: один для элементов меньше опорного, один для элементов равных опорному, и один для элементов больше опорного.
Мы рекурсивно применяем быструю сортировку к списку элементов, которые меньше и больше опорного элемента. Это продолжается до тех пор, пока не останется список, который нужно сортировать. В конце, мы объединяем отсортированные списки вместе.
Библиотека argparse является стандартным инструментом для обработки аргументов командной строки в Python. Она позволяет легко определить и обработать аргументы, передаваемые программе при запуске из командной строки.
В данном примере мы просто выводим значения аргументов на экран, но в реальном приложении вы можете использовать их для выполнения конкретных действий, например, чтения входного файла, обработки данных и записи результата в выходной файл.
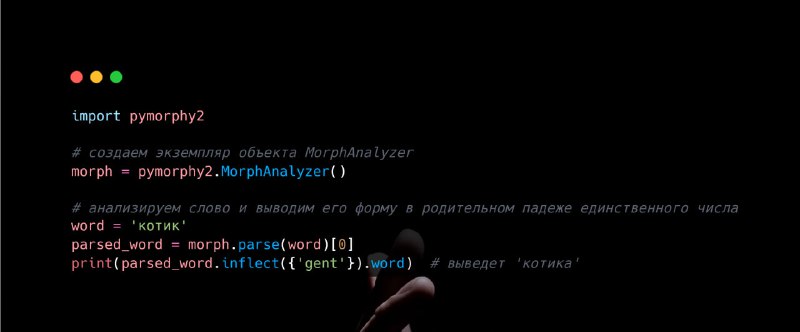
Pymorphy2 - это библиотека для морфологического анализа слов русского языка. С помощью Pymorphy2 можно определить различные грамматические характеристики слова (род, число, падеж, время и т. д.), а также получить его нормальную форму (лемму).
В этом примере мы создаем экземпляр объекта MorphAnalyzer и анализируем слово "котик". Затем мы используем метод parse, чтобы получить различные грамматические характеристики слова, и выводим его форму в родительном падеже единственного числа с помощью метода inflect. Результат выводится в консоль.

 PY