
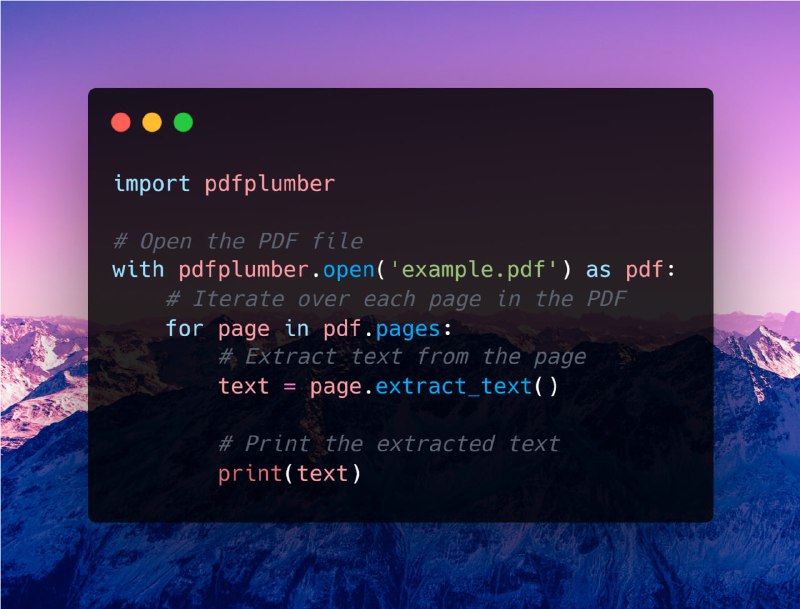
pdfplumber - это библиотека Python для извлечения информации из PDF-документов. Она предоставляет простой в использовании интерфейс для извлечения текста, таблиц и изображений из PDF-файлов. Также вы можете извлекать таблицы из PDF в виде объектов
pandas DataFrame, извлекать изображения из PDF и извлекать метаданные о PDF-документе.В этом примере мы используем функцию
pdfplumber.open() для открытия PDF-файла example.pdf.Внутри оператора
with мы перебираем все страницы PDF-файла с помощью цикла for. Для каждой страницы мы вызываем метод extract_text() для извлечения текстового содержимого. Извлеченный текст сохраняется в переменной text.Выполнив этот код, вы сможете извлечь и распечатать текстовое содержимое каждой страницы PDF-файла.
Стоит отметить, что pdfplumber является мощным инструментом, но точность извлеченного текста сильно зависит от качества и форматирования самого PDF.