TGViewer
Python Learning Python Learning @python_per_month · 28.1K subscribers
Post #1416 6.95K
Beautiful soup

Когда вы вытаскиваете HTML с какого-то сайта, то сначала проводите его разбор и отсекаете все ненужное. Beautiful Soup — это Python-библиотека по сбору данных из HTML и XML-файлов. В ней представлены простые методы для навигации, поиска и парсинга. Это очень мощная библиотека, которая умеет обрабатывать все виды HTML, даже если он сломан. Уж поверьте моему опыту, HTML ломается довольно часто, поэтому такая функция окажется как нельзя кстати.

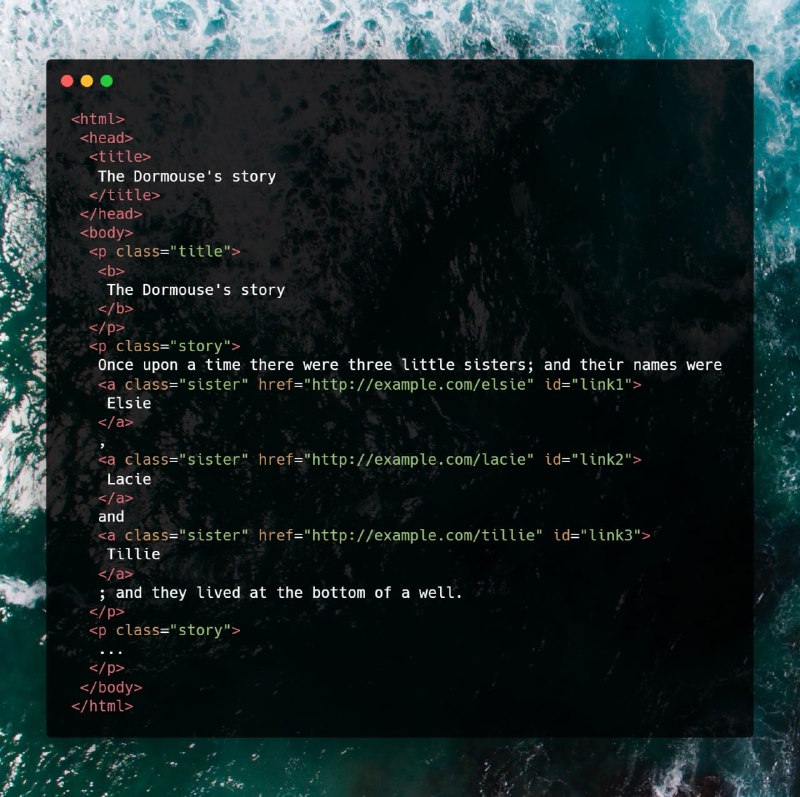
Beautiful Soup парсит все, что захотите. С его помощью вы, например, можете вытащить все ссылки или найти заголовок таблицы, выделенный жирным. На первой картинке приведен HTML, а на второй - несколько примеров работы с ним. Документация доступна по ссылке.
  • 👍 30
  • 🏆 7
  • ❤ 2
  • 😢 2
  • 🤔 1
More from @python_per_month
  1. Sep 14, 2026➡️ Memray — профилирование памяти для Python Memray — это современный инструмент для профи…
  2. Aug 17, 2026Срезы Срезы (slices) в Python — это способ получения подстроки (подсписка) из последовател…
  3. Aug 11, 2026Нейросеть, LLM (большие языковые модели) и ИИ-агент Эти слова в разговорах часто использую…
  4. Jul 23, 2026👩‍💻 Задача по Python Создайте функцию find_longest_substring для поиска самой длинной по…
  5. Jul 13, 2026🔥 Три разных человека. Три разных проекта. Один и тот же подход. — Юра взял «скучную» ниш…
  6. Jul 11, 2026⚙️ enumerate() Когда тебе нужно итерировать по списку с доступом к индексу элемента, испол…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →