TGViewer
Python Community Python Community @python_community_ru · 11.6K subscribers
Post #916 3.86K
⚡️ Собираем информацию с сайтов

Для этого часто используются роботы, а основой для их создания может послужить scrapy.

Установка:
pip install scrapy

Первым делом, нам нужно подготовить проект. Вводим в терминал scrapy startproject name, где на место name вводим имя будущей папки.

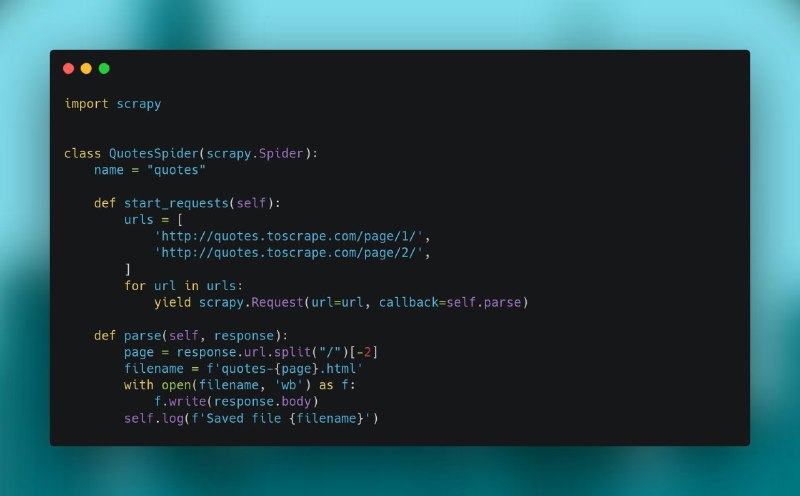
Окей, теперь создаём quotes_spider.py в name/spiders. Далее вводим туда код из примера выше (его можно найти тут).

Теперь просто запускам «паучка »с помощью scrapy crawl quotes и наблюдаем за результатом.

#миниурок #scrapy
More from @python_community_ru
  1. Oct 14, 2026📱 35 млрд параметров на смартфоне с потреблением около 3 ГБ оперативной памяти. OpenBMB п…
  2. Oct 12, 2026⚡️ Overmind - open-source слой для автоматической оптимизации AI-агентов. Вместо ручного т…
  3. Oct 12, 2026‍🖥 Python-дайджест недели: агенты с онтологией, рантайм-проверка типов и SQLite в проде С…
  4. Oct 10, 2026‍🐍 Ротация прокси в Python может обходиться без списка IP и `random.choice()` Если провай…
  5. Oct 9, 2026‍Вышел Python 3.15: ленивые импорты, frozendict, UTF-8 по умолчанию и JIT, который наконец…
  6. Oct 8, 2026🦙 Ollaya: запуск моделей принятия решений в стиле Ollama. Скачиваете модель, поднимаете л…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →