TGViewer
Channel Public Channel
Python Community

Python Community

@python_community_ru

Python Community RU - СНГ сообщество Python-разработчиков

Чат канала: @python_community_chat

Сотрудничество: @cyberJohnny и @Sergey_bzd

РКН реестр:
https://knd.gov.ru/license?id=67847dd98e552d6b54a511ed&registryType=bloggersPermission
Subscribers
11.6K
Photos
1.5K
Videos
122
Links
1K
Recent Posts 18 shown
Post #3298 240
🖥 Примеры кода на Python 2026: лучшие практики, разбор и задачи с решениями

Python примеры кода 2026 - практическое руководство на русском языке: разбор лучших примеров кода на Python, современные паттерны Python 3.12–3.14, чистый код, асинхронность, типизация, тестирование и задачи для практики с решениями. Подходит для начинающих, junior- и middle-разработчиков, а также для подготовки к собеседованию по Python.

Ключевые темы: примеры кода Python, лучшие практики Python 2026, python для начинающих, задачи по Python с решениями, чистый код на Python, асинхронный Python, asyncio примеры, типизация в Python, pytest примеры, FastAPI пример, парсинг на Python, подготовка к собеседованию Python, Python 3.14 новые

https://github.com/justxor/python-primery-koda-2026/

@Python_Community_ru
Post #3296 352
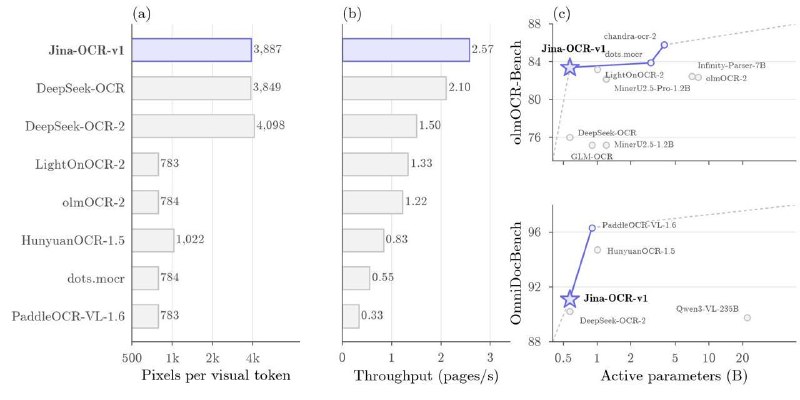
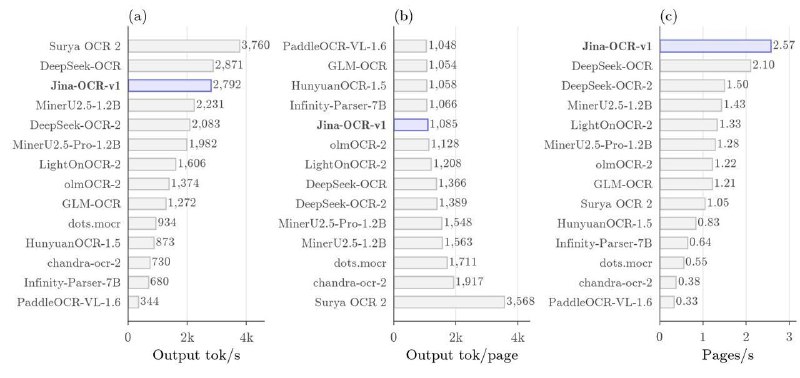
🚀 Jina-OCR-v1 разбирает целые страницы в Markdown со скоростью 2,57 страницы/с

Jina AI представила Jina-OCR-v1 - OCR-модель для преобразования документов в структурированный Markdown.

Главное:

- 91,14 на OmniDocBench v1.6;
- 83,4 на olmOCR-Bench;
- на 7,4 пункта выше DeepSeek-OCR на olmOCR-Bench;
- до 2,57 страницы/с;
- лучший throughput среди 14 протестированных систем при concurrency 32;
- сохраняет текст, формулы, таблицы и порядок чтения за один проход.

Архитектура тоже интересная: модель на 3,4B параметров использует MoE и активирует около 570M параметров на токен. Для ускорения декодирования применяется FastMTP.

Подойдёт для PDF, научных статей, отчётов, таблиц и других сложных документов, где обычного OCR уже недостаточно.

Лицензия: CC BY-NC 4.0. Для коммерческого использования нужно отдельное разрешение.

ModelScope:
https://modelscope.ai/models/jinaai/

Paper: https://modelscope.ai/papers/2609.03

@Python_Community_ru
  • 👍 1
Post #3295 418
🐍 В Python 3.15 решили мягко «похоронить» re.match()

re.match() никуда не удаляют, но для нового кода его теперь рекомендуют не использовать.

Причина простая: название функции часто сбивает с толку. re.match() проверяет совпадение только с начала строки, хотя по имени это неочевидно.

В Python 3.15 появился более явный вариант:

re.prefixmatch()

Теперь логика выглядит понятнее:

- re.search() — ищет совпадение в любом месте;
- re.prefixmatch() — только с начала строки;
- re.fullmatch() — вся строка должна совпасть полностью.

re.match() получил статус soft deprecated: он остаётся рабочим, без warning и без планов на удаление, но новый код лучше писать без него.

Проверять старое использование можно через Ruff и правило TID251.

Статья: https://hugovk.dev/blog/2026/soft-deprecating-re-match/

@Python_Community_ru
  • 👍 1
  • 🔥 1
Post #3294 431
⚡️ Qwen-Image за 6 шагов: Viggle ускорили генерацию и редактирование в 5 раз

Viggle выложили Qwen-Image-2.1-viggle-turbo v0.2, дистиллированную версию Qwen-Image-2.1. Вместо 40 шагов модели хватает 6 проходов, и end-to-end это примерно в 5 раз быстрее. Умеет text-to-image и редактирование по инструкции с 1–3 референсами, причём без CFG.

Дистиллировали через DMD2 с distribution matching в стиле SenseFlow. Распространяется как LoRA поверх базовой модели: rank 256 на 1,3 ГБ или rank 128 на 680 МБ.

По качеству на 96 пользовательских запросах разнообразие держится на 0,98 от базы, а композиция ни разу не разошлась с оригиналом. Пик памяти в ComfyUI около 26 ГБ VRAM на 1248×832.


https://huggingface.co/Viggle/Qwen-Image-2.1-viggle-turbo

@Python_Community_ru
  • 👍 1
Post #3293 438
🖥 Заголовки безопасности для FastAPI - одной строкой 🛡️

fastapi-security-headers добавляет к ответам приложения HTTP-заголовки: HSTS, защиту от MIME sniffing, ограничения на встраивание страниц и другие политики браузера. Подключается как ASGI middleware:


app.add_middleware(SecurityHeadersMiddleware)


Есть готовые настройки для JSON API, строгой политики и Swagger UI, чтобы /docs продолжал работать. Заголовки можно настроить под конкретное приложение или переопределить для отдельного маршрута.

GitHub - https://github.com/aletgdev/fastapi-security-headers

@Python_Community_ru
Post #3291 468
Линтер для инструкций ИИ-агентов

LintLang проверяет AGENTS.md, CLAUDE.md, SKILL.md, описания инструментов и конфигурации агентов. Ищет расплывчатые инструкции, циклы без условия остановки и расхождения между описанием инструмента и его схемой.

Работает локально, без вызовов LLM. Его можно запустить перед коммитом или добавить в CI, чтобы новые ошибки в инструкциях попадали на проверку вместе с кодом.


uvx lintlang scan AGENTS.md


https://github.com/hermes-labs-ai/lintlang

@Python_Community_ru
Post #3290 460
⚡️ OmniVoice - открытая модель озвучки с поддержкой более 600 языков.

Она умеет клонировать голос по 3–10 секундам записи и озвучивать новый текст этим голосом. Можно также задать характеристики голоса словами - например, тембр или акцент, либо позволить модели выбрать голос самой.

Для разработчиков есть Python API, CLI и локальное веб-демо. Авторы заявляют скорость генерации до 40× быстрее реального времени, но это показатель для отдельных условий запуска, а не гарантия для любого устройства.

Режим создания голоса по описанию обучали преимущественно на английском и китайском, поэтому на других языках результат может быть нестабильным.

Подойдёт для озвучки роликов, локализации и голосовых интерфейсов - особенно если нужен язык, который редко встречается в TTS-моделях.

GitHub: k2-fsa/OmniVoice: https://github.com/k2-fsa/OmniVoice

@Python_Community_ru
  • 🔥 2
Post #3289 539
⚡ Qwen представила Audio 3.1 - единый стек для ASR, TTS и realtime-аудио.

Главное:

* ASR лучше распознаёт языки и диалекты, убирает повторы и слова-паразиты.
* ASR-Next разделяет спикеров, ставит таймкоды, распознаёт эмоции и окружающие звуки.
* TTS поддерживает перенос голоса между языками и управление стилем, скоростью и эмоцией.
* TTS-Next генерирует сразу голос + эффекты + фон через связку LM + diffusion.
* Realtime умеет одновременно слушать и говорить с естественными перебиваниями.

Плюс сильно снизили цены: TTS ~−70%, Realtime ~−85%, ASR до −95%.


- Qwen-Audio-3.1-ASR:
https://qwencloud.com/models/qwen-audio-3.1-asr-flash-filetrans
- Qwen-Audio-3.1-Realtime:
https://qwencloud.com/models/qwen-audio-3.1-realtime-plus

@Python_Community_ru
  • 🔥 2
Post #3288 638
‍🐍 Ruff доволен, mypy молчит, тесты зелёные. А в коде четыре одинаковых функции

Автор статьи столкнулся с этим в проекте, который писал ИИ-агент. Вместо поиска готовых функций агент добавлял новые копии. Когда понадобилось изменить нормализацию данных, он уже не мог разобраться, какую из четырёх править.

Обычные проверки не покрывают всю структуру проекта:

* Ruff находит нарушения правил и умеет проверять сложность при соответствующей настройке.
* mypy проверяет типы.
* pytest проверяет сценарии, для которых написаны тесты.

При этом дублирование между файлами, неиспользуемые функции и нарушения архитектурных границ могут остаться незамеченными.

Автор предлагает добавить структурный анализ. Его инструмент pyscn ищет дубли, сложные функции, мёртвый код и нарушения правил зависимостей:


uvx pyscn analyze .


Что полезно забрать в свой проект:

* Блокировать в CI новые проблемы, а не сразу весь накопленный техдолг.
* Следить за изменением сложности, а не только за общей оценкой.
* Закрепить допустимые зависимости между модулями проверяемыми правилами.
* Дать агенту запускать анализатор до отправки кода на ревью.

Высокая сложность сама по себе ещё не повод переписывать функцию. Иногда длинная последовательность понятных проверок лучше искусственного дробления.

Статья — https://codescan.dev/blog/ruff-mypy-pytest-and-then-what

@Python_Community_ru
Post #3287 521
‍🐍 В CPython одно чтение `__dict__` может навсегда замедлить доступ к атрибутам конкретного объекта.

Начиная с Python 3.11 обычный obj.x часто вообще не делает lookup по словарю. После прогрева интерпретатор специализирует LOAD_ATTR, а значение читается почти напрямую из inline storage объекта.

Но достаточно выполнить:


`obj.__dict__`


или:


`vars(obj)`


а в некоторых случаях даже:


`copy.copy(obj)`


— и __dict__ материализуется. После этого объект теряет быстрый специализированный путь на оставшееся время жизни.

На CPython 3.14.6 в тесте на M3:

обычный объект → 33.0 ms
после чтения __dict__ → 50.6 ms

В free-threaded сборке разрыв ещё больше:

34.0 ms → 59.4 ms.

Интересная деталь: __slots__ сам по себе почти не ускоряет обычный attribute access. Его преимущество здесь в другом — у объекта нет __dict__, значит его невозможно случайно материализовать и сбить оптимизацию.

Очень неочевидная причина, почему vars() или copy.copy() внутри hot path могут неожиданно ударить по производительности.

https://deadlovelll.github.io/2026-09-05-reading-dict-deoptimizes-attribute-access/

@Python_Community_ru
Post #3286 556
🔥 Qwen представила Qwen3.8-Omni-Flash - свою первую мультимодальную модель, изначально заточенную под агентные задачи.

Она одновременно работает с видео и аудио, умеет рассуждать по увиденному и услышанному, планировать действия и подключать инструменты. Среди сценариев — автоматический монтаж влогов, перевод коротких видео, создание пересказов фильмов и поиск нужных эпизодов в длинных записях.

По данным Qwen, на WildClawBench-MM и UniClawBench модель прибавила в среднем 19,5 пункта в агентных задачах и приблизилась к Gemini 3.8 Flash по работе с аудио и видео.

Контекст - 1 млн токенов. На OmniVideoBench активный поиск по длинному видео позволил сократить расход токенов на 51,8% по сравнению со статическим анализом.

Стоимость обработки видео при этом снизилась примерно на 89% относительно Qwen3.5-Omni-Plus.

Вместе с моделью Qwen открывает Qwen-MM-Plugins для мультимодальных инструментов. Qwen-Live Harness также будет опубликован отдельно.

https://qwen.ai/blog?id=qwen3.8-omni-flash

@Python_Community_ru
  • 🔥 1
Post #3285 551
‍🔥 Package Doctor - необычный security-сканер для Python-зависимостей

Он отвечает не только на вопрос «есть ли у пакета CVE?», а на более практичный:

если завтра в этой зависимости найдут уязвимость, вы реально под угрозой и есть ли вообще кому её исправлять?

Package Doctor оценивает сразу две вещи:

- находится ли библиотека на trust boundary: auth, загрузка файлов, десериализация, crypto, URL parsing, model loading и т.д.
- есть ли у проекта реальная способность быстро выпустить фикс

Плюс инструмент:

- проверяет pinned-версии по advisory-базам
- учитывает CISA KEV и EPSS
- AST-парсит ваш код и показывает, где зависимость реально импортируется
- отличает abandoned package от просто редко обновляемого
- умеет работать как hook для Claude Code и блокировать подозрительную зависимость до pip install

Интересный подход: не засыпать разработчика сотнями CVE, а приоритизировать именно те зависимости, где одновременно есть экспозиция + слабая поддержка.

Автор отдельно рекомендует использовать его вместе с pip-audit, а не вместо него.

https://github.com/binuka200/package-doctor

@Python_Community_ru
Post #3284 568
‍🔥 Django Q() objects — один из самых полезных инструментов ORM, который многие используют слишком редко

Q() позволяет собирать сложные условия для WHERE, комбинируя их через AND, OR и NOT.

Пример:


Pet.objects.filter(
Q(last_given_treats__isnull=True)
| Q(last_given_treats__lte=timezone.now() - timedelta(days=1)),
treats_needed__gt=F("treats_given"),
)

Особенно полезно для динамических фильтров:


q = Q()

for term in search_term.split():
q |= Q(name__icontains=term)

Pet.objects.filter(q)


Но есть ещё более важный момент.

При фильтрации через related models два отдельных .filter() могут привести к двум JOIN и неожиданно изменить смысл запроса.


Species.objects.filter(
pets__name__icontains="meowy"
).filter(
pets__treats_given=0
)


Это уже может искать одну запись по имени, а другую - по количеству treats.

Если собрать условия в одном .filter() или через Q(), Django использует один JOIN и проверяет условия на одной и той же связанной записи.

Очень полезный приём для сложных QuerySet, динамического поиска и composable business filters.

https://www.better-simple.com/django/2026/09/09/nifty-feature-q-objects/

@Python_Community_ru
Post #3283 583
‍🖥 Python → C++: Shed Skin компилирует код без ручной расстановки типов

Shed Skin переводит ограниченное подмножество Python 3 в оптимизированный C++. На выходе можно получить отдельную программу или модуль расширения, который импортируется в обычный Python-проект.

Типы инструмент выводит автоматически, поэтому аннотации добавлять не обязательно. Но код должен соответствовать ограничениям статической типизации.

Что со скоростью? На наборе из более чем 80 программ авторы получили среднее ускорение в 20 раз относительно CPython 3.14, медианное - в 12 раз. Это результаты конкретных примеров, а не обещание для любого проекта.

Ограничения существенные:

* Поддерживается только часть Python.
* Из стандартной библиотеки доступны около 25 модулей, включая random и re.
* Произвольные сторонние библиотеки использовать нельзя.
* Вложенные функции и переменное число аргументов не поддерживаются.

Проект рассчитан прежде всего на небольшие вычислительные участки кода, которые можно отделить от внешних зависимостей. Для совместимости может потребоваться серьёзный рефакторинг.

В репозитории есть примеры, включая трассировку лучей, шахматоподобные игры и DOOM.

https://github.com/shedskin/shedskin

@Python_Community_ru
Post #3282 633
‍Настольный радар на Raspberry Pi - с самолётами, кораблями и переговорами диспетчеров

FlightScnr Pi превращает Raspberry Pi и круглый 4-дюймовый сенсорный экран в трекер транспорта. На дисплее - тёмная карта, вращающийся луч и самолёты поблизости. Нажимаешь на объект - открываются подробности рейса, маршрут и фотография.

Что умеет:

* Отслеживать самолёты по данным Flightradar24, adsb.fi или собственного приёмника через dump1090/readsb.
* Показывать суда при подключении источника AIS.
* Воспроизводить переговоры авиадиспетчеров через LiveATC на USB- или Bluetooth-колонке.
* Отображать погоду, осадки, пожары и землетрясения.
* Переключаться между радаром, картой маршрута и часами с погодой.

Настройка и обновления доступны через локальный веб-интерфейс. Для повседневного использования SSH не нужен.

Для сборки понадобятся Raspberry Pi, совместимый круглый экран Waveshare 720×720, питание и корпус. Для выбранных источников данных могут потребоваться API-ключи.

Код доступен по CC BY-NC-SA 4.0 - с ограничением на коммерческое использование. В документации есть инструкции по сборке и установке.

https://github.com/yashmulgaonkar/FlightScnr_Pi

@Python_Community_ru
  • 👍 1
Post #3281 633
🐙 GitHub показал Project HydraFusion - экспериментальный режим Copilot, который сам собирает лучший сценарий из нескольких.

Для каждого запроса HydraFusion выбирает один из вариантов:

* одна модель решает задачу;
* быстрая модель делает черновик, а при необходимости задача уходит более сильной;
* одна модель пишет решение, другая отдельно его критикует, после чего первая дорабатывает результат.

GitHub тестировал подход на агентных coding-бенчмарках. На TerminalBench 2.1 HydraFusion показал качество на 4,9 п.п. выше Claude Opus 5 при примерно на 67% меньшей расчётной стоимости.

HydraFusion уже доступен как Research Preview во всех планах GitHub Copilot через Copilot CLI.

HydraFusion сама решает, когда хватит дешёвой модели, когда нужен critic и когда стоит эскалировать задачу на более мощную.

https://github.blog/ai-and-ml/github-copilot/project-hydrafusion-frontier-quality-via-multi-model-orchestration/

@Python_Community_ru
Post #3280 561
🌦 Linecast - погода, карты, радар, приливы, Солнце и Луна прямо в терминале

Open-source CLI превращает публичные данные в шесть интерактивных приложений:

- linecast weather — погода, почасовой прогноз, AQI и предупреждения
- linecast sunshine — восход, закат и длина дня
- linecast moon — фазы Луны, восход/заход и календарь
- linecast tides — график приливов и отливов
- linecast radar — анимированный радар и спутниковые данные
- linecast maps — карты, рельеф, поиск мест и маршруты

Работает на macOS, Linux и Windows. Написан на Python, почти без зависимостей, не требует аккаунта или API-ключей и подстраивает цвета под тему терминала.

Можно даже запустить без установки:

uvx linecast weather

GitHub:
https://github.com/ashuttl/linecast

@Python_Community_ru
Post #3279 670
🐍 Исправление опечаток всего в 21 строке Python

Питер Норвиг показал очень компактный пример вероятностного spell checker — без нейросетей и сложных моделей.

Идея простая:

- берём слово с ошибкой
- генерируем варианты на расстоянии 1–2 правок
- оставляем слова, которые есть в словаре
- выбираем самый вероятный вариант по частоте в корпусе

Одна правка — это:

удаление → перестановка → замена → вставка

Например:

speling → spelling

Ключевой момент — алгоритм не пытается «понять» слово. Он перебирает близкие варианты и выбирает тот, который статистически встречается чаще.

Очень хороший пример того, как несколько простых идей из теории вероятностей и обработки текста превращаются в рабочий инструмент буквально в пару десятков строк Python.

@Python_Community_ru
Older posts →

About this channel

How can I read @python_community_ru without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Python Community: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Python Community have?
Python Community (@python_community_ru) has 11.6K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Python Community know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →