TGViewer
Channel Public Channel
PyMagic

PyMagic

@pymagic

Data Science / ML / Deep Learning
VK group https://vk.com/club211095898
Subscribers
5.56K
Photos
234
Videos
5
Links
257
Recent Posts 13 shown
Post #681 756
Всем привет! 👋

Давно здесь не было новостей, поэтому начну с главной: с недавних пор я перешла в X5, где отвечаю за ML-персонализацию в CVM.

И сейчас мы ищем классных стажеров в нашу команду 🚀

Немного расскажу, чем мы занимаемся и что у нас под капотом.

Мы строим модели для персонализации взаимодействия с миллионами клиентов. В основе многих задач лежит Uplift-моделирование (про него можно почитать здесь): мы определяем не только что персонально предложить клиенту, но и кому вообще стоит делать предложение, чтобы коммуникация действительно меняла его поведение и приносила бизнес-эффект.

При этом стек задач у нас довольно разнообразный и далеко не ограничивается классическим ML.

Что у нас под капотом:
— классические ML-модели
— нейросетевые подходы, на которые уже переведена часть решений
— рекомендательные системы
— модели ранжирования

А еще мы стараемся не вариться только в текущих решениях: смотрим новые статьи и подходы, экспериментируем и пробуем переносить research в прод (там, где это действительно имеет смысл для задачи).

Что особенно хочу отметить: результат работы моделей здесь можно увидеть в реальном бизнесе. Они работают на больших аудиториях и могут давать вполне измеримый экономический эффект для компании.

Мы смотрим все заявки, поэтому не переживайте, что до вашего резюме не дойдут 😉

Откликнуться можно здесь
hh.ru Вакансия Стажёр Data Scientist в команду персонализации и CVM в Москве, работа в компании X5 Tech Зарплата: не указана. Москва. Требуемый опыт: 1–3 года. Занятость: полная. Дата публикации: 01.10.2026.
  • ❤ 12
  • 🔥 7
  • 😁 1
Post #680 2.34K
Уже на этой неделе с 23 мая стартует Data Fest 2026! А 24 мая пройдёт секция ML in Advertising.

Делюсь анонсом докладов: все про внедренные решения в проде и прикладные подходы, которые можно применять не только в AdTech.

🔹«Реранкер в ритейле: как превратить рекламу в рекомендацию»
Как заменить фиксированные рекламные слоты умным ранжированием, которое подбирает рекламу под конкретного пользователя. Трансформер + градиентный бустинг, поддержка разных стратегий продвижения и результаты A/B.

🔹«Как устроено ранжирование рекламных объявлений в Авито»
Устройство предсказания CTR и ранжирования рекламы в Авито. Эмбеддинги пользователей и объявлений как признаки для двубашенной модели user-item — архитектура, обучение, результаты.

🔹«Мультимодальный суп: Превращение кучи рекламных баннеров в осмысленные кластеры»
Как из тысяч шумных рекламных баннеров автоматически собрать осмысленные кластеры-кампании с помощью дообученного CLIP, OCR и HDBSCAN.

Жду вас 24 мая в Loft Hall, зал Ratusha с 16 часов (ул. Ленинская Слобода, 26, стр. 15) 😉
  • ❤ 11
Post #679 2.68K
Как кластеризовать миллионы объектов с высокой размерностью и сложной структурой данных?

Когда мы работаем с эмбеддингами (например, BERT4Rec), то сталкиваемся с тремя проблемами: миллионы объектов, высокая размерность и невыпуклые формы кластеров. При снижении размеренности мы теряем часть информации. Тут возникает дилемма: при снижении размерности мы неизбежно теряем часть информации. Если оставляем в исходном виде, то для большинства методов возникают проблемы с вычислительной сложностью и масштабируемостью.

О том, как мы повысили качество предсказания CTR за счет кластеризации миллионов товаров, я расскажу на конференции Data Fest 2026, на которой также буду модерировать секцию ML in Advertising.

Что обсудим:
🔹Какой метод выбрать, когда объектов миллионы, а кластеры имеют сложную форму
🔹Как мы внедрили это в предсказание CTR
🔹Кейсы за пределами рекламы: как вычислять сопокупки и строить кластерные рекомендации

Следующие посты будут анонсу выступлений других докладчиков нашей секции!

⏰ Когда: 24 мая с 11.00 и до вечера
📍Где: ул. Ленинская Слобода, 26, стр. 15 (Loft Hall, зал Ratusha)
📌 Регистрация

Подробнее о спикерах и докладах будет обновляться информация на странице мероприятия.
  • 👍 10
  • ❤ 6
  • 🔥 2
Post #678 2.81K

Forwarded from ODS Events

Привет!

Вечер четверга — самое время вспомнить о том, что хотелось подать заявку на спикерство на Data Fest 2026 😊

📣 Стать спикером 📣

Ждём ваши темы в форме! Полный список секций доступен на странице подачи докладов (кстати, у нас добавились ML in Funtech, LeanAI, LLM Inference, ML in DBMS и ML in Rust) и они ждут своих героев 😎
⭐ Финальный дедлайн — 30 апреля, успевайте!


🙌 Стать участником 🙌

Первые регистрации участников на офлайн дни Феста уже открыты:
23 мая (сб): Data Fest 2026 в гостях у X5 Tech в Москве
24 мая (вс): Data Fest 2026 в гостях у Яндекса в Белграде
28 мая (чт): Data Fest 2026 в гостях у Школы 21 в Уфе
31 мая (вс): Data Fest 2026 в гостях у Яндекса в Москве

📍 Москва, Санкт - Петербург, Новосибирск, Алматы, Белград, Уфа + онлайн. Отправляйте свои анкеты и следите за обновлениями, впереди много интересного и анонсы других площадок 👍
  • ⚡ 4
  • 🤨 4
  • 🔥 2
Post #677 2.91K
Разбор докладов с конференции

И вот подошел к концу второй день конференции Data Fusion, на котором было множество различных секций, дискуссий и кейс-сессий. Я решила написать о парочке докладов, которые мне больше всего понравились.

➡️Первый доклад «Ключевые проблемы рекомендаций на последовательностях и варианты их решения». Посвящен проблемам в Sequential рекомендациях. В первой части рассматривалась проблема разделения данных: популярный leave-one-out допускает temporal leakage и формирует нереалистичный горизонт предсказания, что может негативно влиять на ранжирование и выводы о моделях. В качестве альтернативы предложен global temporal split с выбором целевых взаимодействий Last / Random / Successive - такие схемы лучше соответствуют задаче next-item prediction, уменьшают утечки и дают более стабильные результаты, хотя и сокращают число тестовых пользователей.

⭐️В целом, проблема LOO очень понятна, особенно для последовательных данных, и было интересно услышать об обоснованности сочетания GTS с разными способами выбора целевых взаимодействий.

➡️Во второй части освещена проблема Item Cold start: в sequential моделях новые объекты не имеют обученных эмбеддингов. Frozen content embeddings оказываются негибкими, а полный fine-tuning приводит к drift представлений и ухудшает cold-start. В качестве trade off использовался frozen content-based embedding + маленький обучаемый delta-вектор с ограниченной нормой, который позволяет модели аккуратно адаптироваться под взаимодействия, сохраняя семантику контентных признаков.

➡️Еще понравился доклад про победившее решение на соревновании Data Fusion «Страж» (задача классификации неподтвержденных операций клиентов банка). Построено чисто на нейронных сетях: данные формировались окнами (~3 месяца транзакций или 512 токенов), для каждого пользователя создавали 5–10 окон, чтобы покрыть повторяющиеся паттерны. Модель - стандартный Encoder трансформер: блок трансформера включал 2 ModernBERT (для глобальных паттернов) + 2 CNN (для локальных).

⭐️Думаю, что в ближайшем будущем многие табличные задачи будут решаться с помощью трансформеров, но при этом остается важной проблема инференса в продакшене (latency и ресурсы).

Посмотреть доклады с конференции можно уже на официальном сайте https://data-fusion.ru
  • ❤ 5
  • 👍 5
  • 🔥 3
  • ❤‍🔥 2
Post #676 2.3K
Первый день на Data Fusion 2026

Сегодня, 8 апреля, я побывала на первом дне конференции Data Fusion 2026 в технологическом кластере «Ломоносов».

Data Fusion – крупнейшая экспертная конференция по работе с данными и технологиями ИИ. Здесь собираются те, кто создает наше технологическое будущее.

➡️На конференции было очень много докладов и обсуждений про AI-агентов — это стало популярной темой первого дня. Разбирали, как агенты меняют корпоративные системы, AgentOps, вопросы безопасности и внедрение в высоконагруженные продукты.

➡️Было интересно послушать мнения коллег из крупных компаний на дебатах «Да или нет вайб-кодингу?». Обсуждали, как такой подход незаметно вошел в повседневную работу, и как его используют в реальных проектах.

➡️Дополнительно хотела отметить сессию Explainable AI, где выступали коллеги из Китая и говорили о том, как делать модели искусственного интеллекта понятными и прозрачными для бизнеса и регуляторов.

Завтра, 9 апреля, продолжение программы: международный трек, дополнительные сессии по агентам, рекомендательным системам, AI в медицине и другим направлениям.

Смотрите в ролике мой небольшой обзор первого дня 😉

data-fusion.ru
  • 🔥 18
  • 👍 9
  • 🥰 4
  • ❤ 2
Post #675 3.01K
Новости

Давно я тут ничего не писала, был небольшой перерыв. Для всех новеньких меня зовут Никулина Анастасия, я в ML и аналитике в совокупности уже больше 9 лет. В этом канале вы найдете кучу полезных статей тык. У меня есть свой ютуб канал про машинное обучение с аудиторией более 40 тыс человек тык.

А теперь к самому вкусному. Открылась регистрация на подачу докладов на Data Fest 2026. В этом году на конференции появятся новые интересные секции, одну из которых буду вести я 🥳

Записывайтесь, подавайте свои доклады, а лучше всего в секцию ML in Advertising, очень жду вас там! ❤️

Конференция пройдет с 23 по 31 мая в Москве, Питере и др. городах, подробнее тут

Зарегистрировать свой доклад можно здесь
  • 🔥 24
  • ❤ 15
  • 👍 5
  • 🤣 1
  • 😐 1
  • 👀 1
Post #674 7.83K
Рады приветствовать всех новых участников!

Здесь мы обсуждаем машинное обучение: алгоритмы, новинки из мира ML, а также делимся реальным опытом, который редко можно встретить в учебниках. Кроме того, на канале появляются анонсы образовательных курсов, которые уже завершили более 2000 студентов.

➡️Что почитать?

➖Многорукие бандиты в музыкальных рекомендациях
➖Почему лосс не падает, и модель не обучается?
➖Оптимизируем размер памяти DataFrame в 3 раза
➖В каких случаях использовать деревья решений?
➖Ключевые научные работы по NLP
➖Что такое контрастирование обучение?
➖Полезные книги по ML
  • 🔥 20
  • 👍 10
  • ❤ 5
  • 🤣 2
  • 👀 1
Post #672 7.53K
➡️Обучение Data Science для начинающих 3.0

Друзья, мы запустили новую версию курса по машинному обучению! Теперь вы можете проходить материалы в удобное для вас время и в собственном темпе — независимо от графика других студентов.

❗️Мы снизили стоимость курса, поскольку формат стал ориентированным на самообучение. Тем не менее, у вас будет доступ к чату студентов, где можно общаться, обмениваться мнениями и задавать вопросы другим студентам!

Что вы изучите:
➖Математику для Data Science
➖Как проводить АБ-тестирование
➖Классические ML-алгоритмы с полным разбором архитектуры и применения алгоритмов на практике: от линейных моделей до бустингов
➖NLP: от TF-IDF до LLM
➖Deep Learning: основные тренды, база по нейросетям
➖Computer Vision: примеры из области
➖MLOps: production code, FastAPI, Streamlit, линтеры
➖Дополнительно: Airflow, MLFlow, многопоточность, мультипроцессинг, временные ряды, Superset и пр.

В расширенном тарифе Grandmaster доступно 2 больших продвинутых блока:

➡️NLP — от базовой обработки текста (токенизация, лемматизация, regex и др.) до LLM. Научитесь дообучать модели с Hugging Face и применять их для анализа тональности, диалогов и кода (GraphCodeBERT, CodeT5 и др.)

➡️Рекомендательные системы — коллаборативная, контентная и гибридная фильтрация. Изучите ключевые алгоритмы (User/ItemKNN, ALS, NCF, SVD++), метрики (включая beyond accuracy) и продвинутые методы: нейросети, автоэнкодеры, графовые и контекстно-адаптивные рекомендации.

📎 Всю актуальную информацию можно найти на сайте PyMagic
  • 🔥 24
  • 👍 6
  • ❤ 2
  • 😭 2
  • 🤓 2
  • ⚡ 1
  • 🎉 1
  • 🤩 1
Post #671 6.22K
➡️Обзор докладов по рекомендательным системам

Недавно завершилась ежегодная конференция Data Fusion. В этом году она особенно порадовала разнообразием секций, однако ключевое внимание было уделено теме данных — важнейшему компоненту любой модели, который, к сожалению, часто остаётся в тени.

Я решила попробовать новый формат и подготовила обзор на часть докладов из секции, посвящённой рекомендательным системам. На самом деле интересных выступлений было гораздо больше, и многие из них заслуживают отдельного внимания.

Что из этого получилось — смотрите в новом ролике! 😉

https://youtu.be/0S3e1iXR9Vs?si=eNxMR40cQ08n3pi9
YouTube Как работают алгоритмы рекомендаций? Обзор на доклады с Data Fusion 2025 📌 Записи докладов и другая подробная информация о конференции Data Fusion доступны на официальном сайте https://data-fusion.ru/?&erid=2Vtzqumv1QF 🔎 Продолжайте следить за новостями конференции здесь https://t.me/Data_fusion В этом видео я делаю обзор докладов…
  • ❤ 18
  • 👍 6
  • 💅 4
  • 💋 1
Post #670 5.54K
Собираемся на Data Fusion! 🚀

16-17 апреля в Москве в кластере Ломоносов пройдет крупнейшая конференция Data Fusion по BigDate и AI. Программа конференции каждый год достаточно насыщенная, и этот год не исключение: в расписании как бизнес-, так и технические треки. В этом году будут выступления ведущих ученых, разбор кейсов ML в различных отраслях, дебаты «наука vs бизнес», а также узкопрофильные сессии по DataOps, CV, RAG и нейротехнологиям.

В прошлом году я лично была на площадке, мне конференция очень понравилась: организация, интересные доклады, сессии. А ещё была супер возможность поддержать коллегу, который рассказывал о рекомендательных системах в маркетплейсе 🌿

В этом году, к сожалению, не смогу присутствовать лично, поэтому буду следить за трансляцией. Но если у вас есть возможность прийти и послушать доклады вживую — очень рекомендую! Это отличный шанс пообщаться с коллегами, которых давно не видели, и задать спикерам вопросы напрямую.

Кстати, как вам идея выпустить новый ролик на ютубе с разбором докладов и статей из конференции с моими комментариями? В том числе как такие технологии работают на практике) Если ждешь, то ставь 🔥

Ссылка на регистрацию: https://data-fusion.reg.events/guest/?&erid=2VtzqvwUtXT
  • 🔥 37
  • 👍 6
Post #669 5K
🚀 Подкаст Data Breakfast с Анастасией Никулиной. Часть вторая — Курсы в Data Science

🎙 О чём спросили?
▫️ Как создать курс, который меняет карьеру?
▫️ Платные vs бесплатные курсы: когда и зачем платить?
▫️ Почему YouTube-лекции — не всегда достаточно?
▫️ Как не стать «инфоцыганом» и заслужить доверие аудитории?
▫️ Pet-проекты: как превратить их в козырь для резюме?
▫️ Университет vs онлайн: что выбрать новичку?

🎧 Слушайте там, где удобно:
▫️ Telegram-плеер
▫️ Яндекс.Музыка
▫️ Страница выпуска

➡️ Первый выпуск можно посмотреть в группе ODS Piter, для этого необходимо добавиться туда и зайти на этот пост 😉
Telegram mave.stream Полноценный подкаст-стриминг прямо в Telegram 🎙️ mave.stream — всё, что хочется слушать и смотреть. 27 000+ подкастов и 1,2 млн аудио и видеовыпусков с персональными рекомендациями.
  • 👍 17
Post #659 5K

Forwarded from RWB делает ML

#мнение_эксперта
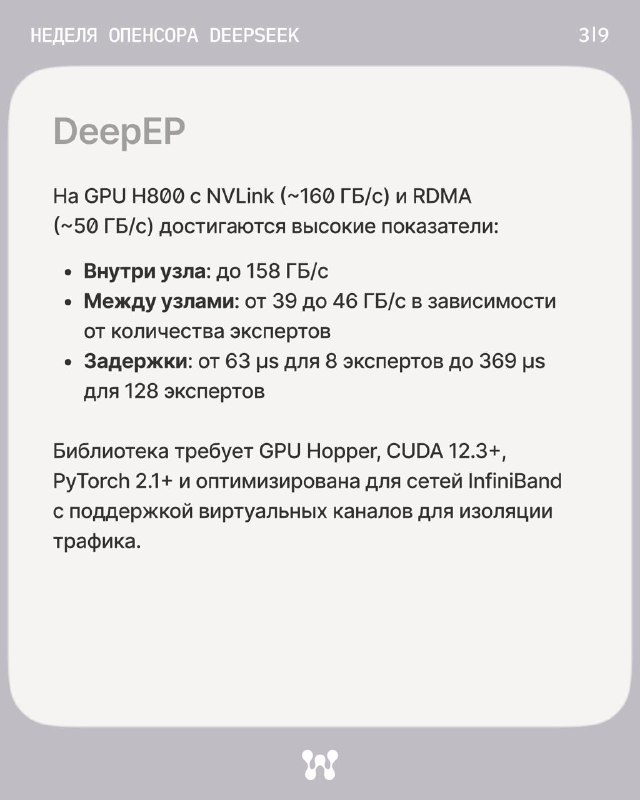
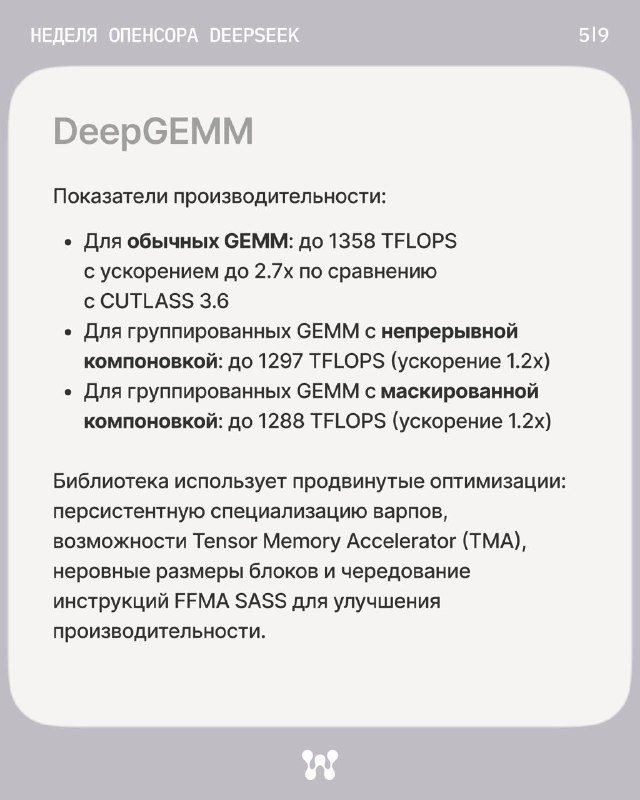
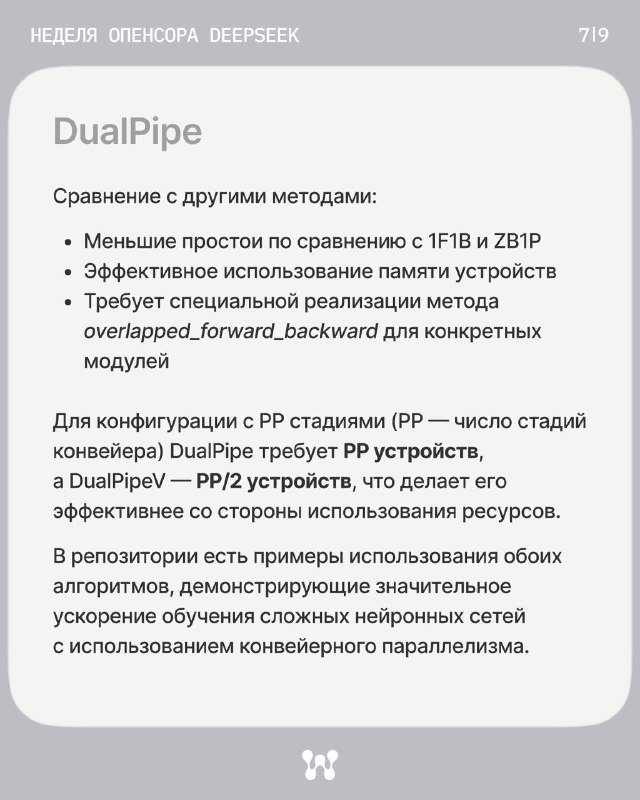
В конце февраля DeepSeek устроили неделю опенсорса и 5 дней публиковали репозитории с кодом их проектов ⚙️

◼ FlashMLA — механизм декодирования для больших языковых моделей.
◼ DeepEP — коммуникационная библиотека, специально разработанная для MoE и EP.
◼ DeepGEMM — библиотека для эффективных вычислений General Matrix Multiplications.
◼ DualPipe — инновационный алгоритм двунаправленного конвейерного параллелизма.
◼ Fire-Flyer File System (3FS) — высокопроизводительная распределенная файловая система.

Остальные подробности про каждый проект читайте на карточках!

———
Спасибо за разбор Павлу Дмитриеву, Machine Learning Engineer в CoreCV ✅
🌟 @wb_space
📹 @wb_tech
  • 🔥 15
  • 👍 2
Older posts →

About this channel

How can I read @pymagic without a Telegram account?
TGViewer shows the public web preview Telegram publishes for PyMagic: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does PyMagic have?
PyMagic (@pymagic) has 5.56K subscribers on Telegram, refreshed roughly every 30 minutes.
Does PyMagic know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →