TGViewer
Channel Public Channel
purple shift

purple shift

@purpleshift

Фиолетовый сдвиг - для тех, у кого происходят инциденты. Наш сайт: https://purpleshift.io
Subscribers
3.05K
Photos
123
Videos
0
Links
176

Showing posts older than #179 · Back to latest

Older Posts 20 shown
Post #177 2.38K
Инструмент Bloodhound был создан в 2016 году для поиска способов получения привилегий доменного администратора с помощью представления взаимосвязей между объектами целевой Active Directory в виде графа.

Несмотря на солидный возраст, Bloodhound до сих пор остаётся одним из популярных средств разведки и сбора данных в целевой инфраструктуре, и регулярно фигурирует в отчётах об инцидентах.

Эксперты из нашей команды SOC Consulting протестировали работу свежих версий этого инструмента и выяснили, по каким следам в логах можно выявить разные методы сбора данных коллекторами SharpHound и Bloodhound.pу.

Результаты вкратце:

— основные правила корреляции для обнаружения обоих коллекторов строятся на событиях 5145, но можно использовать и события 5712 для более точного детектирования;

— обнаружить работу обоих коллекторов также можно по LDAP-запросам с определёнными атрибутами, используя журналы 1644 «LDAP-Search»;

— поскольку события, необходимые для обнаружения коллекторов, генерируются в большом количестве и могут быть связаны с легитимной активностью, стоит обращать внимание на характерные последовательности запросов и операций, происходящие в течение очень короткого времени (нескольких секунд).

Все остальные нюансы детектирования этого инструмента — в статье Степана Ляхова "Кто выпустил гончую. Ищем следы коллекторов Bloodhound в логах Windows".
  • 👍 12
  • 🔥 6
  • 🤪 5
  • ❤ 3
Post #176 4.18K
Архитектура Windows преподнесла новый сюрприз, а точнее, новую поверхность атак в старой технологии.

Межпроцессное взаимодействие в Windows опирается на протокол RPC (Remote Procedure Call) — сложный механизм, в котором год за годом выявляются различные уязвимости. Вот и наш эксперт Хайдар Кабибо, давно изучающий безопасность RPC, нашёл новый архитектурный вектор локального повышения привилегий, получивший название PhantomRPC.

Суть техники: атакующий поднимает поддельный RPC-сервер, который отвечает на запросы клиента по тому же UUID/эндпойнту, что и легитимный сервер, а затем вызывает RpcImpersonateClient и получает контекст вызывающего процесса (вплоть до SYSTEM, в зависимости от сценария).

Ключевое условие: у процесса атакующего есть привилегия SeImpersonatePrivilege (как правило, доступная для учётных записей Network Service или Local Service). Именно в этом случае становится возможна эскалация до SYSTEM или уровня администратора, если легитимный RPC-сервер недоступен — например, когда соответствующая служба отключена.

Это не уязвимость конкретной службы (в отличие от семейства Potato), а следствие того, что RPC-рантайм не проверяет легитимность RPC-сервера и позволяет другому процессу зарегистрировать тот же эндпойнт, что и у легитимного сервера. В некоторых случаях требуются дополнительные условия среды (например, наличие определённой конфигурации GPO).

Все описанные в исследовании пути повышения привилегий протестированы на Windows Server 2022 и Windows Server 2025 с последними обновлениями, доступными на момент исследования. Автор отмечает, что уязвимость может быть проэксплуатирована и на других версиях Windows, поскольку она является проблемой архитектурного дизайна.

Что можно сделать до появления патча:

— минимизировать SeImpersonatePrivilege у нестандартных/кастомных процессов (удалять её, если она не нужна);

— по возможности включать легитимные сервисы, работающие на основе RPC, чтобы их RPC-эндпойнты были заняты штатными серверами;

— включить ETW-мониторинг RPC-событий и отслеживать ошибки RPC_S_SERVER_UNAVAILABLE от высокопривилегированных клиентов — это позволяет обнаружить попытки подмены до её реального выполнения.

Таким образом, уязвимость PhantomRPC открывает новую поверхность атак в Windows RPC и требует постоянного внимания администраторов и разработчиков приложений, использующих этот протокол.

Подробности с примерами кода и схемами эксплуатации — в статье "PhantomRPC: новая техника повышения привилегий в Windows RPC".

Этот доклад также вошёл в программу конференции Black Hat Asia 2026, которая завершается сегодня в Сингапуре.
  • 👍 20
  • 🔥 15
  • 😁 3
  • 👀 3
Post #175 2.9K
Как мы и обещали, продолжаем историю про слишком самостоятельных LLM‑агентов. Наши эксперты проверили OpenClaw на дефолтных настройках — и добились того, что агент выполняет вредоносные системные команды в контексте текущего пользователя после клика по специально подготовленной ссылке.

Вкратце о том, как это сделано: если сломать обычное получение контента (цепочка 301→204 или JS‑редирект), модель уходит в fallback и сама собирает вызов curl, а в аргументе этого вызова содержится URL, где спрятана подстановка $(…).

В лайтовом примере атаки мы получили выполнение whoami, в серьезном — загрузку и запуск полезной нагрузки. Срабатывает не всегда, но достаточно часто, чтобы это считалось практическим риском.

Проверили технику на разных LLM — получили схожее поведение. Мораль: полагаться на выравнивание моделей (LLM alignment) как на «границу безопасности» нельзя.

Всю механику этой атаки с примерами HTTP-ответов и сниппетами кода на Python, а также рекомендации по защите, читайте в статье "Атака через OpenClaw: когда ваша LLM делает RCE".

Кстати, интересно ваше мнение: это скорее prompt injection (ставьте смайлик в очках) или это уязвимость агента (ставьте смайлик пришелец). По вашим реакциям посмотрим, куда склонится комьюнити.
  • 🔥 16
  • 👾 11
  • 😎 3
  • ❤‍🔥 2
  • 👌 2
  • ❤ 1
Post #174 2.66K
Служба WebClient, которая в Windows реализует протокол WebDAV, с точки зрения атакующего представляет особый интерес, так как позволяет осуществлять релей-атаки на другие протоколы (например, на LDAPS), что в свою очередь позволяет делать релей на контроллер домена.

В частности, атакующий может повысить привилегии и даже полностью захватить домен, если служба WebClient установлена на сервере SCCM и выполнены следующие условия:

— либо подпись LDAP, либо привязка канала LDAPS отключена хотя бы на одном контроллере домена,
— включена автоматическая принудительная установка клиента (сlient push installation),
— включен NTLM Fallback.

На скриншоте выше представлен сценарий эксплуатации SCCM-сервера через механизм установки клиента (client push installation). Похожая картина будет и при атаках на принудительную аутентификацию (coerce).

Как защищаться?

Рекомендуем отключить службу WebClient на SCCM-серверах. Если это невозможно, мониторьте подозрительные обращения по протоколу WebDav от SCCM-сервера.

О других техниках атак на System Center Configuration Manager (SCCM), а также о методах их детектирования вы можете узнать, если посмотрите запись доклада Александра Родченко и Глеба Иванова "C2 от Microsoft: Что может пойти не так, если SCCM окажется не в тех руках".
  • 👍 9
  • ❤ 1
  • 🔥 1
  • 👌 1
Post #173 2.73K
Если вы занимаетесь пентестом беспроводных сетей, то наверняка встречали инфраструктуры на основе 802.11r (Fast BSS Transition) — это стандарт быстрого роуминга, который активно используется в корпоративных сетях, на производстве, в складских комплексах и т.д. Но вот незадача: ни HashCat, ни John the Ripper такие хэши не поддерживали.

Единственный рабочий вариант, который существовал до недавнего времени — использование однопоточного python-скрипта, который к тому же поддерживает только EAPOL и не умеет работать с PMKID. Это лучше, чем ничего, и такой вариант можно было использовать в качестве PoC и подбора по словарю из пары тысяч паролей. Но о каких-либо серьезных атаках по подбору пароля на GPU говорить не приходилось.

Причина в том, что криптографическая схема в случае 802.11r несколько отличается от классического WPA-PSK. Ключ PMK считается так же — через PBKDF2-HMAC-SHA1, но дальше начинается своя кухня: цепочка из трёх шагов на HMAC-SHA256, плюс финальный MIC через AES-128-CMAC. И всё это с дополнительными параметрами (MDID, R0KH-ID, R1KH-ID), специфичными для конкретной беспроводной сети.

Именно это пришлось реализовать нашим специалистам, когда они столкнулись с 802.11r на одном из проектов по анализу защищённости. И в итоге получился новый модуль для HashCat, с поддержкой обоих типов хэшей, PMKID и EAPOL для FT-PSK:
https://github.com/hashcat/hashcat/pull/4645

Так что если на очередном пентесте вам попадётся сеть с 802.11r — больше не нужно довольствоваться однопоточным скриптом. Скармливаем пойманные хэши в HashCat и едём дальше!
  • 🔥 16
  • ❤‍🔥 8
  • 👏 4
  • 👍 1
  • 🥰 1
Post #172 3.96K
Чтобы сделать вредоносные файлы невидимыми для систем защиты, атакующие используют различные техники. Самые известные — это руткиты и буткиты. Но иногда достаточно и более простых механизмов. Недавно мы наткнулись на технику маскировки процессов в Linux через bind mount поверх /proc.

Когда утилита для монтирования файловых систем mount запускается с флагом bind, это позволяет "приклеить" одну директорию или файл в другую точку файловой системы. При этом исходные данные в целевой точке становятся невидимыми; фактически, они перекрываются содержимым примонтированного пути.

Атакующий с root-доступом может использовать это для маскировки процессов.

Например, процесс с PID 1234 можно спрятать через mount:

mount --bind /tmp/empty /proc/1234 


После этого содержимое настоящего /proc/1234 перекрывается пустой директорией. Утилиты вроде ps, top или htop читают данные именно из /proc, поэтому для них процесс как будто исчезает. При этом сам процесс продолжает работать: слушает порты, выполняет код, держит соединения.

Иногда делают еще аккуратнее: поверх /proc/<pid>/exe или /proc/<pid>/cmdline монтируют другой файл. Тогда процесс вроде бы виден, но его бинарь или аргументы подменены.

Как ловить атаку?

Проверка mount-таблицы помогает обнаружить сокрытие процесса. Утилиты mount или findmnt покажут bind mounts внутри /proc. В нормальной системе их там почти не бывает.

С точки зрения правил обнаружения для SOC, отслеживаем запуски утилиты mount с соответствующими аргументами: "--bind", "-B", "-o bind" и "/proc")

Также имеет смысл мониторить системный вызов mount на уровне ядра. Например, для auditd простейшее правило аудита может выглядеть так:

auditctl -a always,exit -F arch=b64 -S mount -k mount_monitor 


В файле /var/log/audit/audit.log будут фиксироваться события монтирования, включая bind mounts. При анализе стоит обращать внимание на операции, где точкой монтирования выступают пути внутри /proc.
  • 👍 27
  • 🔥 11
  • ❤‍🔥 2
  • ❤ 2
Post #171 4.65K
Только отгремел День бэкапов — а на дворе уже 1 апреля, когда в нашей стране отмечают другой большой праздник. Мы тоже решили не оставаться в стороне: отпразднуем этот день открытием собственного сайта!

Да-да, теперь у нас есть сайт в старом добром Интернете, где все наши новости можно читать без регистрации и даже без сдачи биометрии:

https://purpleshift.io/ru/purple/

Кстати, если у вас есть коллеги (партнеры, руководители, родственники), которые лучше понимают английский язык, чем русский — на этот случай имеется английская версия нашего блога:

https://purpleshift.io/purple/

Остальные разделы сайта пока в разработке, так что про них расскажем позже.

А наш ТГ-канал purpleshift продолжит обновляться, как и прежде. Просто не все наши материалы помещаются в краткий телеграмный формат. Но мы будем анонсировать все новинки здесь, по мере появления на сайте. Stay tuned!
  • 🔥 29
  • 👍 6
  • ❤ 5
  • 🤡 2
  • ❤‍🔥 1
  • 🤔 1
  • 🦄 1
Post #170 4.22K
Раньше мы каждый год выпускали два отдельных отчёта об инцидентах: от команды Managed Detection and Response (MDR) и от команды Inсident Response (IR). Для примера можно посмотреть такую статистику за 2023 год и за 2024 год.

А в этом году сделали один общий отчёт — и сейчас расскажем, почему.

Сами по себе статистика инцидентов у клиентов нашего MDR неплохо отражает реальный ландшафт угроз, поскольку клиенты сервиса есть во многих странах мира и во всех секторах экономики. На основе этой статистики за разные периоды можно даже предсказывать некоторые тенденции ближайшего будущего.

Однако для более детального изучения угрозы желательно её наблюдение на всех этапах. А в условиях MDR это невозможно, поскольку вредоносная активность обнаруживается и предотвращается на ранних стадиях атаки, не успев развиться до ущерба.

Зато в сервисе IR ситуация обратная: когда клиенты обращаются к этому сервису, зачастую ущерб уже налицо, и в рамках расследования нередко удается восстановить все стадии атаки.

И в подавляющем большинстве случаев клиентские базы MDR и IR не пересекаются. Ведь хорошая работа MDR при условии полного покрытия инфраструктуры состоит в том, чтобы не допустить того этапа атаки, когда без IR не обойтись; с другой стороны, факт подключения IR, особенно когда уже есть ущерб, означает либо отсутствие MDR, либо проблемы с покрытием.

Поэтому можно с уверенностью утверждать, что статистики инцидентов MDR и IR покрывают оба возможных профиля:

— инфраструктуры, защищенные MDR, где атаки были обнаружены и предотвращены на ранних стадиях, и попали в статистику MDR,
— инфраструктуры без MDR либо такие, где инциденты были пропущены и не попали в статистику MDR, но попали в статистику IR.

Короче, объединение статистик MDR и IR позволяет лучше понимать нынешние и грядущие угрозы. Как это получилось в деталях — смотрите в глобальном отчёте.
  • 👍 11
  • ❤ 6
  • 🔥 2
  • 🥰 1
Post #169 4K
Сегодня, 31 марта, айтишники и сочувствующие им граждане отмечают День резервного копирования. В этот день много говорят о необходимости делать бэкапы, чтобы спастись от Дня дурака, который наступит 1 апреля.

А мы для разнообразия напомним другое: не все бэкапы одинаково полезны. В частности,

— сервисы резервного копирования могут быть использованы для компрометации вашей системы, особенно если это сервисы на основе протокола NDMP;

— работа с бэкапами кустов реестра позволяет обойти проверки безопасности и извлекать секреты из реестра Windows без привилегий SYSTEM;

— неприятные последствия может повлечь за собой поспешное восстановление из бэкапов после инцидента, если сами бэкапы были скомпрометированы на момент создания.
  • 😁 7
  • 👍 5
  • ❤ 2
  • 🤷‍♂ 1
Post #168 2.19K
Решения компании 1С сейчас лидируют среди систем управления ресурсами предприятия (ERP) на российском рынке. Поэтому выросло и число атак через программное обеспечение 1С: как мы уже рассказывали, атакующие используют тривиальные ошибки в настройках, включая аккаунты с пустыми паролями.

А сегодня разберём другой кейс: в последнее время на пентестах и в реальных атаках встречается использование запуска командных оболочек от ERP. На скриншоте выше — пример проведения разведки с помощью таких команд.

Как обнаружить:

В серверной архитектуре 1С обычно работают несколько ключевых процессов:

ragent.exe — агент сервера 1С. Он отвечает за управление кластером, запуск рабочих процессов, распределение нагрузки.

rphost.exe — Remote Procedure Host. Это основной рабочий процесс платформы. В нём исполняется серверная логика: код конфигурации, запросы к СУБД, бизнес-процессы.

rmngr.exe — Cluster Manager. Это компонент управления кластером, отвечающий за балансировку, распределение сеансов и контроль рабочих процессов.

Нормальным поведением перечисленных ключевых процессов считается работа с СУБД, обработка клиентских запросов — но не запуск командных оболочек (cmd, powershell и др.), которые используются для атак.

Детектирующее правило:

logsource:
category: process_creation
product: windows
detection:
parent_process:
ParentImage|endswith:
- '\sqlservr.exe'
- '\rphost.exe'
- '\rmngr.exe'
- '\ras.exe'
interpreter_image:
Image|endswith:
- '\cmd.exe'
- '\powershell.exe'
- '\pwsh.exe'
- '\wscript.exe'
- '\cscript.exe'
interpreter_originalfilename:
OriginalFileName:
- 'Cmd.Exe'
- 'PowerShell.EXE'
- 'pwsh.dll'
- 'WScript.exe'
- 'CScript.exe'
condition: parent_process and (interpreter_image or interpreter_originalfilename)


В зависимости от размеров инфраструктуры, правило можно разбить. Например, для cmd, powershell и разделить серверные приложения.
  • 👍 15
  • 😁 3
Post #167 2.21K
Борьба с зарубежным ПО, как правило, обосновывается требованиями безопасности. Но слишком резкий импортозамес иногда напоминает последствия «сухого закона», когда лишенные привычного алкоголя граждане не перестают пить — а просто переходят на более сомнительные напитки. И в ближайшее время мы увидим ещё множество проблем безопасности из-за вынужденного перехода пользователей и целых компаний на «альтернативные» мессенджеры и видеоконференции.

Сейчас наши эксперты наблюдают новую вредоносную кампанию группировки Head Mare (Rainbow Hyena), нацеленную на российские организации. Злоумышленники используют скомпрометированные сервера TrueConf, распространяя заражённые дистрибутивы клиентского приложения для видеоконференций TrueConf; при установке такого приложения на устройство жертвы ставится бэкдор.

Предполагается, что основным вектором атаки является уязвимость серверов TrueConf, выявленная в августе 2025 года и уже эксплуатировавшаяся в прошлом году.

Рекомендации по защите:

В первую очередь рекомендуется установить исправленную версию сервера TrueConf, а также убедиться, что клиентские дистрибутивы, загружающиеся с вашего сервера TrueConf, имеют действительную цифровую подпись (вредоносные дистрибутивы её не имеют).

Кроме того, атаку можно обнаружить с помощью EDR, SIEM или MDR-сервисов на основе отслеживания следующих событий и процессов:

— Подмена файлов-клиентов приложения TrueConf на сервере TrueConf в директории C:\Program Files\TrueConf Server\ClientInstFiles\;

— Обращения к подозрительным доменам от процесса клиентского приложения C:\Program Files\TrueConf\Client\TrueConf.exe;

— Загрузка подозрительных библиотек процессом клиентского приложения C:\Program Files\TrueConf\Client\TrueConf.exe;

— Обращения процесса C:\Program Files\TrueConf\Client\TrueConf.exe к IP-адресам из необычных регионов;

— Создание подозрительных файлов и процессов клиентским приложением C:\Program Files\TrueConf\Client\TrueConf.exe;

— Создание подозрительных дочерних процессов от имени серверного процесса tc_webmgr.exe.

Продробности и дополнительные индикаторы компрометации — в статье "Кампания Head Mare с бэкдором PhantomPxPigeon и зараженными установочными файлами ПО TrueConf"
  • 👍 18
  • 💩 4
  • 👎 1
Post #166 1.9K
Вы когда-нибудь задумывались о персональном ИИ-помощнике, который делает всё, что вы пожелаете? Как в фильме Her. Сейчас такая фантазия как будто почти реальна: LLM-агент OpenClaw быстро набирает популярность.

Но как мы предсказывали ещё в прошлом году, LLM-агенты становятся популярным вектором атак. И к уже известным проблемам безопасности OpenClaw недавно добавилась ещё одна, о которой расскажем сегодня.

Когда работаешь с LLM-агентами, легко попасть в ловушку неправильных ожиданий. Кажется, что даёшь агенту простую задачу: посмотри страницу, собери данные, проанализируй. Но на практике вы делегируете не только цель, но и способ её достижения. В этом и проблема.

LLM-агенты принимают решения на основе языковой модели, а действуют с помощью кода, вызовов API или утилит ОС. При слабых ограничениях на действия и доступ к данным агент может повести себя слишком самостоятельно. Такова природа больших языковых моделей: они выдают статистически уместные ответы на основе текущего контекста. Здесь ключевое слово - статистически.

Можно возразить, что существуют тщательно прописанные prompt’ы. Но LLM обучены быть полезными, и если не получается достичь результата описанным способом, они могут искать альтернативные пути решения задачи.

Иногда эти альтернативы разумные. А иногда - выходящие далеко за рамки того, что предполагал пользователь. В частности, действия агента могут приводить к компрометации узла, на котором работает LLM-агент.

Так получилось и в нашем случае: мы проанализировали агента OpenClaw и нашли способ добиться RCE. При посещении специально подготовленной веб-страницы агент OpenClaw выполняет команды оболочки в контексте пользователя, под которым запущен процесс.

В ответ на наш репорт вендор сообщил, что рассматривает описанное поведение как prompt injection, а не дефект агента, и потому не квалифицирует его как уязвимость.

Мы понимаем их позицию, но считаем риск классовым и заслуживающим огласки. Поэтому публикуем минимально необходимые практические меры снижения риска обнаруженной нами атаки:

1. Запускайте OpenClaw в Docker-контейнере, изолировав его от чувствительных данных и инфраструктуры.

2. Ограничивайте инструменты, например, установив подтверждение всех системных команд exec.ask=always.

3. По возможности отключите использование exec.

4. В средах с высокими требованиями к безопасности лучше вообще воздержаться от использования OpenClaw.

Общий вывод: с агентами на базе LLM мы делегируем не только «что сделать», но и «как именно». Без строгих ограничений это чревато неожиданными и опасными последствиями.

Большой технический разбор нашей находки выпустим позже, не переключайтесь.
  • 👍 15
  • 🗿 4
  • ❤ 3
  • 🔥 3
  • 😁 2
  • 👌 1
Post #165 2.34K
Недавно наши пентестеры разбирались с утилитой PEAS для работы с Exchange ActiveSync (EAS) — и наткнулись на интересную проблему. При попытке получить листинг файловых шар через Document Library Access утилита падала с ошибкой 141 (LegacyDeviceOnStrictPolicy). При этом проверка учётных данных через --check работала нормально.

Оказалось, что раньше PEAS работал без ошибки, потому что серверы не требовали обязательного прохождения процедуры Provisioning. А когда администраторы начали включать строгие политики безопасности на Exchange, серверы стали требовать прохождения этой процедуры.

Provisioning в EAS — это механизм согласования политик безопасности между устройством и сервером через стандартный двухшаговый обмен, где клиент принимает политики безопасности сервера, а сервер в ответ разрешает дальнейшие операции. По итогу сервер выдает PolicyKey — токен доверия для конкретного аккаунта/устройства/сервера. Этот токен меняется при первом подключении нового устройства или когда админы обновляют политики; токен также может меняться от бездействия (длительного отсутствия входа в почту).

То есть без валидного PolicyKey сервер просто отклоняет запросы к данным. Интересный момент: сервер не может реально проверить, применило ли устройство политики — он полностью доверяет клиенту. Достаточно просто пройти протокольный обмен и сказать "да, я всё применил".

Раньше, когда серверы не требовали прохождения Provisioning, утилита PEAS просто отправляла PolicyKey=0. Но теперь это может не работать, поскольку сервер теперь может потребовать валидный токен.

Для решения этой проблемы наши эксперты пропатчили PEAS, добавив автоматический Provisioning перед UNC-операциями. Теперь утилита сначала выполняет двухфазный обмен с сервером, получает валидный PolicyKey и только потом делает запросы к файловым шарам. Дополнительно добавили флаг --policy-key для переиспользования ключа при массовых операциях, это убирает лишние запросы и уменьшает шум в логах.

Если хочется поглубже понять механизм EAS и исторический контекст утилит, можно посмотреть подробную статью от создателей PEAS, опубликованную ещё в 2016-м. Похоже, что тема всплывает раз в пять лет, и мы как раз подвезли актуализацию.

Что делать защитникам:

Необходимо следить за Microsoft Exchange как за критичным узлом, который зачастую становится "открытой дверью" к почте, файлам и внутренним ресурсам. Поэтому:

— По возможности вырубайте легаси-функциональность (EAS Document Library/UNC и прочие пережитки), сокращайте исключения и совместимость со всем подряд.

— Если отключить нельзя, используйте поведенческий контроль клиентов EAS: проверяйте, что перед доступом к данным всегда есть нормальный двухфазный Provisioning, следите за всплесками Status=141/142 и HTTP 449, смотрите динамику PolicyKey (внезапные смены/реюз между устройствами — знак тревоги).

— Параллельно ужесточайте базовую гигиену: регулярно пересматривайте политики, чистите старые профили и временные исключения, валидируйте сторонние клиенты до продакшена.

— Ограничивайте срок жизни кэшированных PolicyKey и фиксируйте их привязку к аккаунту/серверу/устройству. Тащите всё это в SIEM с привязкой "аккаунт >> устройство >> PolicyKey >> операции". Потому что в Exchange может быть всякое: смешанные политики, странные клиенты, исторические хвосты конфигураций — и это регулярно выстреливает.

Главная мысль: EAS по дизайну доверяет заявлению клиента о принятии политик. Это нормально для протокола, но с точки зрения защиты нельзя опираться только на EAS. Добавляйте поведенческий мониторинг, внешнюю проверку комплаенса (MDM/Intune) и минимизируйте поверхность атаки за счёт отключения ненужного наследия.
  • 👍 15
  • 🔥 10
  • ❤ 6
  • 🗿 3
Post #164 1.83K
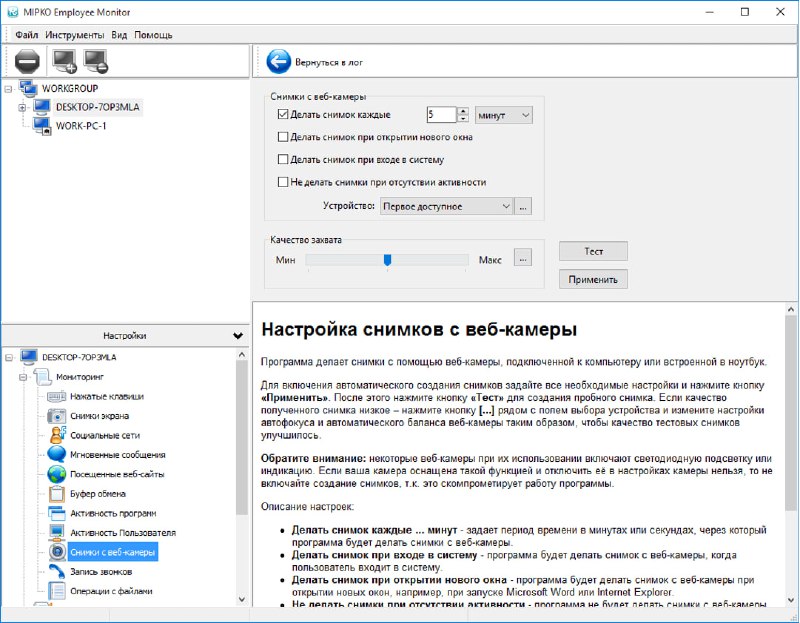
Mipko Employee Monitor — это утилита для мониторинга и контроля деятельности сотрудников на рабочих станциях. Она позволяет отслеживать активность сотрудников, включая использование приложений, посещение сайтов и отправку электронных писем. Утилита также предоставляет функции для фиксации скриншотов и записи нажатий клавиш.

Однако злоумышленники тоже нашли применение данному инструменту — он может быть использован для шпионажа и кражи конфиденциальных данных.

В частности, так делает APT-группа Librarian Ghouls (Rare Wolf, Rezet). Они рассылают жертвам фишинговые письма с архивами, имитирующими различные документы на русском языке (платёжные поручения, накладные). При открытии архива запускается установщик, который доставляет на компьютер жертвы дополнительные вредоносные модули. И среди прочего, в скомпрометированную систему устанавливается Mipko Employee Monitor, что позволяет атакующим шпионить за жертвой.

Как детектировать:

Для обнаружения Mipko Employee Monitor обратите внимание на создание, запуск и загрузку следующих файлов:

MPK.exe
MPK64.dll
MPK.dll
MpkL64.exe
MpkHCA.dll
MPKView.exe
Lsynchost.exe


Кроме того, программа регистрирует в системе службу с именем "MainLSyncHost" (Local Synchronization Host)" и исполняемым файлом Lsynchost.exe. Эту активность можно обнаружить:

— в журналах ОС Windows: события создания служб в журнале System (event id 7045) и Security (event id 4697),

— в реестре: за счет создания специфичных ветвей и ключей, связанных с сервисом, в директории HKLM\SYSTEM\CurrentControlSet\Services\MainLSyncHost.

Также из-за наличия функционала перехвата ввода с клавиатуры, данное ПО может детектироваться AV- и EDR-решениями с вердиктами keylogger — в случае отсутствия настроенных исключений (напомним, что Mipko Employee Monitor используется во многих организациях как легитимный продукт, а значит, антивирусы могут игнорировать эту программу).
  • 👍 14
  • 🤪 4
  • ❤ 2
  • 💯 2
  • 😴 1
Post #163 2.03K
В западной прессе хакеры обычно китайские, русские или северокорейские. А в восточной прессе чаще всего пишут про американских, израильских и украинских хакеров.

Но мы знаем, что такие специалисты есть не только в этих шести странах. Просто их незаслуженно обходят вниманием. Давайте исправлять этот перекос.

Вот например, в прошлом году эксперты из нашей команды MDR разоблачили довольно непростую вредоносную кампанию Horabot, нацеленную на жителей Мексики (более 5 тыс. жертв).

Атака начинается с поддельной капчи на скомпрометированном сайте: под видом "проверки на робота" жертву убеждают выполнить команду, которая приводит к скачиванию вредоносных компонент с сайта злоумышленника. Среди них — банковский троян, крадущий пароли жертвы, а также программа для сбора почтовых адресов и рассылки фишинговых писем с вредоносным вложением.

Но самая интригующая часть этого расследования — атрибуция. Хотя большинство жертв находятся в Мексике и троян показывает им фальшивые страницы банков на испанском языке — однако наши эксперты полагают, что вредонос пришёл из Бразилии.

И не только потому, что в коде найдены комментарии на бразильском португальском. Часть этих комментариев написана очень формальным языком, что выдаёт использование LLM (то есть это могло быть "ложным флагом"). Но есть и комментарии на сленге, который понятен только носителям живого бразильского диалекта португальского языка. Например, слово "sapecar".

Что означает это слово, а также другие подробности расследования и индикаторы компрометации для выявления атаки Horabot — смотрите в статье Матеуса Сальгадо и Доменико Кальдареллы.
  • 🔥 16
  • 👍 6
  • ❤ 4
  • 🤯 1
Post #162 2.64K
У экспертов по анализу защищённости часто возникает ситуация, когда во время пентеста уже получен доступ к внутренней инфраструктуре, а что интересного есть в этой инфраструктуре — непонятно.

Так как многие используют Kubernetes для разворачивания сервисов, кластеры K8s могут быть одной из интересных целей. Но их ещё нужно найти и понять, что в них.

Один из способов обнаружить ноды — найти, какие хосты используют SSL-сертификат с common name Kubernetes Ingress Controller Fake Certificate. Например, это можно сделать с помощью скрипта для nmap ssl-cert.

На одном из проектов мы нашли таким способом 47 нод. И по некоторым хостнеймам и подсетям сделали вывод, что кластер не один. Но как узнать, какие сервисы запущены в этих кластерах?

Благодаря использованию одного места для сбора всей информации, мы выяснили, что у нас уже есть учётные данные пользователя с привилегией sudo на этих хостах после успешной атаки Password Spray.

В директории /etc/kubernetes/ на мастер-ноде был конфиг не только самой ноды, но и администратора кластера, что позволило не тратить время на повышение привилегий.

Так как Kubernetes API доступен был только на localhost мастер-ноды, использовали опцию -D при подключении по SSH к ноде, и с конфигом администратора кластера получили полный доступ к API. А затем собрали всю необходимую информацию о кластере K8s, добавив опцию для игнорирования недоверенного сертификата и переменную окружения для работы через прокси:

export KUBECONFIG=~/admin.conf
HTTPS_PROXY=socks5://127.0.0.1:1080 kubectl --insecure-skip-tls-verify=true cluster-info


Список нод поможет оценить размер кластера и отметить хосты, которые к нему относятся:

kubectl get nodes -o wide


По названиям неймспейсов можно попытаться понять, какие сервисы запущены в кластере (например, minio или keycloak):

kubectl get namespaces


Для получения полных конфигов подов можно использовать вывод в формате yaml. Из результата выполнения команды можно получить список подов, информацию о том, какие образы используют контейнеры, на каких портах слушают сервисы, что примонтировано в файловую систему пода. Зачастую из передаваемых в контейнеры переменных окружения можно получить учетные данные или полезные параметры конфигурации сервисов. Параметр -A для команды позволит получить сведения сразу для всех пространств имен:

kubectl get pods -A -o yaml


В списке ingress-ов можно увидеть имена виртуальных хостов и правила маршрутизации трафика (на уровне L7):

kubectl get ingress -A


Пример вывода:

NAMESPACE  NAME  CLASS  HOSTS      ADDRESS    PORTS
minio minio nginx s3.domain.local 10.10.10.10 80, 443


Configmap-ы предназначены для хранения настроек в виде пар "ключ-значение". И хотя не рекомендуется хранить в них учётные данные, ключи и подобные настройки, они там все равно встречаются. А ещё скрипты, настройки coredns и другие конфигурационные файлы. Поэтому заглянем и туда:

kubectl get configmaps -A -o yaml


Все секреты мы не забираем, а только получаем список. Если по конфигам подов или по названию секрета видим, что используется значение секрета, который нам нужен, то получаем только это значение:

kubectl get secrets -A
kubectl get secret -n <namespace> <secret_name>


Если в списке ingress-ов мы обнаружили виртуальный хост, а при обращении к нему получаем 404, то для поиска нужного пути можно посмотреть логи nginx (для каждого пода ingress-nginx-controller).

kubectl get logs -n ingress-nginx ingress-nginx-controller-<id>


Анализируя полученную информацию, мы можем получить доступ к сервисам. Например, мы в конфиге пода обнаружили, что используются значения из секрета minio для доступа к S3-хранилищу на узле minio.minio.svc.cluster.local. А в списке ingress-ов увидели, что виртуальный хост s3.domain.local доступен на хосте 10.10.10.10, и входящий трафик на порт 443/TCP перенаправляется на под minio в неймспейсе minio. Используя значения секрета, мы получили доступ к содержимому бакетов в S3-хранилище и реализовали один из бизнес-рисков.
  • 🔥 17
  • 👌 4
  • 🥱 4
  • ❤ 1
Post #161 2.37K
За последние несколько лет рынок наполнился огромным количеством новых процессорных чипов из Поднебесной — в частности, на базе стандарта RISC-V, со своими собственными реализациями ядер и расширениями.

Вот и наши эксперты, которым нужно было исследовать безопасность не особо известного микроконтроллера, столкнулись с тем, что не могут проанализировать прошивку устройства, поскольку IDA Pro не имеет поддержки ряда специфических инструкций и кастомных расширений.

Поэтому пришлось:

— пройти квест по определению, что это за инструкции; оказалось, что они относятся к расширению P Extension (оно же Packed SIMD Extension);

— на основе раннего черновика спецификации P Extension написать декодер для этих инструкций и подружить его с IDA Pro;

— разработать лифтер для правильной генерации псевдокода (без ассемблерных вставок и пропущенных операций).

Подробности этого приключения по улучшению инструментария — в статье "От скалярной тоски к SIMD-эйфории: как подружить IDA Pro с инструкциями RISC-V P Extension".
  • 🔥 20
  • 👍 6
  • 🆒 3
  • ❤ 1
  • 🤔 1
Post #160 4.61K
Как вы наверняка помните, недостаток котиков в нашей ленте мы обычно компенсируем другими животными — из ежегодных отчётов наших команд MDR и Incident Response (2023 год, 2024 год).

Аналогичная статистика по инцидентам 2025 года тоже вскоре будет опубликована. Однако в этом году защитники прав животных попросили нас не изображать рептилий в качестве угроз. Поэтому в новых отчётах нам придётся впечатлять вас голой аналитикой.

Вот например, наш коллега Сергей Солдатов решил посмотреть, как в разные годы (2020-2025) распределялись по отраслям разные типы высококритичных инцидентов (социальная инженерия, человекоуправляемые атаки, атаки ВПО).

В частности, на диаграмме выше показано количество человекоуправляемых атак в разных сферах. Можно заметить всплеск таких атак на Госсектор и Телекомы в 2021 году. А в 2022 году сильно досталось средствам массовой информации — при том, что в 2020 и 2021 годах интерес атакующих к СМИ отсутствовал вовсе.

Однако следует ещё раз уточнить, что данный график отражает только один тип атак — но есть и другие. Так, в 2025 году значительно выросло число критичных инцидентов типа «социальная инженерия» в таких отраслях, как СМИ, Госсектор и Финансы. А поскольку за успешным фишингом обычно следуют более разрушительные типы атак, мы получаем очень неутешительный прогноз для этих отраслей.

Подробности о распределении других критичных инцидентов по отраслям, а также гипотезы о том, почему они так распределялись — смотрите в статье "История критичных инцидентов".
  • 👍 9
  • ❤ 4
  • 🔥 4
  • 👀 1
Post #159 2.61K
Продолжаем истории из нашей практики, связанные с небанальными методами удалённого доступа атакующих.

В одном из инцидентов злоумышленник модифицировал конфигурацию веб-сервера Apache так, чтобы все запросы, поступающие на URL-адрес https://[имя домена]/proxy/tunnel, проксировались на внутренний адрес 127.0.0.1:8080, с использованием протокола WebSocket Secure. Данный протокол предоставляет двунаправленную шифрованную связь между клиентом (атакующим) и сервером. Содержимое файла конфигурации веб-сервера Apache выглядело так:

<VirtualHost *:443>
...
<Location "/proxy/tunnel">
ProxyPass "wss://127.0.0.1:8080"
</Location>
</VirtualHost>


А на порту 8080 для создания канала связи злоумышленник запустил утилиту chisel в качестве сервера, ожидающего входящих соединений, с параметром –reverse.

Эти действия позволили злоумышленнику создать туннель и получить доступ к внутренней инфраструктуре, маскируя сетевую активность под легитимный шифрованный HTTPS-трафик.

Как детектировать:

Для обнаружения подобных способов создания туннеля необходимо:

— отслеживать изменения файлов конфигурации веб-сервера Apache и проверять их на наличие строк «ProxyPass» и «wss://»,

— мониторить запуски процессов с подозрительными аргументами (например --reverse, --socks5),

— выявлять в журналах веб-приложений аномальное количество обращений к URL-адресам, не предусмотренных в логике веб-приложения.

Также рекомендуется размещать публично доступные серверы в отдельном сегменте (DMZ) и мониторить активность на них средствами EDR.
  • 🔥 21
  • ❤ 7
  • 🤗 3
  • 👍 1
Post #158 3.38K
Недавний кейс из нашей практики — отличный пример того, как атакующие комбинируют легитимные инструменты для устойчивого удалённого доступа.

После получения повышенных привилегий на хосте злоумышленники установили Velociraptor, указав в server_urls свой C2-сервер. С этого момента дальнейшее управление системой осуществлялось уже через него.

После базового Discovery они скачали Visual Studio Code (Insiders) и установили VS Code Tunnel в режиме Install as a service. Важно понимать, что под капотом это не «настоящий сервис», а запись в Run-ключе:

HKU\.DEFAULT\Software\Microsoft\Windows\CurrentVersion\Run

Далее — ещё немного Discovery, но уже через VS Code Server, и следующим шагом появляется Cloudflare Tunnel.

Однако и этого атакующим оказалось недостаточно: финальным штрихом стал Zoho Assist в режиме Unattended Remote Session, позволяющий подключаться к системе без какого-либо подтверждения со стороны пользователя.

Итог: четыре независимых канала удалённого доступа к одному хосту. При этом три из них — Velociraptor, VS Code Tunnel\Server и Zoho Assist — встречаются не так уж часто.

Что здесь можно детектировать?

— Velociraptor. Если вы его не используете, любое появление этого сервиса уже будет красным флагом. А если используете — контролируйте список допустимых серверов, так как обращения к посторонним server_urls выглядят крайне подозрительно.

— VS Code Tunnel. Обращайте внимание на установку сервиса, будут примерно такие команды:

    code-insiders.exe tunnel --accept-server-license-terms service install
    code-tunnel.exe tunnel service uninstall


Также смотрите на Run-ключ:

    key: Visual Studio Code - Insiders Tunnel
    value: ...\code-insiders.exe --verbose --cli-data-dir C:\Windows\system32\config\systemprofile\.vscode-insiders\cli tunnel service internal-run --log-to-file C:\Windows\system32\config\systemprofile\.vscode-insiders\cli\tunnel-service.log


И ещё обращайте внимание на активность от процессов VS Code Server, расположенных по пути .vscode\cli\servers\ или .vscode-insiders\cli\servers\.

— Cloudflare Tunnel. При старте/остановке сервиса и запуске туннеля генерируется EventID: 1 в журнале Application (Source: Cloudflared) — это удобная точка для алертов.

— Zoho Assist. Для его использования в режиме Unattended требуется запуск сервиса Zoho Assist – Unattended Support, реализованного в файле ...\ZohoMeeting\UnAttended\ZohoMeeting\ZohoURSService.exe.
  • 🔥 17
  • 👍 5
  • 🤡 3
  • ❤ 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →