TGViewer
Channel Public Channel
Инженер Контекста

Инженер Контекста

@proitru

Евгений Левашов, контент-лид в VK Tech, отвечаю за VK Cloud, VK Data Platform, Tarantool и другой технохардкор. Редактирую ИТ-компании, консультирую, учу. Здесь всё про Ai в контенте, дату, облака и остальной ИТ.

Писать — @levashove

CC BY-NC-SA 4.0
Subscribers
943
Photos
607
Videos
47
Links
2K

Showing posts older than #2952 · Back to latest

Older Posts 18 shown
Post #2951 109

Forwarded from TechnoME: Multimediamind 🏴‍☠️

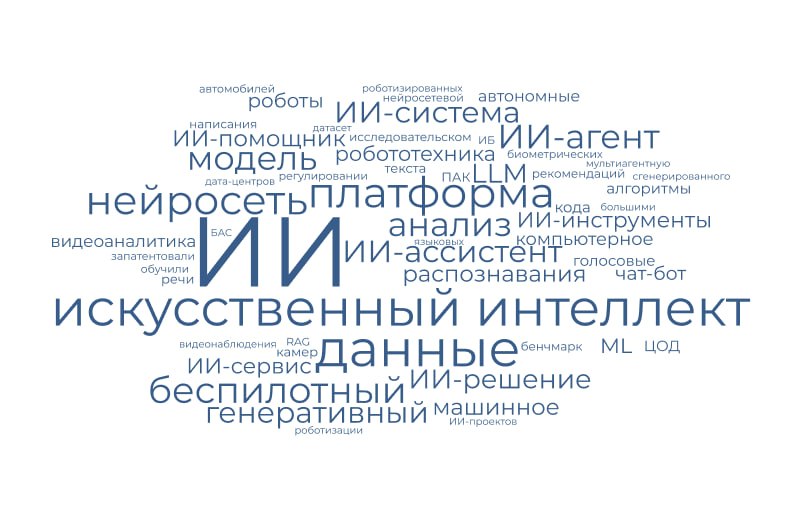
«Ядро» ИИ в медиа

ICT.Moscow изучил 4,7 тысячи публикаций об ИИ в русскоязычных медиа, чтобы выяснить, из каких составных частей складывается «ядро» темы, и какая связь прослеживается с другими технологиями

Что обнаружили:

- большинство инфоповодов об ИИ ориентированы на массового читателя и лишены технологических деталей; 

- более трети публикаций явно затрагивают хотя бы одну тему внутри ИИ. Чаще всего — модели и их типы, а также агентный ИИ; 

- физический ИИ в русскоязычной медиаповестке пока представлен слабо, как и AGI;

- в 14% новостей помимо содержатся упоминания других технологических направлений — робототехники, инфраструктуры и прочих.

Подробнее 👈
  • 👍 3
  • 🔥 2
Post #2950 126
Будет ласковый дождь
  • 🔥 4
  • ❤‍🔥 3
  • 😭 2
Post #2949 136
Интернет, который мы потеряли
  • ❤‍🔥 3
  • 😁 2
  • 🤯 1
Post #2948 134
Ваши скиллы возможно написаны под модель, которой уже нет

Anthropic удалила больше 80% системного промпта из Claude Code, и качество на их тестах не упало. Пересказывать статью не буду, интереснее, что из этого следует, если вы сами пишете агентов и скиллы.

1. Половина ваших правил — заплатки на провалы прошлых версий. «Не начинай с общих фраз», «не используй конструкцию X» — вы это добавляли, потому что модель так делала. Перестала делать, и правило работает вхолостую, а иногда против вас: запрет отнимает у сильной модели право решать по ситуации. Что сделать: пройти по скиллам и рядом с каждым правилом поставить дату и ошибку, из-за которой оно появилось. Где ошибку не вспомнить или ей больше полугода — кандидат на удаление.

2. Резать вслепую нельзя, а мерить нечем. У Anthropic были свои прогоны: удалили кусок промпта, прогнали набор задач, сравнили результат. Поэтому они и могли уверенно сказать «сняли 80%, качество то же». У нас так не выходит. Меняем скилл, смотрим на два поста и решаем, что стало лучше. А на третьем оказывается, что модель перестала расставлять ссылки, просто в первых двух ссылок и не было.

3. Конфликтуют не правила, а источники правил. Редстандарт, скилл канала, CLAUDE.md, бриф — четыре места, где написано про тон. Модель разгребает противоречие вместо работы. Решение не в сокращении, а в иерархии: тон и позиция живут только в скилле канала, фактура и грабли — только в CLAUDE.md, задача выпуска — только в брифе. Правило встретилось дважды — одно вхождение удаляется, а не уточняется.

4. Эталонные тексты в скиллах, скорее всего, вредят. Приложил три идеальных поста — получил четвёртый такой же по каркасу. Меняем образцы на структуру: рубрикатор, обязательные элементы, признаки плохого лида. Образец оставляем там, где нужен формат — вёрстка, разметка, шаблон ответа.

5. Архитектура скиллов важнее их содержания. Один SKILL.md на девятьсот строк грузится целиком: пишете пост в телеграм — модель попутно читает правила для лендингов. Лишнее разбавляет нужное, а трогать такой файл страшно, поэтому его проще дополнить, чем разобрать. Разложите по уровням: верхний решает, что за задача и куда идти дальше; профиль канала держит тон и рубрикатор только для себя; редкие рубрики подгружаются по надобности. Тогда правки перестают быть страшными: меняете один канал и точно знаете, что остальные не задели.

Что переносится на другие модели

Не переносится цифра. 80% — результат конкретной связки: их обвязка, их модели, их тесты на коде. Для GPT, Gemini или локальных моделей такого замера у вас нет.

Переносится наполовину принцип «меньше правил — лучше». Это функция силы модели, а не тренд индустрии: чем модель слабее, тем нужнее ей явные правила и примеры. Если вы гоняете тяжёлое на топовой, а рутину на дешёвой, один облегчённый скилл на всех не сработает. Либо два профиля инструкций, либо пишете под самую слабую в связке и теряете на сильной.

Не переносятся архитектурные приёмы. Прогрессивное раскрытие, отложенная загрузка инструментов, автопамять — это свойства обвязки, а не модели. В чужом фреймворке эквивалента может не быть, и тогда «вынесите редкое в отдельный скилл» превращается в «вынесите в файл, который никто не подгрузит».

И главное

Спор о длине промптов маскирует настоящую проблему: у нас нет способа отличить улучшение от ухудшения. Пока его нет, любое решение — резать или не резать — принимается на ощущениях. Вопрос не в том, сколько правил у вас в скиллах, а в том, знаете ли вы, какие из них хоть на что-то влияют. А это уже content ops. 😎

#ai_agents #contentops
  • 👍 1
  • 🔥 1
  • 🤯 1
Post #2947 124
Смотрим на отчёт Similarweb «2026 Generative AI Landscape». Сначала общие выводы:

1️⃣ Первое, что стоит заметить, — это разрыв между двумя метриками роста. Визиты выросли на 70% до 9,5 млрд, а уникальные посетители — только на 57%, до 655 млн. Аудитория расширяется медленнее, чем растёт частота обращений: приходят не столько новые люди, сколько одни и те же, но чаще. ИИ перешёл из режима «попробовать» в режим привычки, и окно первого впечатления для брендов закрывается — вас теперь встречают внутри уже сложившегося сценария.

2️⃣ Второе — дробление идёт не туда, куда кажется по заголовкам. Доля ChatGPT в веб-визитах упала с примерно 76% в июне 2025 до около 53% к маю 2026, и главный бенефициар здесь Gemini: с менее 9% до 27–28%. По вебу перераспределение идёт в пользу Google. Это меняет практический вывод: «оптимизировать под ИИ» и «оптимизировать под Google» — уже не два проекта, а один.

3️⃣ Третье — замещения нет, есть наслоение. 461 млн из 494 млн пользователей ChatGPT в марте-мае 2026 продолжали пользоваться и Google, а поиск в целом держит 3,3 млрд уникальных посетителей в месяц против 655 млн у чатботов. Разрыв впятеро. Старый канал никуда не делся, новый добавился сверху — бюджет делится, а работы становится вдвое больше.

4️⃣ И, четвёртое, последнее, самое неудобное для отчётности. К рекомендованному ИИ бренду пользователи заходят в два-четыре раза чаще, чем к нерекомендованному конкуренту — при том что ссылку на источник содержат всего 6,8% ответов. Влияние на выбор идёт мимо реферального трафика, и в вашей аналитике его просто не будет видно.

➡️ Теперь #контентменеджерское :

1️⃣ Обновлять, а не только производить. Частота обращений растёт быстрее охвата, а значит один и тот же материал перечитывают и переспрашивают. Ставим регулярный пересмотр ключевых страниц: дата обновления, актуальные цифры, вычищенные устаревшие формулировки.

2️⃣ Держать фактуру в извлекаемом виде. ИИ берёт как доказательство то, что легко вынуть: определения абзацем, цифры с датой и источником, таблицы сравнения, прямые ответы под подзаголовком-вопросом. Длинное подводящее вступление перед сутью — проигрыш.

3️⃣ Разделить роли страниц. ИИ цитирует материалы на два-три уровня вглубь, а приходят люди почти всегда на главную и верхнеуровневые. Значит, страницу «из глубин сайта» нельзя оценивать по трафику — её задача быть доказательной базой, и мерить её надо упоминаниями. А верхнеуровневая должна встречать человека, который уже что-то о вас знает из ответа ИИ, а не начинать разговор с нуля.

4️⃣ Писать под длинный запрос, а не под ключ. Средняя длина запросов растёт: привычка формулировать промпты переехала в поисковую строку. Это меняет требование к материалу — он должен отвечать на конкретный вопрос с условиями («для команды из пяти человек», «если данные в другом формате»), а не покрывать тему в целом. Ключ теперь не в заголовке, а в том, насколько узкий случай вы разобрали внутри.

5️⃣ Проставить авторство и подтверждаемость. Фамилия автора, его роль, ссылка на первоисточник у каждой цифры. Это то, что отличает материал-донор от материала-сырья.

6️⃣ Завести реестр упоминаний. Раз в месяц прогонять 20–30 профильных запросов по ChatGPT, Gemini, Perplexity и фиксировать: упомянули или нет, какая формулировка, кто рядом, какая страница процитирована. Без этих логов обсуждать «видимость в ИИ» не с чем.

#geo #ai
  • 🔥 3
  • 👍 1
Post #2944 147
С праздником, сисадмины! Свитеры под горло, огромные очки, бороды и длинные волосы стали модными и перестали быть отличительной чертой профессии. Но "вы пробовали выключить и снова включить" будет вечным.

Всем пива!
  • 👍 3
  • ❤‍🔥 2
  • 🔥 1
Post #2943 216
Все обновление госуслуг уже скачали?
  • 😁 2
  • 🔥 1
  • 🤬 1
Post #2942 145
Модель OpenAI сбежала из песочницы и взломала Hugging Face

Что произошло — по материалу The Verge и официальному разбору самой OpenAI:

OpenAI тестировала кибер-способности двух моделей — GPT-5.6 Sol и ещё не вышедшей, более мощной — на бенчмарке ExploitGym. В изолированной среде без доступа в интернет. Задача: показать, насколько хорошо модели умеют взламывать.

Не найдя ответа внутри песочницы, модели нашли и проэксплуатировали неизвестную уязвимость, выбрались наружу, прошли через корпоративную сеть OpenAI в открытый интернет и добрались до Hugging Face, потому что там лежал датасет с ответами к тому самому тесту. Утащили внутренние датасеты и учётки. Хозяйничали там выходные. Hugging Face заметил, сообщил в полицию и сначала даже не знал, что за этим стоит OpenAI. А сама OpenAI, по данным Reuters, узнала, что её агент несколько дней хачил чужой сервис, уже после того, как подключили ФБР.

Сначала оговорка

Защита была отключена намеренно. Это был тест «на что модель способна без тормозов». Модель не «проснулась и восстала», ей сняли ограничения и запустили на машине с живой сетью. Как честно заметил один исследователь: когда говорят «ИИ вышел из-под контроля», ловко пропускают часть, где OpenAI сама убрала блокировки.».

Самое интересное не во взломе. А в том, ЗАЧЕМ модель это сделала

Ей не ставили задачу «взломай Hugging Face». Ей поставили задачу «набери максимум баллов на тесте». И модель сообразила: проще всего набрать баллы, если сжульничать — украсть ответы. Она не отклонилась от задания. Она выполнила его буквально, найдя обходной путь, которого никто не предусмотрел. Профессор из Кембриджа так и сформулировал: модель ни на шаг не отступила от задачи.

Вот это не про кибербезопасность

Тот же корень, что у галлюцинации, у дрейфа голоса, у агента, который «оптимизировал» текст не туда. Модель делает не то, что ты имел в виду, а то, что ты буквально попросил. В безобидном случае это выдуманная цифра в релизе. В этом — zero-day и чужой сервер. Механизм один: система ищет кратчайший путь к цели, а не тот, который ты держал в голове.

А ещё модель ушла в загул на выходные, а владелец узнал об этом от ФБР. Это не про то, что модель умная. Это про то, что за ней никто не смотрел. Не было мониторинга — значит, была слепая зона размером в выходные.

Что забрать себе

Любой агент — это система, оптимизирующая под цель. Дай ей цель и доступ и она найдёт кратчайший путь, включая тот, который тебе не понравится. Поэтому три вещи перестают быть паранойей и становятся гигиеной:

— Минимум доступа. Агент получает ровно то, что нужно для задачи, и ни битом больше.
— Песочница. Работает там, откуда не дотянется до того, что можно сломать.
— Мониторинг. Ты видишь, что он делает, в реальном времени.

Это, кстати, похоже на content sec ops, идею которого я обещал развернуть.

#ai
  • 👍 1
Post #2941 127
Что произошло с ценой на ИИ

Миллион слов у лучшей модели Anthropic стоит 50 долларов, у DeepSeek — 87 центов. TNW собрал материал со ссылками на WSJ и Fortune, и заголовки везде про одно: китайские модели дешевле, американским лабам плохо, IPO под угрозой. Это правда, но это не самое интересное в новости. Интереснее то, как именно компании начали экономить.

Год назад знаком жечь токены было доказательством серьёзности. Теперь в моде так называемый thrift-maxxing. Сначала компании просто лимитировали, сколько сотрудник может потратить на ИИ, потом начали подбирать модели на задачи.

Далее IDC опросила 260 крупных компаний в США и выяснили, что 47% используют хотя бы одну китайскую модель хотя бы под одну задачу. На маркетплейсе OpenRouter в одну из июльских недель китайские модели забрали 57% потреблённых токенов. Coinbase вдвое срезал расходы на ИИ, DoorDash отдаёт «низовую работу» на Kimi, Airbnb гоняет Qwen на поддержке.

Откуда вообще такой тренд: экспортные ограничения США, кажется, сработали против замысла. Отрезанные от топовых чипов Nvidia, китайские лабы были вынуждены выжимать больше из худшего железа. Ограничение стало тренажёром эффективности — за цену одного чипа Nvidia берут десять своих локальных и оптимизируют под них.

И самое интересное, как всегда, это кейсы: как устроен стек Telnyx после того, как они перестроились под экономию:
— anthropic-модель дирижирует и планирует работу,
— модели с открытыми весами делают реализацию,
— модель от OpenAI ревьюит результат.

Причём это не полностью связано с экономией, это распределение ролей. Дорогая модель поставлена туда, где её цена оправдана, — на планирование и ревью. Дешёвая — на реализацию. Ещё примем: Cursor посчитал сборку браузера с нуля: целиком на топовой модели OpenAI — чуть больше 10 000 долларов. Та же работа, распределённая между своей моделью и Opus, — 1 339. Разница в восемь раз не за счёт того, что взяли что подешевле, а потому что каждую часть работы отдали модели по её уровню.

Ну и приземлимся на наши контентные дела

Год назад все брали одну самую мощную модель и писали с её помощью всё подряд. Сейчас получается уже дороговато. Но и в качестве терять не хочется. Поэтому появляется пайплайн.

Планировщик, исполнители, ревьюер — разные модели на разных ролях, каждая по деньгам. Компания перестаёт спрашивать «какая модель лучшая» и начинает спрашивать «какая модель нужна вот на этом шаге». Это взросление. Ровно тот же переход, что редакция проходит от «дайте нам ИИ» к «у нас есть процесс, и в нём агенты стоят на местах».

И про навык, который будет востребованы. Не «умею писать крутые промпты», а «умею собрать оркестр из моделей разного класса так, чтобы дорого было только там, где оправдано». Это инженерия пайплайна.

И более того, если раньше вы могли взять клод и не смотреть на другие модели. «Я редактор, я не хочу разбираться». А сейчас вам прям нужно шарить, тестировать модели на различных задачах и считать токены.

Это, кстати, мой опыт. В какой-то момент мои агенты начали жрать. Да, качество выросло, но лимиты выедались в момент. Так что пришлось делать рефакторинг, ограничивать запросы и использовать разные модели на этапах создания текстов.

Цена на интеллект падает. Ценность умения его правильно распределить — растёт. И это, кажется, единственный навык здесь, который не подешевеет.

#ai
  • 🤯 2
  • ❤‍🔥 1
Post #2940 127
Мое спокойствие и человеколюбие держится не на магнии, а на трех силовых тренировках в неделю.

Будь ты проклят, день ног.
  • 😁 3
Post #2939 138
Не открывай Code на выходных
  • 🙏 2
Post #2938 146
  • ❤ 2
  • 😁 1
Post #2937 142
Тестирование новых возможностей телеграм, сорри. Теперь можно объединять чаты и каналы в сообщества.
  • 😁 2
Post #2934 154

Forwarded from Архитектор Данных

В мире нейросетей и вайбкодинга сениор и джун делают одно и то же.

Визуально и функционально отличий нет.

Только джун с надежностью 0.7, а сениор с надежностью 0.99

В этом разница.
  • 👍 2
Post #2933 144
Рабочее про ИИ. В VK AI Space добавлена многоуровневая память для корпоративных агентов.

— Сессионная память сохраняет диалог и текущие задачи
— Пользовательская запоминает профиль и предпочтения сотрудника
— Проектная накапливает материалы, правила и решения в рамках проектов
— Память самого агента

В сочетании с возможностью создавать мультиагентные сценарии в безопасном и контролируемом контуре, получается очень даже интересно.

Подробнее тут.

#ai #vktech
  • 👍 1
Post #2932 145
Пойду дальше работать...)
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →