
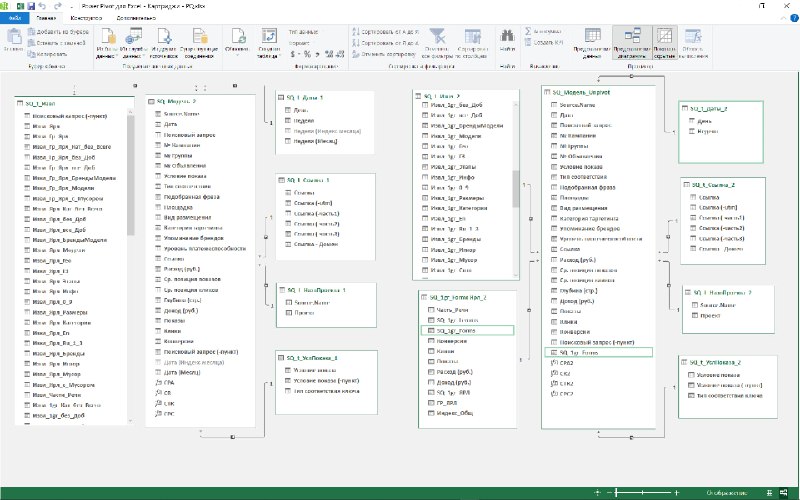


✅ Неделя 2: пайплайн из 650 функций.
🔸 Объёмы обработки тестовых данных:
— 4 аккаунта.
— 1,07 ГБ данных.
— 1,05 млн строк статистики с разбивкой по всем атрибутам и датам.
— 208 000 уникальных поисковых запросов.
— 45 500 униграмм (уникальных форм слов).
— 42 000 лемм униграмм (начальных словарных форм слов).
🔸 Объём кода:
— 2 055 строк.
— 116 000 символов.
— 39 листов А4.
🔸 Разнообразие операций:
— Всего — 782 функции в пайплайне.
— Уникальных — 52 функции (в Power Query их всего 800), из них:
• 22 — функции таблиц.
• 14 — текстовые функции.
• 10 — функции списков.
• 6 — другие (см. скриншоты 3–6).
🔸 Автоизвлечение и автозамена лемм униграмм на их смысловые ярлыки:
— 50 универсальных правил.
— 97 универсальных регулярных выражений для извлечения и замены размеров.
— 7,2×10^24 (число с 24 нулями) комбинаций паттернов, которые учитывают регулярки.
— 12 000 лемм униграмм в собственной библиотеке смысловых ярлыков, собранных из 8 проектов. Позже добавлю десятки тысяч слов с ярлыками ещё из ~30 проектов.
🔸 Результаты:
— Более 200 смысловых ярлыков, размеченных в 1 клик.
— Из 42 000 лемм униграмм автоматически размечено смысловыми ярлыками 37 000, т.е. 88%.
— В сегменте из оставшихся 5000 неразмеченных слов:
• 3000 слов сгруппированы по частям речи для удобства и ускорения последующей разметки.
• 98,2% кликов содержатся в первых 220 словах с 2 кликами и более (4,4% списка оставшихся слов).
• 100% кликов содержатся в 500 словах с 1 кликом и более (10% оставшихся слов).
• Остальные 4500 слов (90% оставшихся) — с показами без кликов.
Вся суть комбайна в том, чтобы вручную прометить только целевые слова из оставшихся 220–500 неразмеченных слов и перепроверить все остальные, уже размеченные моими правилами, регулярками и библиотеками.
В т.ч. вашими библиотеками, естественно. Их бесшовную интеграцию в код я тоже добавлю. Как их составлять для бесшовной интеграции и кастомизации комбайна под любой проект — объясню позже.
Все предыдущие и все последующие этапы, сколько бы я их дальше ни добавил, делает код.
— Идентичная автогруппировка семантики:
• В частотном словаре слов, аналогов которому на рынке не существует даже близко.
• В таблице группировки фраз.
• Обе таблицы имеют сотню идентичных срезов, группировок, сортировок и интерактивных фильтров: как кастомных автовычисляемых, так и стандартных из рекламных кабинетов.
🔸 Автогруппировка и автофильтрация статистики по униграммам и фразам:
— Категорийным размеченным.
— Категорийным неразмеченным.
— Модельно-вендорным.
— Номенклатурным.
— Топонимам (геодобавкам).
— Горячим добавкам.
— Ранним этапам спроса.
— Инфодобавкам.
— Различным паттернам латиницы.
— Различным паттернам кириллицы.
— Различным паттернам цифр.
— Размерам с любыми единицами измерения.
— Комбинациям двух-трёх габаритов с любыми единицами измерения.
— Самостоятельным частям речи.
— Стоп-словам (служебным частям речи).
🔸 Время отработки:
— 185 столбцов создаются и пересчитываются автоматически.
— 45 минут — отработка всего пайплайна из 780 функций.
— 8 из 45 минут — автопересчёт сотни кастомных столбцов, автоприоритизация и перегруппировка семантики, изменив лишь исходные условия.
— 1 час — извлечение 7,2×10^24 паттернов размеров и их замена на смысловые ярлыки 97 большими сложными регулярками на массиве в 45 500 униграмм.
Сперва может показаться, что это всё долго, но потом вспоминаешь, что за это время выполняется двух-трёх недельный объём работы, когда ты сам в это время не делаешь вообще ничего. И выдыхаешь.
Хочется немножечко плакать от того, что теперь больше никогда не придется страдать с этим рабским трудом.
Каждый раз.
Каждую неделю.
На каждом проекте.
Это всё ещё не весь функционал, который я запланировал, а лишь очередной апдейт, но текущая версия уже превосходит среднестатистического мидла.
Мой прогноз: джуны отныне будут просто не нужны.
⬇️ Продолжение.
✅ Неделя 4: 2900 строк кода, гибкость и универсальность 90 LVL.
via @ppc_bigbrain