TGViewer
Channel Public Channel
P(hD)ython

P(hD)ython

@phdython

О Python, PhD, распределённых системах и не только

Автор - Михаил Масягин (@masyagin1998):

⚡️ Python Lead в HFT (NDA);
⚡️ преподаватель в Бауманке;
⚡️ эксперт по СУБД System Design World;
⚡️ любитель PhD и авторегрессии.
Subscribers
332
Photos
51
Videos
0
Links
34
Recent Posts 20 shown
Post #82 364
«Конференции и паровозики 🚂»

#заметки_с_полей

Отгремела «Профсоюзная 2.0» - конфа прошла на высшем уровне 💯

Отдельный респект организаторам: несколько залов, плотная программа, дебаты, Lightning Talks, интерактивы, нетворкинг и афтепати. Расписание иногда немного уезжало, но при такой плотности программы это простительно 😄 Видно, сколько сил команда в это вложила.

Из докладов особенно зашли:

⚡️ Владимир Балун - про то, почему айтишники постоянно заняты, но всё равно ничего не успевают, и как собрать техники продуктивности в реально работающую систему;
⚡️ Влад Соколовский - про профессию AI Engineer, реальный production-опыт и переход в эту область.

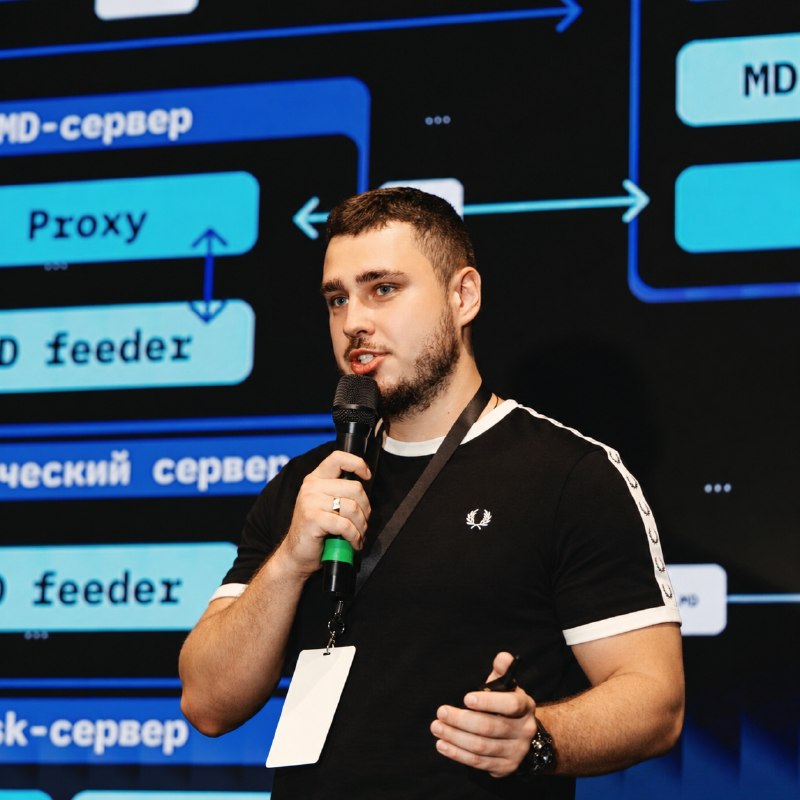
Сам я выступил с докладом «HFT: low latency, алгоритмы и деньги» - рассказал про инфраструктуру HFT-компаний и переход из обычной backend-разработки в low-latency-разработку. После доклада меня ещё около двух часов ловили по всей площадке с вопросами про HFT. Для меня это, пожалуй, лучший фидбэк 😄

Но одним докладом дело не ограничилось:

⚡️ дважды участвовал в дебатах и оба раза победил: win rate 100%, пусть и выборка маловата;
⚡️ на Lightning Talks шёл рассказывать про аспирантуру, но в итоге получилось продолжение HFT-доклада - уже с точки зрения ресерча.

А на афтепати - лютый слэм 🤘 и... go-go 🕺

Спасибо организаторам, спикерам и всем, с кем удалось познакомиться и пообщаться. Было мощно 💪

С уважением,
Михаил Масягин

P.S. А ещё на конференции внезапно узнал, что через мою алгосекцию когда-то «паровозиком» прошли несколько кандидатов 🚂. Один собрал мои задачи и передал следующим. Честно говоря, даже респект за находчивость 😅

P.P.S. Империя готовит ответный удар ☠️
  • 🔥 22
  • 💯 7
  • ❤ 4
  • ⚡ 2
  • 😁 1
  • 🥴 1
Post #81 418

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 15
  • 👍 11
  • ❤ 8
  • 😁 1
  • 🥴 1
Post #80 501
«Профсоюз выдвинул 😎»

#заметки_с_полей

22 августа в Москве буду спикером на «Профсоюзной 2.0» 🚀!

Доклад: «HFT: low latency, алгоритмы и деньги».

Подробно разберу:

⚡️ из чего состоит инфраструктура HFT-компаний;
⚡️ как данные проходят путь от биржи до торгового алгоритма;
⚡️ зачем бороться за микро- и наносекунды;
⚡️ какие технологии используются в low-latency-разработке;
⚡️ чем классические биржи отличаются от криптобирж;
⚡️ какие инженеры нужны в HFT и как туда попасть.


А ещё разыграю приз за лучший вопрос из зала 🏆.

Буду краток: билеты ещё можно взять, а выступаю я в зале URBAN с 16:00 до 17:00 🎙.

С уважением,
Михаил Масягин

P.S. Также меня можно будет встретить на Lightning Talks, дебатах и армрестлинге 💪.
  • 🔥 20
  • 👍 6
  • 👏 5
  • ❤ 2
Post #79 526
«Ну вот, я и стал админом 🧑‍💻»

#техно_и_хардкор

Собрал, казалось бы, банальный, но для многих неочевидный сетап: связал ноутбук и стационарный ПК по двум отдельным сетевым каналам:

⚡️ control plane - условный контур управления по Wi-Fi. Агент работает на ноутбуке и подключается к ПК по SSH: запускает нужные процессы и управляет экспериментом, может даже подтюнить настройки ОС и ребутнуть ПК;
⚡️ data plane - тестовый трафик по отдельному прямому 2.5GbE-линку: обычный патч-корд RJ45-RJ45 Cat 6A, без роутера и коммутатора. Дёшево и сердито.


Так управляющий трафик не смешивается с тестовым: даже если эксперимент переконфигурирует, забьёт или вообще положит проводной линк, канал управления по Wi-Fi останется жив. Получился маленький стенд с вполне себе production-логикой, пусть и вместо серверной стойки - ламинат, а вместо грамотного кабель-менеджмента - стяжки и принятие хаоса 👹.

В роли узлов:

⚡️ ноутбук MSI GP66 Leopard 11UG - i7-11800H, 64 GiB DDR4-3200 и Realtek RTL8125 2.5GbE;
⚡️ ПК на MSI PRO Z790-A MAX WIFI - i7-14700KF, 64 GiB DDR5-6000 и Intel I226-V 2.5GbE.


Нетрудно догадаться, что сетевухи в этой конфигурации важнее всего.

Оба Ethernet-контроллера уже были на платах, поэтому вся новая «инфраструктура» обошлась мне в 300 рублей за кабель с Avito.

В идеале, конечно, мне нужно в 10 раз больше - 25GbE, но покупать ещё две сетевухи и всю обвязку душит жаба. Так что пока 2.5GbE. Бюджетный low latency - он такой 😅.

С уважением,
Михаил Масягин

P.S. Что именно я на этом всём тестирую - пока оставлю небольшой загадкой. Можете погадать в комментариях 👀
  • 🔥 8
  • ⚡ 3
  • 👍 2
  • ❤ 1
  • 🤔 1
Post #78 496
«Предзащита: больно и неофициально 🎓»

#аспирантские_будни

Наконец дошли руки до обещанного поста о неофициальной предзащите моей кандидатской. Да-да, именно неофициальной!

О том, что предзащита состоится 16 июня, я узнал 12-го. За четыре дня собрал презентацию, подготовил речь, достал пылившийся в шкафу костюм и вышел к доске... где комиссия разнесла меня в пух и прах! Получился стресс-тест не только диссертации, но и самого аспиранта 😅.

Интересный нюанс: до лета 2025 года практический пайплайн в нашем диссовете выглядел просто: неформальная предзащита и непосредственная защита под запись. Поэтому именно на первой можно было задавать неудобные вопросы, разбирать слабые места и корректировать содержание «кирпича».

Но 2 июля 2025 года Минобрнауки разъяснило: аудиовидеозаписи могут запросить с заседаний диссовета как при защите, так и при предварительном рассмотрении диссертации. Теперь официальный промежуточный этап тоже записывают, хранят и по запросу передают в министерство 🫡.

Однако разносить человека под запись как-то не «по понятиям». Так у нас появился новый этап - неофициальная предзащита, предшествующая официальной, уже «камерной».

Главная претензия оказалась не к доказательствам и даже не к научной новизне, а к... шифру специальности!

Моя работа заявлена по специальности 1.2.2 - «Математическое моделирование, численные методы и комплексы программ». В её паспорте есть малозаметное примечание: диссертация должна содержать все три составляющие названия специальности.

✅ С математическим моделированием всё отлично: я исследую временные ряды и описываю их EXPAR-моделями.
✅ С программным комплексом тоже: я его разработал и зарегистрировал, вот пост про получение патента.
❌ А самостоятельный численный метод комиссия в работе не обнаружила.


Основной результат диссертации
- метод выбора оптимальной функции потерь для EXPAR-моделей с учётом распределения обновляющего процесса. Проще говоря, по природе шума можно определить, чем лучше оценивать параметры модели.

На мой взгляд, «численного» в работе хватает, однако комиссия решила, что по духу результат ближе к теории вероятностей и математической статистике (ТВиМС). Ирония заключается в том, что все мои статьи уже опубликованы по 1.2.2 😅.

Вместе с научником и секретарём диссовета нашли комплексное решение проблемы:

⚡️ Добавить специальность 2.3.1 - «Системный анализ, управление и обработка информации, статистика». Системного анализа и управления у меня нет, зато обработка информации и статистика - пожалуйста. Требования собрать все компоненты названия специальности, как в 1.2.2, здесь нет.
⚡️ Для 1.2.2 выделить и формализовать собственный численный метод. Мы уже умеем выбирать функцию потерь. По её свойствам можно подобрать подходящий метод оптимизации, а затем, применив гомотопический метод, малыми деформациями прийти к оценкам параметров, снижая риск застрять в локальном минимуме. Чем не новый численный метод? 😄


Осталось внести правки в диссертацию и дойти до второй, уже официальной предзащиты. Надеюсь, там всё пройдёт гладко, а уж на защите - тем более))

С уважением,
Михаил Масягин

P.S. Специальность для диссертации выбирайте аккуратно и обязательно сами читайте её паспорт, включая примечания, звёздочки и мелкий шрифт. Даже научник может с этим ошибиться.

P.P.S. В комментариях приложу паспорта специальностей 1.2.2 и 2.3.1.
  • 🤓 10
  • ❤ 7
  • 🔥 6
Post #77 573
«Work-life balance от Anthropic ⚒️»

#ai4sdlc

Недельные лимиты токенов израсходованы - можно с чистой совестью выключать компьютер и отдыхать на выходных 🏖.
Но как всегда есть небольшой нюанс: Anthropic уже сбросили все лимиты в четверг утром.
Да-да, недельный запас токенов плана Team Premium вполне реально сжечь за два дня, когда работа идёт 24/7 🔥.

При этом кажется, что в Anthropic всё острее ощущают:

геометрический рост потребления токенов не гарантирует многомиллиардных прибылей 🤑


С одной стороны их подпирает OpenAI, чей Codex по подписке оказывается экономически выгоднее Claude Code, с другой - открытые модели вроде KIMI K3, у которых число параметров уже измеряется триллионами.

Поэтому сегодня Anthropic объявили, что с 20 июля Fable 5 останется в тарифах Max и Team Premium - пусть и с лимитами, урезанными на 50%.
Конкуренция - великая вещь. Ещё недавно всех пугали, что вот-вот и Fable 5 останется доступен только на потокенной оплате. Ан нет 😄!
Думаю, и «неожиданные» обнуления лимитов по четвергам мы тоже увидим ещё не раз.

С уважением,
Михаил Масягин
  • 🔥 12
  • 👍 5
  • ❤ 4
  • 🤔 1
Post #76 734
«ast-index - работает ⁉️»

#ai4sdlc

На Saint HighLoad++ 2026 ast-index упоминал почти каждый второй докладчик, говоривший об ускорении агентов и экономии токенов.

Идея AST-индекса проста и гениальна:

чтобы избежать медленных и затратных по токенам grep'ов, строится и инкрементально обновляется локальный индекс на базе Tree-sitter и SQLite. При этом индексация происходит не по сырому тексту файлов, а по структуре проекта - названиям классов и методов, именам переменных и констант, import'ам и зависимостям. Таким образом, становится возможен быстрый и дешёвый структурный поиск.

Я тоже поставил AST-индекс в Claude и... столкнулся с пренеприятным сюрпризом. Почти в каждом чате происходило одно и то же:

1️⃣ Claude 1-2 раза честно вызывал ast-index
2️⃣ а затем словно забывал о нём
3️⃣ и возвращался к привычному grep


Лично я проверял на v3.49.1 - на момент написания поста это последний релиз.
Проблема была не только у меня - с ней столкнулись и несколько моих знакомых.

Решив разобраться, что же тут не так, полез в .claude/rules/ast-index.md - правило, генерируемое на этапе инициализации AST-индекса (командой /initialize), и нашёл причину:

Use grep/Search ONLY when:
- ast-index returns empty results
- searching for regex patterns
- searching for string literals inside code
- searching in comments content


Проблема - в третьем пункте 😈!

Для LLM почти любой поиск можно объяснить как «поиск строки»: имя константы, функции, import'а или места регистрации зависимости - формально всё это текст.
В итоге Claude «строго» соблюдает правило: пару раз использует ast-index, а затем объявляет очередной запрос «поиском string literal» и возвращается к grep.

Это особенно забавно на фоне рассинхронизации внутри самого репозитория.

В глобальном SKILL.md исключение широкое - string literals inside code.

А в расширенном примере rule-файла уже написано корректнее - string-literal patterns that are not symbol names.

Одна оговорка сильно меняет поведение агента.

Например, поиск значения константы API_V2_STR - вовсе не повод грепать API_V2_STR.

Её определение уже есть в AST-индексе и спокойно ищется через:

ast-index symbol API_V2_STR

А место подключения условного router'а находится через:

ast-index usages router

То есть Claude должен задавать себе не вопрос «это строка?», а вопрос «умеет ли индекс хранить эту сущность?».

Я поправил rule-файл в три этапа:

⚡️ Перед любым grep агент обязан назвать конкретное исключение. Не смог - используй AST-индекс. Никакого silent fallback
⚡️ grep разрешён только для регулярок, комментариев, пустого результата после `ast-index update` и свободных строковых значений, которых в индексе действительно нет
⚡️ Добавил явную карту намерений:

🙂 «как работает X?» → `explore X`
🙂 «где определён X?» → `symbol X`
🙂 «где X используется/подключён?» → `usages X`
🙂 «что находится в файле?» → `outline file.py`


После этого Claude начал использовать всю мощь AST-индекса по полной, и число вызовов grep заметно снизилось.

Важно: патч применяется к локальному .claude/rules/ast-index.md проекта, поэтому при подключении AST-индекса в новые проекты процедуру придётся повторить.

В комментариях прикрепил 3 файла:

⚡️ ast-index-vanilla.md - исходное правило, генерируемое при инициализации индекса
⚡️ ast-index.patch - патч исходного правила, исправляющий случайный переход на grep
⚡️ ast-index-patched.md - пропатченное правило


С уважением,
Михаил Масягин

P.S. Даже к хайповым инструментам следует применять старое доброе правило - «доверяем, но проверяем». С caveman тоже все носятся, хотя его эффективность сомнительна... крайне сомнительна...

P.P.S. Почаще нажимайте ctrl + o и читайте рассуждения модели и то, какие инструменты она использует 🤝
  • ⚡ 9
  • 👍 6
  • 🔥 5
  • ❤ 1
Post #75 424
P(hD)ython «Мама, я в телевизоре 😎» #заметки_с_полей Ну, может и не в телевизоре, но с первым опытом студийной записи меня 😅 С уважением, Михаил Масягин
«Мама, я в телевизоре x2 😎»

#заметки_с_полей

Попал на камеры Saint HighLoad++ 2026, когда с умным видом обсуждал с докладчиком AI-трансформацию IT-компаний 😅

С уважением,
Михаил Масягин
  • ❤ 11
  • 👍 7
  • 👏 5
  • 💯 1
Post #74 562
«AI съел HighLoad 🤖»

#ai4sdlc

Вернулся с Saint HighLoad++ 2026 в СПб.

Конфа была крутой и, что ожидаемо, почти полностью про AI: по ощущениям, процентов 70 докладов так или иначе крутились вокруг LLM, агентов, AI4SDLC, контекста, токенов и eval'ов.

Но среди всех выступлений хотелось бы выделить несколько ключевых.

Самое запоминающееся для меня - доклад Ивана Поддубного, CTO Вебпрактик, про уровни зрелости внедрения AI в разработку.
По мнению спикера есть 5 уровней этого процесса:

🍼 L0 - пишем код без AI
❔ L1 - спрашиваем GPT и копипастим код (ChatGPT)
💻 L2 - используем агентов локально (Claude Code, Codex)
🏎 L3 - человек ставит задачи агентам и валидирует их
🏭 L4 - dark factory: роботы полностью автономны


⚡️ Про L0 и L1 в 2026 году уже и говорить неловко
⚡️ На L2 так или иначе перешли 70% разработчиков
⚡️ L4
пока выглядит скорее как цель
⚡️ А вот в рамках L3 идёт настоящая гонка...


L3 - это не «запустил Cursor/Claude Code в цикле до зелёных тестов», а жёсткий и стандартизованный процесс:

SDD → ADR → TDD

⚡️ SDD - Spec Driven Development. Мы пишем настолько формальную постановку задачи, что спецификация становится новым кодом
⚡️ ADR - Architecture Decision Record. Не просто план агента, а стандартизированное описание вариантов, trade-off'ов, рисков и выбранного решения
⚡️ TDD - Test Driven Development. Сначала тесты, а только потом код. Методология 50-летней давности, но теперь её придерживается не человек, а нейросеть

Чуть в сторонке от этого пайплайна стоят агентские Evals и Observability

⚡️ Evals - тесты не только самого кода, но и агента, порождающего код. Например, «напиши pupa-service с p99 ≤ 100ms». Справился? - супер, нет? - срочно на доработку промптов и обвязок!
⚡️ Observability - отдельный агент-методолог смотрит на спеки, ADR, код, тесты и даже reasoning основного агента, пытаясь сделать выполнение задач оптимальным.


По сути мы повторяем технологическую революцию начала XX века: строим конвейер, а за каждым рабочим ставим своего Фредерика Тэйлора - основоположника научной организации труда (кстати прочитайте биографию - крутой дядька).
Только теперь вместо рабочих - агенты, а вместо конвейера - наш пайплайн на условном Python.

Кстати за лучший вопрос докладчику мне вручили книгу Таненбаума по ОСям. Приятно, что база ещё кому-то нужна 😄

Ещё очень зашли доклады Андрея Неведина, Алексея Гладкова и Александра Иванова про сжатие контекста, harness'ы и базы знаний агентов.

TL;DR у всех примерно один:

⚡️ токены дорогие, контекст маленький, agentic grep малоэффективен, а MD-базы знаний быстро превращаются в свалку
⚡️ поэтому все строят умные индексы проектов, графовые/граф-раговые базы знаний и пытаются как угодно минимизировать число потребляемых & выдаваемых моделью токенов


Отдельно отмечу воркшоп Кирилла Мокевнина «Как сделать проект понятным для AI-агентов».
Главная мысль свежая: надо делать проект под агента, а не агента под проект.

Например, вместо models/, tables/, routers/ в Django-проекте - раскладывать код по фичам: billing/, auth/, notifications/, а внутри каждой держать свои model.py, router.py, schema.py.

Для человека разница небольшая, а для агента - огромная: меньше прыжков по проекту, меньше контекста, меньше токенов.

Saint HighLoad++ получился очень показательным.
Вопрос уже не в том, используете ли Вы AI в разработке или нет.
Вопрос в том, насколько эффективно Вы его используете.

С уважением,
Михаил Масягин
  • 👍 16
  • 🔥 10
  • ⚡ 5
Post #72 455
«Навигация по P(hD)ython 🧭»

Канал уже заметно разросся, поэтому собрал небольшой рубрикатор, чтобы было проще искать посты по темам. Всё для Вас 😅

🐍 #python - всё о Python: релизы, фичи, тонкости и нюансы

🏗 #system_design - Клеппманн, транзакции, CQRS, DWH, СУБД и прочие распределённые радости

⚙️ #техно_и_хардкор - C, Linux, параллельное программирование, оптимизации, HFT, FPGA, Low Latency и всё то, где идёт борьба за микросекунды

🤖 #ai4sdlc - AI в разработке: агенты, AI-Native IDE, автоматизация кодинга, LLM и всё то, что ведёт нас в светлое (или не очень) будущее

🧭 #карьера_и_собесы - рынок IT, интервью, найм, кандидаты, red flags, офферы и способы не утонуть, когда рынок штормит

🎓 #аспирантские_будни - диссертация, статьи, ВАК, патенты, Бауманка и путь к степени кандидата физ-мат наук

🎤 #заметки_с_полей - конференции, доклады, поездки, встречи и живые репортажи с места событий

🧑‍💻 #жизнь_айтишника - мемы, розыгрыши, отпуск, Work-Job Balance и прочее околокодовое


Пост буду периодически обновлять.
Если потеряли какой-то материал - пишите в комментариях, попробую достать его из недр канала 🫡

С уважением,
Михаил Масягин
  • 👍 8
  • ✍ 4
  • 🙏 2
Post #71 331
«Легенды System Design 😎😂»

#заметки_с_полей

С уважением,
Михаил Масягин

P.S. Завтра твёрдо и чётко напишу пост с TL;DR по Saint HighLoad++ 2026 👍
  • 🔥 11
  • ❤ 10
  • ⚡ 6
Post #70 384
«Прорекламирую Вашу компанию, дорого 💵»

#заметки_с_полей

С уважением,
Михаил Масягин
  • 🔥 12
  • 😁 5
  • 🥰 3
  • ⚡ 1
Post #68 457
«Питер, HighLoad++ и предзащита 🎓»

#заметки_с_полей

22–23 июня еду на Saint HighLoad++ 2026 в СПб!

Причём в этот раз в качестве участника: буду помогать @vova_dev из System Design World проводить аналог «Своей игры» по System Design 💪.

Да-да, с вопросами за 300, котом в мешке и необходимостью иметь эрудицию как у Вассермана 😅

Питерские подписчики, знаю, Вы тут точно есть!
Буду рад пересечься, пообщаться и выпить чаю, а может, и чего покрепче 🍷.

Вообще июнь оказался крайне богат на события:

⚡️ съездил во Владимир и Суздаль
⚡️ сходил с семьёй в Большой театр
⚡️ еду на Saint HighLoad++ 2026
⚡️ реализовал несколько крутых фичей по работе
⚡️ а главное... пережил предзащиту диссертации!


TL;DR по предзащите:

📌 было больно
📌 местами очень больно
📌 но я справился 🫡


Если Вам интересно, как вообще проходит предзащита в Бауманке и почему это отдельный жанр на грани фарса и трагедии, ставьте 🔥 - посвящу этому отдельный пост!

С уважением,
Михаил Масягин
  • 🔥 27
  • 👍 6
  • ❤ 3
Post #66
Channel photo updated
Post #63 491
Приветствую Вас на канале P(hD)ython 👋

#жизнь_айтишника

Меня зовут Михаил Масягин.

Я тимлид, разработчик, аспирант и преподаватель МГТУ им. Н.Э. Баумана.

Сейчас я руковожу backend - и frontend - разработкой в HFT - компании. До этого были Lawful Interception и Bare Metal - проекты, работа с AWS и даже погружение в ML и NLP.

С опытом я понял, что самые ценные знания обычно не попадают в учебники. Они появляются при решении реальных задач - через ошибки, багфиксы и дебаг, и, увы, часто теряются.


Именно поэтому появился этот канал. Здесь я буду делиться тем, что считаю реально полезным:

⚡️ Python и современные практики разработки
⚡️ оптимизация кода и performance engineering
⚡️ C, Linux и немного Bare Metal
⚡️ распределённые системы и архитектура
⚡️ алгоритмы и структуры данных
⚡️ HFT и инженерные решения из индустрии
⚡️ опыт из преподавания, аспирантуры и написания диссертации


Если Вам интересно не просто писать код, а понимать, почему он работает именно так, - добро пожаловать 🤝

С уважением,
Михаил Масягин
  • 🔥 24
  • 👍 11
  • 🤝 11
  • ❤ 4
  • 💩 1
Post #61 2.94K
«Финишная прямая 🎓»

#аспирантские_будни

Научный руководитель наконец одобрил текст диссертации, и сегодня я отнёс «кирпич» в 2-х экземплярах на финальную проверку на кафедру 😎!

Думаю, есть шанс, что первая предзащита будет в текущем учебном году (в июне).

С уважением,
Михаил Масягин

P.S. А ещё со следующего учебного года ассистент становится старшим преподавателем 😎
  • 🔥 25
  • 👏 10
  • ⚡ 4
Post #60 482
«Data Lake: от перестановки мест слагаемых сумма... меняется? 👷»

#system_design

Недавно проводил лекцию по DWH на курсе System Design от nevzorov.courses.

На лекции разбирали довольно частый практический кейс:
- есть ряд поддерживаемых источников данных (Sources);
- есть множество клиентов (Customers);
- для каждого клиента необходимо сохранять и обрабатывать данные из его источников (Customer Sources);
- вопрос: как лучше спроектировать Data Lake под эту задачу?


Вариант 1: customers/<customer_name>/source=<source_name>
Вариант 2: sources/<source_name>/customer=<customer_name>

Интуитивно рука тянется к 1 варианту... Однако для Data Lake и дальнейшей DWH-инфраструктуры часто лучше именно 2 вариант:

raw/sources/<source_name>/customer=<customer_name>/...
cleaned/sources/<source_name>/customer=<customer_name>/...
...


Например:

...
raw/sources/google_play/customer=rammstein/dt=2026-05-24/*.parquet
raw/sources/google_play/customer=sabaton/dt=2026-05-24/*.parquet
raw/sources/google_play/customer=megadeth/dt=2026-05-24/*.parquet
...
raw/sources/trustpilot/customer=rammstein/dt=2026-05-24/*.parquet
raw/sources/trustpilot/customer=led_zeppelin/dt=2026-05-24/*.parquet
raw/sources/trustpilot/customer=lordi/dt=2026-05-24/*.parquet
...


Почему?

1. Source естественным образом превращается в таблицу.

Для AWS Athena, Apache Trino или Apache Spark - google-play, trustpilot и т.д. - это отдельные логические таблицы, разложенные по Parquet-файлам и партициям в виде Customer'ов:

SELECT
*
FROM
"raw"."google_play"
WHERE
("customer" = 'rammstein') AND ("dt" >= DATE '2026-05-01');


У google-play даже в сыром виде (и уж тем более в очищенном) есть какая-то своя схема данных, ключи, timestamp'ы, правила дедупликации, SLA, логика инкрементальной загрузки и т.д.
У trustpilot и любого другого Source'а - свои.

Если же сделать наоборот:

...
raw/customers/rammstein/source=google_play/dt=2026-05-24/*.parquet
raw/customers/rammstein/source=trustpilot/dt=2026-05-24/*.parquet
...
raw/customers/sabaton/source=google_play/dt=2026-05-24/*.parquet
...


то один логический источник google-play размазывается по разным корням. А дальше начинается адъ 👹:
- отдельные таблицы на каждый Source каждого Customer'а;
- UNION ALL запросы и VIEW-шки;
- бардак с Data Governance.

В общем, Data Lake, а следом за ним и DWH медленно, но неотвратимо превращаются в DataSwamp 😄

2. Data Mesh проще делать именно по Source'ам.

Естественная единица владения - это не «папка клиента» (Customer), а доменный источник (Source).
У каждого такого Source'а есть отдельная команда-владелец, контракты, документация, SLA, data quality checks и правила эволюции схемы.

Команда, отвечающая за google_play, должна владеть одной папкой sources/google_play/customer=<customer_name>/*, а не тысячами подпапок customers/*/source=google_play/*.

- Добавили нового клиента? Добавили новую партицию.
- Поменяли контракт источника? Обновили один data product.
- Поймали баг в ingestion? Чиним одний единственный ETL-pipeline.

3. Pipeline'ы обычно тоже мыслят именно Source'ами:

...
google_play
trustpilot
...


А не:

...
ingest_rammstein_everything
ingest_sabaton_everything
ingest_led_zeppelin_everything
...


Иначе очень быстро появляются «особые клиенты»:
- у этого legacy CSV;
- у этого timezone в строке;
- у этого timestamp иногда null;
- у этого producer шлёт дубликаты;
- у этого «ну вы там руками поправьте, пожалуйста».

Поздравляю, у вас не DWH, а зоопарк с Airflow DAG-ами 🦓

4. Наконец, Source-First Layout упрощает сложную аналитику:

SELECT
"customer", count(*)
FROM
"raw"."google_play"
WHERE
"dt" = DATE '2026-05-24'
GROUP BY
"customer";


Можно с лёгкостью строить Usage-Based Billing по конкретным Source'ам, позволять даже менеджменту без труда копаться в данных и т.д.

Таким образом, проектируя DWH-систему лучше думать не о том, какие у вас будут клиенты, а о том, какие источники данных вы будете для них поддерживать.

С уважением,
Михаил Масягин
  • ⚡ 4
  • 🔥 3
  • 🤔 2
  • 💯 2
Post #59 429
«Cursor на миллиард 🤑»

#ai4sdlc

В нашей команде мы активно используем множество ИИ-инструментов, в том числе Cursor. Сидим на Teams Plan. И сегодня я нашёл в этом «плане» неприятный сюрприз.

В Teams Plan команда представляет собой одного админа (Admin) и множество обычных пользователей (Member). При этом имеется возможность ограничить расход средств, выставив максимально допустимую месячную сумму, которую команда тратит на токены: превысил лимит - жди следующего месяца.

Но оказалось, что по умолчанию функция выставления лимитов доступна не только админу, но и любому члену команды! Да-да, не админу, не владельцу карты, а обычному Member-у! Имхо, это крайне неочевидное и небезопасное поведение, о котором документация упоминает лишь всколзь.

Заходишь в Settings → Spend Limit → Team Spend Limit, ставишь лимит в миллиард долларов 💵 и уходишь на ночь, запустив 1000 и 1 агента 😎.

Auto-моделька Cursor уверенно говорит, что это не баг, а фича, дабы «упростить онбординг команды» 😁

Чтобы запретить это веселье, нужно отдельно включить тумблер: Settings → Usage-Based Pricing Settings → Admin-only modifications.
После этого вкладка Spend Limit исчезает у обычных пользователей.

Интересная, конечно, помощь в онбординге команды...

С уважением,
Михаил Масягин

P.S. Может, имелся в виду онбординг команды топ-менеджеров Cursor на очередную яхту 🧐?
  • 🤯 8
  • 👍 4
  • 😁 4
  • ❤ 2
Older posts →

About this channel

How can I read @phdython without a Telegram account?
TGViewer shows the public web preview Telegram publishes for P(hD)ython: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does P(hD)ython have?
P(hD)ython (@phdython) has 332 subscribers on Telegram, refreshed roughly every 30 minutes.
Does P(hD)ython know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →