TGViewer
Channel Public Channel
I hate overtime

I hate overtime

@overtimehate

Some DevOps, SRE and IT development stuff
Subscribers
848
Photos
129
Videos
4
Links
961

Showing posts older than #1071 · Back to latest

Older Posts 20 shown
Post #1070 66

Forwarded from DataEng

Интересный обзор новых БД от автора книги Seven databases in seven weeks. Автор планирует написать 3 поста с небольшими обзорами главных фич.

Первая часть посвящена: TileDB, Materialize и Prisma. Во второй части будут разобраны EdgeDB, Tremor и Debezium (CDC). И в финальной части автор обещает сделать выводы.

Ссылка на статью: https://lucperkins.dev/blog/new-db-tech-1/
Post #1069 59

Forwarded from FEDOR BORSHEV

Фабрика фич и просранное время

Когда в компании появляется быстрая разработка (а такое бывает, да), возникает большой соблазн превратить команду разработки в фабрику фич. Фабрика фич — это маленький заводик по клепанию фич без оглядки на реальность, когда никто не прогнозирует и не замеряет воздействие на бизнес. Такой подход быстро превращает продукт в болото из ненужного кода, в котором никто, включая разработчиков и QA, не знает, как должна работать та или иная фича.

Чтобы вылечить такие ситуации, я внедряю цикл Шухарта, когда вместо больших фич мы делаем маленькие гипотезы, замеряем их воздействие на бизнес, а потом уже делаем большие задачи, точно так же замеряя их денежный выхлоп. Типичная проблема с внедрением — когда бизнесовым ребятам пофиг на все эти продуктовые циклы: у них прямо сейчас фича горит, надо просто сделать и, вообще, нет времени объяснять.

Специально для таких ребят я придумал статус задачи «просранное время». Туда мы переводим все задачи, которые сделали в обход полноценного цикла проверки гипотез и которые при этом не оказали никакого воздействия на деньги. Такая «доска позора» где-нибудь в Трелло здорово мотивирует думать головой вместо того, чтобы давить на продуктовую команду.

Очень важно — в «просранное время» ни в коем случае нельзя переводить гипотезы, которые прошли по продуктовому циклу, но не выстрелили — если вы сели, придумали, как быстро проверить гипотезу, проверили и она не выстрелила, вы молодцы, и никакого времени мы не просрали.
Post #1068 941
Post #1065 598
I hate overtime #jvm Очень интересная статья про обработку ошибок в Kotlin'е. Наиболее важным, имхо, тут являются даже не дизайнерские решения jetbrains(хотя это тоже интересно), сколько мотивация ухода от java checked exceptions.
сорямба, опять ссылку потерял((
Post #1063 4.46K
#management
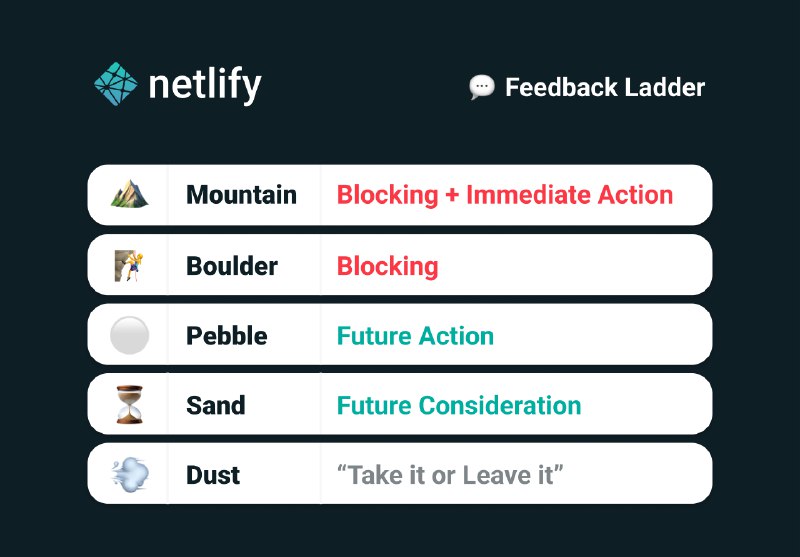
Наконец-то прочитал статью про ревью в netify, и прям проникся идеей.
Собственно проблема:
Наверное часто у всех на ревью возникало ощущение, что ревьюер придирается и на "такое" уж точно можно было закрыть глаза.
Решение:
Каждый коммент в ревью тегается меткой, означающей значимость. Netify выбрали для этого... камни. Например
[boulder] something is wrong with xxx
Netlify Feedback Ladders: The Code Review System We Follow at Netlify Learn more about Netlify UX team's code review process called the Feedback Ladder. We developed a system of shared terminology - naming conventions that describe each step. Check it out!
Post #1062 614
Оказывается у Hydra Conference есть свой очень крутой подкаст. Крайне рекомендую! Там пока всего 4 выпуска, но все прям огонь
Post #1061 752
#java
Тут вот наткнулся на сборник заметок по Java. С удовольствием полистал. Будет полезно, если знакомитесь с языком или готовитесь к собесу.
Ну и автор просил поблагодарить звездочкой и фидбеком
Post #1059 751
#frontend
И еще немножечко фронтенда:
1. Шикарный труд про кишки webpack. И нет, там не просто экскурсия по исходникам, а инструкция как сделать свой простенький сборщик
2. Все же знают, что современный фронтенд использует транспиляцию(возможность заюзать современный JS последнего стандарта в доисторическом браузере)? Но мало кто знает как это работает. А вот тут вот подоспел чудо-доклад про устройство транспиляторов(babel'а в частности)
Post #1058 685
#frontend
Очень годный лонгрид про микрофронтенды. Расписано все от мотивации до технических аспектов. Лично для меня интересное началось с середины(способов композирования), но пробежаться по мотивационной части тоже будет полезно
Increment Micro-frontends in context When—and why—should developers consider this newer, smaller frontend architecture pattern?
Post #1057 46

Forwarded from Consensus

Наткнулся на очень крутую работу про LSM деревья 🔥

Авторы вначале вкратце разбирают как работает LSM-tree.

Затем рассказывают про существующие методы оптимизации LSM деревьев, например:
🔸 Как уменьшить Write Amplification Factor (который, кстати, уменьшает время жизни SSD)
🔸 Какие есть методы ускорения merge операций
🔸 Какие оптимизации позволяют LSM дереву использовать возможности SSD/NVMe и скэйлится по CPU
🔸 Техники auto-tuning'а и построение secondary index и т.д.

В конце авторы разбирают имплементации RocksDB, HBase, Cassandra, AsterixDB.

В общем это must read для тех, кто использует LSM-tree или собирается использовать.

Такой настольный white paper для пользователя LSM-tree 😉

Ссылка на white paper:
https://arxiv.org/pdf/1812.07527
Post #1056 47

Forwarded from Архитектура ИТ-решений

В свое время пропустил перевод https://habr.com/ru/post/441538/ вот этого замечательного текста https://panoply.io/data-warehouse-guide/data-warehouse-architecture-traditional-vs-cloud/
Билл Инмон против Ральфа Кимбалла (Естественно, я за второго, а вы?) "Звездочка" или "Снежинка, ETL vs. ELT, облачное хранилище от Amazon и BigQuery от Google. ... что там ещё?

Впрочем и этих vs. вполне хватит :-)
Хабр Архитектура хранилищ данных: традиционная и облачная Привет, Хабр! На тему архитектуры хранилищ данных написано немало, но так лаконично и емко как в статье, на которую я случайно натолкнулся, еще не встречал. Предлагаю и вам познакомиться с данной...
Post #1055 41

Forwarded from (

да нахуй оно не надо, можно просто взять рантаймовый диай и проверять корректность графа тестами
Post #1054 645
Post #1053 643
Хекслет # Почему ООП — это плохо Создатель языка Erlang Джо Армстронг написал эту статью 20 лет назад. Но в ней поднимаются важные и острые вопросы, поэтому мы перевели этот материал для вас. Армстронгу не нравилось ООП по разным причинам. В статье он поделился…
Не в полной мере согласен, но статья интересная, рекомендую. Тем более, что перевели на русский
Post #1052 41

Forwarded from Хекслет (hexlet_bot)

# Почему ООП — это плохо
Создатель языка Erlang Джо Армстронг написал эту статью 20 лет назад. Но в ней поднимаются важные и острые вопросы, поэтому мы перевели этот материал для вас.

Армстронгу не нравилось ООП по разным причинам. В статье он поделился несколькими из них:

- Функции и структуры данных имеют разную природу, поэтому с ними нельзя работать, как с одинаковыми сущностями.
- Отношение к любой сущности как к объекту усложняет работу. В объектно-ориентированном языке, например, в Smalltalk, даже число — объект. А в Erlang это экземпляр типа данных.
- В объектно-ориентированных языках принято прятать состояние. По мнению Джо Армстронга, это худшее из возможных решений.

Подробнее об отношении Армстронга к объектно-ориентированному программированию читайте в нашем блоге.
Post #1051 46

Forwarded from 4gophers

Канал Юры Насретдинова на английском языке, где он разрабатывает распределенную key-value базу данных на Go. Касаются различных подходов к шардированию, как делать решардинг, и многое другое.

https://www.youtube.com/watch?v=Mgd9_P3D6u8
YouTube Distributed key-value db in go #3: automated testing In this video we will write unit and functional tests for the distributed key-value database in Go (golang). We don't want to make our comrads (and ourselves) suffer too much when testing things manually so we need to automate it. The database uses BoltDB…
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →