TGViewer
Channel Public Channel
Организованное программирование | Кирилл Мокевнин

Организованное программирование | Кирилл Мокевнин

@orgprog

Делюсь опытом и обучаю. И ИИ? И ИИ. Ютуб https://youtube.com/@mokevnin
AI Клуб @hexletclub | Внедрение AI в SDLC https://praxor.ru/
Для предложений в личку канала
Subscribers
14.2K
Photos
90
Videos
0
Links
378
Recent Posts 20 shown
Post #517 3.06K
Банда четырех для эпохи агентов

Количество паттернов по тому, как эффективно работать с ИИ, дошло до точки, когда их уже нужно собирать, фильтровать и классифицировать. Как ни странно, чего-то подобного в сети нет даже на английском (в том виде как мне бы хотелось), поэтому пришлось делать самому.

В общем, встречайте, возможно, это первая книга, которую я допишу до конца: Agentic Design Patterns.

Что это такое? Каталог паттернов агентного программирования в духе «Банды четырёх». Каждый паттерн это проверенное решение повторяющейся задачи при работе разработчика с ИИ-агентом: как поставить задачу, дать контекст, проверить результат и организовать проект.

Сейчас в книге уже 32 готовые главы: 27 паттернов и 5 антипаттернов. Они разбиты на шесть больших разделов: постановка задач, SDD, работа с контекстом, верификация, организация проекта и антипаттерны.

Например, там уже есть Four Phases (Explore → Plan → Code → Commit), Context Engineering, OpenSpec, Writer–Reviewer, TDD with Agent, Isolated Parallel Work, Executable Guardrails и другие практики, которые постепенно становятся стандартным набором при работе с coding agents.

Здесь же про SDD и антипаттерны. Помните, я писал статью про преждевременную спецификацию? Именно с нее все началось.

Книга, по сути, сборник того хорошего, что появляется в сети, плюс какие-то мои мысли и попытка привести всё это к общей системе. Причем фокус именно на том, как разработчик работает с агентом, а не на устройстве самих агентных систем — orchestration, routing и прочая внутренняя кухня агентов сознательно вынесены за рамки.

Все это open source, книга уже ведется на русском, английском и испанском, а участие всячески приветствуется!

Telegram | YouTube | AI Клуб | Внедрение AI
mokevnin.github.io Введение · Agentic Design Patterns
  • ❤ 89
  • 🔥 51
  • 👍 35
  • 😁 9
  • 💩 6
  • 👎 2
  • 👏 2
  • 🤯 1
  • 🤡 1
  • 🥴 1
Post #516 5.55K
Главное правило принятия архитектурных решений

Когда-то давно в одной из книжек я прочитал такую фразу: "Defer decisions until the last responsible moment". Не то чтобы я сразу понял и проникся, но со временем, этот принцип стал важной частью моих правил работы.

Его популяризировали Mary и Tom Poppendieck в книге Lean Software Development: An Agile Toolkit. Суть принципа в том, что необратимые или дорогие в изменении решения стоит принимать не "как можно раньше", а настолько поздно, насколько это безопасно, то есть когда дальнейшее откладывание уже начнет закрывать важные альтернативы.

В архитектуре это обычно формулируют примерно так:

> Delay architectural decisions until the last responsible moment

Важно именно responsible, а не possible. То есть это не "тянуть до последнего", а сохранять пространство вариантов, пока появляется новая информация.

Приведу пример. Когда Хекслет только стартовал и мы запустили практику в браузере, то на обслуживание этой системы уходил один сервер. Со временем количество студентов росло и нагрузка на него сильно выросла. Причем речь идет не о просмотрах страниц сайта, одна практика это полноценный контейнер с кучей сервисов, терминалами, самим редактором и запуском практик, по ресурсам это очень много. Но на тот момент мы не до конца понимали, как лучше распилить эту систему и каждый раз когда упирались ограничения, то просто переходили на все более мощный сервер. И только спустя несколько лет эксплуатации этой системы, мы наконец-то окончательно поняли как лучше ее развивать с учетом большого количества очень специфичных проблем для такой задачи.

Мы могли начать строить распределенную систему гораздо раньше. Технически для этого уже были причины. Но у нас еще не было знаний, необходимых для хорошего решения. Более мощный сервер покупали нам не только производительность, но и время на то, чтобы понять систему.

Вообще тема проектирования красной линией идет через все мои публикации, но я все равно получался сапожник без сапог, потому что занимаюсь образованием и по проектированию систем у меня не было никаких материалов, только по архитектуре кода. Давно собирался это исправить и наконец-то это произошло, я в соавторстве с очень крутым человеком из большой известной международной компании подготовил масштабный курс по системному дизайну. Гляньте программу, думаю вам понравится. Ближайший запуск 21 сентября, сама программа идет 4 месяца.

Telegram | YouTube | AI Клуб | Внедрение AI
ru.hexlet.io Курс «Системный дизайн» Научитесь проектировать масштабируемые системы, рассчитывать нагрузку и готовиться к секции System design на собеседовании.
  • 👍 46
  • 🔥 22
  • ❤ 12
  • 🥴 3
  • 👏 1
Post #515 6.64K
Сегодня у меня в гостях Александр Поломодов, который до недавнего времени был одним из проектировщиков AI SDLC трансформации в Т-банке. Мне давно было интересно узнать его мнение по тому, как трансформируются компании и разработка в будущем в гораздо более широком смысле чем просто SDD. Саша пропускает через себя много white papers и держит руку на пульсе. https://www.youtube.com/watch?v=uImPHIhHzFs

Telegram | Аудио | vk | Системный дизайн
YouTube Как AI изменит разработку ПО: будущее программистов, команд и IT-компаний /Александр Поломодов #92 🔹 Присоединяйся к курсу «Системный дизайн» https://ru.hexlet.io/programs/system-design?utm_source=youtube Через несколько лет в IT может не остаться привычного разделения на фронтендеров, бэкендеров, аналитиков и тестировщиков. Не потому, что эти задачи…
  • 🔥 32
  • ❤ 18
  • 👍 16
  • 🤮 10
  • 🥰 1
Post #514 6.86K
Ассемблер неправильная абстракция

Каждый раз когда заходит речь о повышении уровня абстракции, в разговоре всплывает ассемблер в стиле "когда то мы писали на нем, а теперь не пишем". Особенно часто это повторяют сейчас в эру AI. Честно говоря, мне это никогда не казалось правильным сравнением и кажется я могу объяснить почему.

Переход от ассемблера к языкам высокого уровня был переходом от слишком низкого уровня завязанного на технические детали, к конструкциям, которые задают базис для построения программ практически любой сложности. И вот этот уровень принципиально не менялся десятки лет. Менялись языки, платформы, библиотеки и способы организации кода, но сам программист продолжал работать примерно с теми же конструкциями. Программа на современном языке устроена концептуально почти так же, как программа пятьдесят лет назад.

Но после этого характер повышения абстракции изменился. Мы больше не поднимались от технической реализации к естественной модели вычислений. Мы пытались подняться от программирования к описанию намерения, того, что должна делать система, и автоматически получить реализацию задуманного.

Cobol был одной из первых попыток подняться от описания вычислений к описанию бизнес-намерений. Предполагалось, что программы на похожем на английский языке смогут читать и, возможно, писать сами специалисты бизнеса. Но понятный синтаксис не устранил сложность программирования. Для точного описания поведения все равно понадобились переменные, условия, циклы, структуры данных и процедуры. В результате cobol стал успешным языком для бизнес-систем, но не стал языком самого бизнеса, так как писали на нем по-прежнему программисты.

Успешные примеры появились там, где намерение удалось ограничить конкретной и хорошо формализованной областью. Хорошие примеры это регулярки, sql, html/css или terraform. Это конечно еще не бизнес уровень, но уже что-то.

Для разработки произвольных программ такую модель создать не получилось. Как только языку намерений требовалось описывать нестандартное поведение, в нем появлялись все привычные конструкции. Постепенно он снова превращался в обычный язык программирования, только с другим синтаксисом и новым набором абстракций.

Это хорошо видно на примере BDD. В изначальной идее сценарии на языке, понятном бизнесу, должны были стать общей спецификацией системы и одновременно основой для автоматической проверки. Но довольно быстро выяснилось, что реальные сценарии либо остаются понятными, но описывают только верхний уровень поведения, либо становятся достаточно точными для исполнения, но обрастают техническими деталями и фактически превращаются в еще один код. А между сценариями и работающей системой все равно остается большая часть логики, которую кто-то должен спроектировать и реализовать.

Я не думаю, что AI решает эту проблему. Спецификация произвольной системы либо остается неполной, и тогда множество неописанных решений агент принимает самостоятельно, либо обрастает правилами, исключениями, состояниями и способами обработки ошибок и по сложности начинает приближаться к самой программе. AI может значительно увеличить расстояние от намерения до кода и избавить нас от ручной реализации многих деталей, но он не создает универсального уровня абстракции, на котором можно точно описывать любые системы и при этом не программировать.

Я был бы рад ошибиться, но пока не вижу предпосылок. А как вы думаете?

Telegram | YouTube | AI Клуб | Внедрение AI
Telegram Хекслет Программы обучения - https://ru.hexlet.io/courses Сообщество @hexletcommunity AI Клуб @hexletclub Поддержка @hexlet_help_bot
  • 👍 70
  • 💯 20
  • ❤ 11
  • 🔥 5
  • 👎 1
Post #513 7.11K
Уровни зрелости ai в sdlc

Несмотря на то, что все кричат про ИИ, в большинстве компаний реальный уровень внедрения это "мы с клодом кодим парой". Это вроде как неплохо, но уже делают все так или иначе (отрицателей в расчет не берем). А дальше что? Общей модели не придумали, но есть плюс минус устоявшийся взгляд на уровни зрелости:

1. AI как личный инструмент. Разработчик работает с coding-агентом: пишет код, тесты, разбирается в кодовой базе, делает рефакторинг.

2. AI как часть командной среды. Агент получает нормальный контекст проекта: правила, документацию, архитектуру, историю решений, задачи. Появляются общие инструкции, skills, harness, SDD и воспроизводимые способы работы вместо "каждый промптит как умеет".

3. AI внутри SDLC. AI подключается не только к коду, но и ко всему процессу: тикетам, документации, CI/CD, code review, мониторингу, логам и остальным инженерным системам. Появляются устойчивые воркфлоу, которые проходят через несколько этапов разработки.

4. Агентные процессы. Агент самостоятельно выполняет целые куски работы: берет задачу, исследует код, реализует, проверяет, открывает PR; расследует инцидент; обновляет документацию. Человек все больше задает цель, ограничения и принимает результат.

5. Самоулучшающийся AI SDLC. Работа агентов измеряется эвалами и продуктовыми/инженерными метриками. Harness, контекст, модели и воркфлоу постоянно меняются на основании данных. Компания оптимизирует весь AI-конвейер разработки.

Все это может выглядеть идеализированно, но элементы разных уровней уже постепенно проникают в реальную разработку. То, что еще вчера казалось фантастикой, сегодня вполне работает. Не идеально конечно, но никто и не обещал легких путей.

А теперь самое интересное. Какие шаги нужно предпринять чтобы двигаться по этим уровням? Например нужен контекст через раги и mcp:

• интеграция всех коммункаций (чаты/почты/тикеты)
• интеграция базы знаний
• интеграция сервисов (от sentry до grafana)

В лучшем случае это встроено в корп системы типа microsoft, google workspaces, yandex 360 (они только интегрируют), в худшем надо самостоятельно делать раги и писать mcp. Кто-то уже прошел этот этап, но многие еще не дописали. Где-то параллельно должно развиваться SDD и куча разных воркфлоу начиная от код ревью, заканчивая автономным расследованием сбоев (желательно автономным). Причем проблема не всегда в том чтобы дать доступ, а в том чтобы дать его в нужном объеме и нужным людям, иначе что-нибудь лишнее утечет или "ой, снесло базу данных".

Так получилось, что ко мне стало обращаться все больше и больше компаний (особенно после моего летнего трипа), на эту тему, поэтому я от "пишу про ai в sdlc" пришел к "внедряем ai в sdlc". Встречайте праксор, компанию, которую мы организовали с основателем ScrumTruck Асхатом Уразбаевым, который имеет прямое отношение к Agile-трансформации многих крупных российских бигтехов и энтерпрайзов.

В общем если ваша компания хочет ускориться и сделать все правильно, то пишите, мы с удовольствием станем вашим надежным партнером в этом непростом деле (можно через заявку на сайте, можно в директ канала)

p.s. На каком уровне развития сейчас ваша компания и как идет продвижение?

Telegram | YouTube | AI Клуб | Внедрение AI
praxor.ru Праксор — AI SDLC для инженерных команд За 3 месяца выстраиваем AI SDLC на пилотной команде: внедряем AI-агентов в процесс разработки, измеряем влияние на скорость и качество.
  • 💩 42
  • 🔥 25
  • ❤ 16
  • 👍 8
  • 🤔 4
  • 🤡 4
  • 🤮 3
Post #512 6.67K
Post #511 7.43K
Post #510 8.14K
Сетапим окружение с нуля

Коротко: mise умеет сетапить не только версии языков под проект, но и настраивать все окружение, по сути упрощая настройку как машины так и проекта до буквально одного файла. Я на этой неделе перевел на него и свои dotfiles (https://github.com/mokevnin/dotfiles) и проекты.

Кто-то скажет, нафига мне это надо у меня все в докере. У меня на этот счет два соображения, даже если у вас язык в докере, снаружи часто есть разного рода cli, которые нужны всем (и нам и агентам). Сюда относятся cli агенты, терминалы, docker compose, kube, helm, git, google cloude, oh my zsh и еще тыща приблуд, которые хочется сетапить. И второе, есть немало людей, которые разрабатывают не только готовые приложения, но и библиотеки, например, я работаю с большим количеством опенсорса, где докера нет и нафиг не нужен (с ним тупо сложнее, а стейта там нет).

Напомню, что mise (придеший на замену asdf) это, пожалуй, самый классный способ управлять версиями языков в конкретном проекте. Он работает универсально для любого стека и ставит ровно то что нужно чтобы работал конкретный проект делая сетап независимым. В принципе это давно существующая штука и под каждый язык есть менеджер версий (не путать с пакетным менеджером).

Но mise пошел дальше и сделал декларативный способ указывать что засетапить, какие симлинки создать и так далее. Причем он не пытается построить абстракцию поверх существующих решений (как некоторые devops тулзы), в нем явно описывается что откуда ставить. А уже дальше, когда будет выполняться настройка, mise сам определит что конкретно запускать на текущей системе. Если у нас mac, то он не будет запускать apt, но запустит brew. Кусочек файла mise.toml:


[settings]
idiomatic_version_file_enable_tools = []
dotfiles.root = "~/dotfiles"
dotfiles.default_mode = "symlink"

[tools]
node = "26.7"
ruby = "latest"
pnpm = "latest"
overmind = "latest"
caddy = "latest"
docker-cli = "latest"
docker-compose = "latest"
fzf = "latest"

[bootstrap.packages]
"brew:libpq" = "latest"
"brew:vips" = "latest"
"apt:git" = "latest"
"apt:libpq-dev" = "latest"
"apt:libvips" = "latest"

[bootstrap.repos]
"~/.oh-my-zsh/custom/plugins/you-should-use" = { url = "https://github.com/MichaelAquilina/zsh-you-should-use.git", ref = "master" }

[dotfiles]
"~/.config/nvim" = "nvim"
"~/.config/mise/config.toml" = { source = "mise.toml", mode = "symlink" }


И теперь достаточно в папке с этим файлом набрать mise upgrade и вуаля. Тоже самое если с нуля

В общем я попросил клод проанализировать мою систему и проекты. В результате он добавил mise.toml в несколько основных проектов и полностью пересобрал мои dotfiles, удалив кучку всяких скриптов и make тасков. Заодно я попросил его подсказать, что еще классного есть в мире cli что стоит поставить. Он нашел десяток полезнях, которые я теперь юзаю. Например он поставил какую-то прикольную штуку, которая меняет поиск через "вверх" в терминале, когда жмякаешь эту кнопку, то он сразу показывает список всего что было набрано до этого.

Telegram | YouTube | AI Клуб
  • 🔥 48
  • 👍 19
  • ❤ 11
  • 🤡 6
  • 👎 2
  • 💩 2
Post #509 7.92K
Адаптация проекта под LLM

Есть два подхода к организации агентного программирования в проекте. Первый это все описывать и заставлять агентов делать все как надо, второй - менять проект под ожидания ии. Обычно в проектах делают и то и то, но сейчас я бы хотел акцентировать внимание на втором.

Чем дольше живет проект, тем больше в нем косяков в именовании (чего угодно), кастомных решений и самопальных либ, разных подходов в реализации одного и того же (накопленных за годы). А еще просто банально устаревшие штуки, которые уже давно никем не используются. Раньше мы со всем этим жили, потому что времени на исправления нет, но где-то год назад начали массовые рефакторинги, которые сейчас почти закончены.

Правда мне регулярно возражают, что вот у нас так а llm хочет сильно по другому или llm делает фигню. Это правда, llm может делать фигню, но далеко не всегда потому что она училась только на говнокоде. И модель и харнес и много чего влияет, но, глобально, модель учится на типовом коде и ее решения достаточно типовые, поэтому в большинстве случаев можно пренебречь какими-то своими ноухау и быть как все. Что не отменяет элементов, которые приходится делать по другому.

Есть и другой поинт, что модель поменяется и захочет делать по другому. Не захочет потому что обучение идет на одних и тех же данных, которых становится только больше. А деградировать ей просто не даст рынок, тогда все уйдут туда где как минимум не хуже.

Ключевые вещи которые мы сделал:

Там где получилось, привели имена в домене к общепринятым (мы мучали llm отдельно от проекта на тему того какой понятийный аппарат используется в образователей сфере. Может показаться что это фигня, но нет, есть немало слов, про которые мы не то чтобы сильно знали, потому что все это было заложено лет 12 назад, а с тех пор многое утекло. Иногда наше именование не совпадало с общепринятыми (международными) понятиями, а иногда просто все так поменялось, что потерялось изначальное значение. Раньше мы даже взяться за это не могли, а тут без проблем, даже учитывая что один такой пулреквест может тянуть изменения в сотнях, а то и тысячах файлах (спасибо типам и тестам за контроль).

Привели в порядок имена слоев внутри кода, у нас типами называлось то что было не типами. В общем привели в порядок имена сервисов, dto и других штук. Иначе llm регулярно делало не те выводы. Да и в целом лучше развели по слоям и уточнили барьеры абстракции, когда есть четкие правила, что может и не может быть входом или выходом на каждом уровне. Например внутрь сервиса может поступать только структура, модели появляются внутри, но не снаружи и тому подобное. Когда единообразие стало повсеместным, генерируемый код стал максимально предсказуемым.

Иишка смогла найти готовые решения, благодаря которым мы выкинули немало самопала. Это может выглядеть контритуитивно, но несмотря на то что ии позволяет нахерачить все самим, лучше брать готовые промышленные решения (популярные и стандартные). Это касается как фронтовой части (полностью ушли на Mantine), где теперь мы получаем почти 100 процентный уровень генерации в one shot режиме, так и решения для бекендовых задач, например подписок, которое требует определенной модели данных и предоставляет готовые общепринятые сущности.

Плюс постепенное обрастание спеками, проработанными тикетами, глоссарием, adr, коммитамии с хорошими сообщениями, все это вместе дало возможность ии гораздо быстрее и точнее понимать что происходит.

На активный рефакторинг ушло чуть больше года, сейчас мы тоже продолжаем доводить, но уже точечно, потому что ключевые вещи поправлены и иишка достаточно хорошо понимает проект. Следующий шаг, это создание и добавление детерминированных инструментов стат анализа, которые чекают достаточно высокоуровневые вещи.

Telegram | YouTube | AI Клуб
Telegram Хекслет Программы обучения - https://ru.hexlet.io/courses Сообщество @hexletcommunity AI Клуб @hexletclub Поддержка @hexlet_help_bot
  • 👍 73
  • ❤ 19
  • 🔥 18
  • 🥱 4
  • 😁 2
Post #508 7.48K
Прошлый раз с лайвкодингом породил так много вопросов, что пришлось записать еще один выпуск. Он состоит из двух больших тем:

1. Мой сетап. Как устроен мой воркфлоу кодинга: терминалы, комбо, слепая печать, навигация использование специализированных тулов.
2. SDD. В прошлый раз не все заметили, что кроме мелких тикетов, был один, который я делал по spec driven development, поэтому в этот раз мы прямо сетапим воркфлоу Matt Pocock и через него делаем одну задачку

https://www.youtube.com/watch?v=CVJ01XSmHEY

p.s. Продолжать такие подкасты или хорош лайвкодинга?

Telegram | Аудио | vk
YouTube Лайвкодинг с Claude Code: Spec-Driven Development на реальном TypeScript-проекте 🔹 Присоединяйся к курсу «ИИ для разработчиков» https://ru.hexlet.io/programs/ai-for-developers?utm_source=youtube Первая часть видео: https://youtu.be/Eplxom-e1C4 В этом выпуске продолжаем тему AI-разработки и разбираем уже не просто лайкодинг, а то, как…
  • ❤ 73
  • 👍 53
  • 🔥 19
Post #507 10.2K
Post #506 9.37K
Зачем ускорять разработку?

Просто через раз вижу этот вопрос, во всех постах про агентов и новую эру автоматического кодинга. Переубедить конечно никого не получится, но написать надо, чтобы получилось структурировано. Погнали.

Нет такого количества задач

Если вы поговорите не с менеджерами, а владельцами бизнесов, то окажется, что количество идей у них такое, что за всю жизнь не сделать. То что из этого не всегда доходит до низов, проблема размера и процессов, которые тоже пытаются решать, поэтому так много разговоров про sdd и аналогичные истории.

Если разработка стала в два раза дешевле/быстрее, становятся экономически оправданными задачи, которые раньше вообще не попадали в backlog.

Это никому не нужно

В конкурентном мире невозможно сделать продукт до конца и сидеть сложа руки. А конкуренция приводит еще к тому, что кто первый встал, того и тапки. Сегодня вы на высоте, завтра ваш бизнес угрохали потому что вы не успели адаптироваться.

Ну если вы работаете у монополиста/госа/стратегического игрока, то можете игнорировать этот пункт 🙂

Фичи не принесут деньги

Может принесут, а может и нет, это невозможно обобщать не зная конкретных обстоятельства конкретных ситуаций. Например мы годами не могли сделать b2b кабинет таким как хотели наши клиенты, потому что у нас никогда не хватало ресурсов на эту часть. С помощью агентов мы это сделали и смогли получить хорошие контракты, которые от нас раньше уплывали.

Ускорение разработки меняет не только скорость выполнения уже выбранных задач, но и сам набор задач, которые становится рационально делать.

Покажите как это сократило фот?

По правде говоря у многих сократило. Но последовательность другая. Последние годы у многих были сокращения по экономическим причинам, а потом заморозка найма при одновременном росте производительности за счет ИИ. Поэтому ии больше повлиял не на сокращение как таковое, а на отсутствие найма

Покажите как это увеличило прибыль?

В экономике есть только два способа растить маржинальность: рост производительности и повышение цены. Когда то массовое внедрение компьютеров и экселя привело к такому же эффекту.

Итого

Ускорение разработки само по себе не цель. Реальная цель это снизить стоимость изменения продукта, поэтому помимо разработки одновременно ускоряется еще много всего, но об том просто говорят в других местах, куда разработчики не ходят, поэтому у них часто складывается такое одностороннее представление о происходящем

Telegram | YouTube | AI Клуб
Telegram Хекслет Программы обучения - https://ru.hexlet.io/courses Сообщество @hexletcommunity AI Клуб @hexletclub Поддержка @hexlet_help_bot
  • 👍 71
  • ❤ 24
  • 🔥 12
  • 🤡 9
  • 🤔 1
Post #505 10.1K
Вперед к монорепам

Практика показывает, что эффективнее всего с агентами работать тогда, когда весь контекст есть по рукой и можно просто погрепать, причем речь идет не про один какой-то конкретный сервис/проект, а когда все репозитории проекта, лежат в одной папке, а возможно даже в одном репозитории. В таком случае и дока общая (это важно для спек) и все просвечивается насквозь и пулреквесты можно сразу бахнуть везде.

Но многое зависит от размеров. Понятно что вообще все сервисы в одно место может быть перебором, скорее это правило применимо к командам и тому что у них там внутри. Но это не мешает теоретически заливать и чужие сервисы рядышком, чтобы по ним можно было погрепать если это имеет смысл.

Объединения можно добиться двумя способами. Один это тупо все свалить в одну репу (что не заставляет нас собирать все как единый проект) и работать всегда из корня. Более того, в некоторых языках системы сборки поддерживают прямо такой режим работы, поэтому в какой-нибудь Java, получается двойной выигрыш. Второй, это сделать единую высокоуровневую репу, в которой хранятся спеки и любые другие общие доки, а дальше с помощью настроенных команд все клонируется внутрь по подпапочкам. Делать это кстати не обязательно ручками/скриптами, для этого уже есть готовая утилита ghorg.

Ну а дальше, эта репа постепенно обрастает артефактами: доками и скриптами, которые помогают работать на всем объеме репозиториев. Если еще на это насадить openspec так вообще красота.

Кстати у последнего появилась такая штука как Store, это как раз подобный репозиторий, но без необходимости все складывать внутрь одной папки. Там идея такая что репа со спеками (Store) кладется в домашнюю директорию, а в репах проекта на нее дается ссылка. Дальше команды openspec все это знают учитывают и работают со Store отдельно.

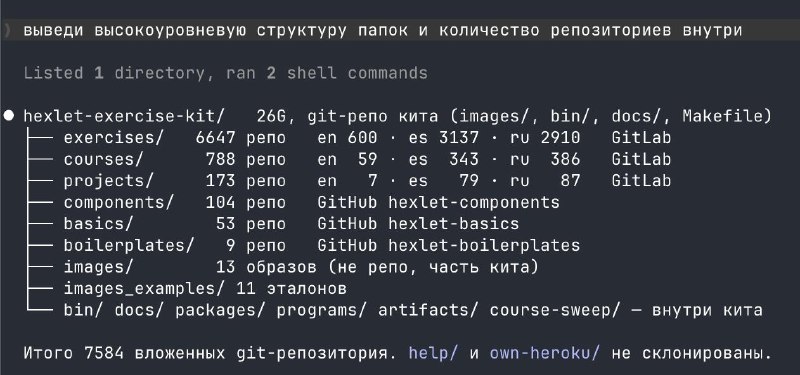
И расскажу про наш кейс. На хекслете много практик и проектов. Каждая сущность это своя репа (потому что свой релизный цикл) и даже каждый курс (тексты) это тоже своя репа. Суммарно это под 8000 репозиторев. Плюс для них есть набор базовых образов и разных проверочных скриптов. Так вот у нас всегда существовал подход, когда есть одна базовая репа с общими штуками и туда с помощью make clone добавлялись все эти репы. Но правилось это ручками. А сейчас мало того, что ии может менять все пачками (например связано обновить версию react в курсе + практиках + проекте), так мы еще добавили туда редактор (на него завязана часть логики) и сотни наших реп с гитхаба, куда мы выкладываем разного рода библиотеки и базы данных для курсов. То есть теперь в одном месте практически 100 процентный контекст (осталось еще mcp на хекслете завести, чтобы еще фидбек по курсам и вопросы в ассистента связать). У нас бывают дни, когда мы можем за раз поправить 500-1000 реп.

Раньше команда которая обновляла все это добро состояла из 5 человек. Сейчас один человек делает больше чем это делалось тогда. Вот такое ускорение (но и задача специфичная)

Telegram | YouTube | AI Клуб
  • 👍 53
  • ❤ 15
  • 🔥 7
  • 🥴 2
  • 😁 1
  • 🎉 1
Post #504 9.82K
Post #503 12K
Открытие дня. Все же знают dependabot, который обновляет зависимости всего и вся на гитхабе? Причем речь не только про пакетные менеджеры всех языков, но и например github actions и даже версии образов в Dockerfile. Так вот есть такое же решение, не привязанное к вендору.

Небольшая предыстория. Помимо гитхаба у нас есть свой гитлаб с большим количеством реп, в котором так же находится инфраструктура запуска практик Хекслета. В нее входит репа с кучей Dockerfile под разные экосистемы, которые мы используем как базовые образы для практик запускающихся в браузере. В этой репе есть просто все что только можно себе представить: версии образов, версии дев тулов, версии зависимостей, причем часто указываемые напрямую в Dockerfile. Обновлять все это добро раньше было отдельным приключением. С иишкой стало проще, но один фиг это процедура, которой надо заниматься.

А на днях делая очередное обновление, я подумал какого хрена, по-любому должно же что-то быть. Попросил клод найти и он нашел. Оказалось что есть такая штука как Renovate, которая очень похожа на dependabot, но работает еще круче. Мало того, что она может обновлять все версии в стандартных случаях, так эта фигня умеет обновлять версии, которые заданы числами в разных местах за счет спец разметки:


# renovate: datasource=maven packageName=org.apache.maven:maven
ARG MAVEN_VERSION=4.0.0-rc-6
# renovate: datasource=java-version packageName=java-jdk
ARG JAVA_VERSION=25


Все это расставил сам клод и написал мне такую таску:


make deps-check
images/base/Dockerfile setuptools 83.0.0 -> 84.0.0
images/java-base/Dockerfile java-jdk 25 -> 25.0.4+7.0.LTS
images/multi-language/Dockerfile java-jdk 25 -> 25.0.4+7.0.LTS


Ну и все это добро отлично подключается к ci и шлет пулреквесты с обновками. Пользуйтесь

Telegram | YouTube | AI Клуб
Telegram Хекслет Программы обучения - https://ru.hexlet.io/courses Сообщество @hexletcommunity AI Клуб @hexletclub Поддержка @hexlet_help_bot
  • 👍 47
  • 🔥 18
  • ❤ 11
  • 🤡 2
  • 🙏 1
Post #502 10.3K
Как я провел лето

Ну все, прилетел, два с половиной месяца в рф пролетели как один день. Документы привел в порядок, кого надо прописал, кому надо сделал паспорт, оформил гражданство мелкому. В процессе оформление многодетства, но это уже можно закончить онлайн. Выступил на 6 конфах, провел пару мастерклассов и один двухдневный воркшоп, даже был фасилитатором на одном мероприятии, где разбирался вопрос внедрения ии в бигтехах. Развиртуализировался с кучей ребят включая моих читателей и познакомился с еще большим числом новых интересных людей.

Так как прилетел с сыном, то его надо было постоянно где-то оставлять. Поэтому он у меня проводил все время в дневных лагерях. Начиная от батутов и роликов до плавания. Подтянул язык, офигел от тополей, метро и количества разного рода насекомых. У нас такого нет как будто (в майами комары почти отсутствуют например).

На всех мероприятиях были кальяны, плюс народ любит встречаться в таких местах. Я так то не курю, но накальянился на всю оставшуюся жизнь. В целом так встречи проходят интереснее 🙂

Наконец-то вхожу в нормальный ритм, со следующей недели уже пойдут регулярные выпуски и посты. Хочу попробовать немного заработать и со временем включу интеграции и немного рекламных постов. Обещаю что спамить не буду, но мне интересно посмотреть на то, как быть по ту сторону экрана. Как рекламодатель я работаю уже давно (от лица Хекслета), а вот как блогер только учусь.

Значит что я заметил. Платить и проходить в метро по лицу, это конечно мощь, прямо сильная штука, я даже когда вернулся, почувствовал что уже привык и не хватает. Из негативного, цены выросли сильнее чем выросли в штатах. Местами так дорого, что аж жуть. С другой стороны, Москва и Питер как всегда красиво и масштабно. В сокольниках забахали такой парк, мама мия. Чтобы вы понимали, в штатах нет таких парков (как и культуры парков в нашем понимании).

В целом было ощущение, что очень улучшилась логистика. Как будто лучше распределяются потоки + сильно выросла транспортная сеть. Я ни разу не торчал в жутких столпотворениях, как это было лет 15 назад на выхино (кто помнит тот знает). Взять те же кассы в метро, которые тупо закрыты.

Да, китайских машин в штатах нет, их сюда не пускают. Я пару лет назад в Казахстане видел все это, но до сих пор не сильно разбираюсь в моделях и названиях, хотя покатался почти на всем что было. Уровень машин впечатляет. Кстати моей тачки вообще в рф нет как будто, да и люди не знают про существование lexus tx (трехрядный), так как он появился в 2024 году. Примерно считали, что в штатах в три раза дешевле + лизинг. Так что если кто-то едет на x5 в штатах и в рф это сильно разные ценовые категории и уровень дохода.

Пару раз летал в питер победой. Чот я столько слышал негатива, а оказалось очень кайфово. Я еще купил спец рюкзак для вещей и ноутбука и летел на легке (первый раз в жизни). Офигел от кайфа, когда просто берешь рюкзак и идешь куда хочешь не ожидая чемоданов и колясок с самокатами. Вообще все мои путешествия в жизни, это дети, поэтому я испытал много новых ощущений 🙂

И еще, стало реально заметно потепление. В Ульяновске тусил на даче, а там тебе и цикады и геконы (!!!). Даже дожди становятся тропическими. Вроде есть кондиционеры, но до штатовского +16 в помещении еще далеко 🙂 Все боятся что их продует.

За это время ни разу не купался. После чистого океана, любой пресный водоем кажется живым. Тупо страшно туда заходить. Сын постоянно спрашивал про аллигаторов, настолько привык что в обычные водоемы соваться нельзя. Аллигаторов то нет, но комары по страшнее будут.

Ну и любимый вопрос, как граница? Единственное место где мне задали пару вопросов, это в аэропорту майами по прилету. Кстати, вы знаете что у меня есть личная инста (для orgprog тоже есть)? Единственное место где не про работу, а про жизнь https://www.instagram.com/mokevnin

Telegram | YouTube | AI Клуб
  • ❤ 133
  • 👍 61
  • 🔥 23
  • 🤮 6
  • 🤡 4
  • 💩 1
Post #501 10.5K
Программирование с явно выделенным состоянием

Одна из моих любимых тем, про которую не устаю говорить. В модели данных часто бывает ситуация, когда состояние выражено не прямым образом, а косвенно. Буквально вчера я реализовывал кастомные тарифы под конкретных пользователей. Отличие такого тарифа от обычного сводится к тому, заполнено ли поле user_id в тарифе или нет. Если не заполнено, то значит это общий тариф, если заполнено, значит под конкретного пользователя и другие его не могут видеть.

Это вполне рабочая схема и она встречается повсеместно, особенно в связке с датами типа deleted_at, но она обладает одним очень важным недостатком. Понимание того, что эта запись находится в особом состояние вычисляется через косвенный признак или, что хуже, через набор признаков. Об этом надо думать и каждый раз вспоминать и выуживать эту информацию.

Сейчас, в эру агентного программирования, это стало еще важнее. Агент может догадаться до правила, но ему нужно на это время и отдельный анализ. Можно конечно написать об этом в правилах, но зачем, когда можно просто поправить модель данных? Все что требуется, это введение текстового поля со статусом, которое явным образом скажет о происходящем с этой записью.

В общем не полагайтесь на то как заполнены поля, вводите нужные статусы, которые явно будут говорить о том что происходит. Заодно это дает более удобную аналитику и выборки

Telegram | YouTube | AI Клуб
Telegram Хекслет Программы обучения - https://ru.hexlet.io/courses Сообщество @hexletcommunity AI Клуб @hexletclub Поддержка @hexlet_help_bot
  • 👍 63
  • ❤ 18
  • 🔥 6
  • 💯 3
  • ⚡ 1
  • 👎 1
  • 🤔 1
  • 👨‍💻 1
  • 👀 1
Post #500 9.93K
Новый выпуск подкаста про Agile, Scrum и ИИ трансформацию уже доступен https://youtu.be/FhthTCoR3uw?is=X5GCG6XrrFds65ws В этот раз с Асхатом Уразбаевым мы вспоминаем как это было и куда пришло. Взлеты и падения, культы карго и трансформации в компаниях. А что в конце? Дейли не нужен, вот такие пироги

Telegram | Аудио | vk
YouTube Асхат Уразбаев о взлёте и падении Agile: почему Scrum изменил индустрию и что происходит сейчас #89 🔹 Присоединяйся к курсу «ИИ для разработчиков» https://ru.hexlet.io/programs/ai-for-developers?utm_source=youtube В этом выпуске мы поговорили с Асхатом Уразбаевым — одним из самых известных Agile-консультантов в России, основателем ScrumTrek и человеком…
  • 🔥 26
  • 👍 14
  • ❤ 6
  • 🤷‍♂ 1
  • 🤔 1
  • 👀 1
Post #499 12.1K
Можно разок похохмить? :)
  • 😁 170
  • 🔥 19
  • 🤣 13
  • 👍 7
  • ❤ 6
  • 🌚 4
  • 😱 1
  • 👀 1
Post #498 11.6K
Иммутабельная денормализация

Изучение баз данных всегда сопровождается понятием нормализации, а конкретно первыми тремя формами, которые задают нам ограничения, помогающие правильно разложить все по таблицам. И это действительно база, без которой нормально работать не получится. Но есть, как обычно, нюансы.

В реальных проектах выясняется, что нормализованные данные сложно соединять и выбирать. При глубоком уровне зависимостей, чтобы добраться до внешней сущности, нужно либо соединять 5 таблиц, либо делать 5 запросов. Пример из Хекслета. У нас есть программа обучения, которая состоит из модулей, в которые входят темы которые состоят из уроков, которые состоят из юнитов (теория, практика, тесты). На это все накручено много логики по прогрессу и отображению. В такой структуре, вопросы типа "какой урок следующий по порядку?" заставляют поломать голову.

В таких ситуациях мы начинаем денормализацию данных. В основном она сводится к добавлению внешних ключей на косвенно связанные сущности, например, урок связан с программой обучения через модуль. Здесь мы добавляем ключ на программу прямо из урока, что позволяет выполнять запросы на уроки одной программы без необходимости соединять таблицы.

В принципе это довольно базовая концепция с которой знакомы большинство разработчиков, но дальше начинается самое интересное. Как только мы делаем денормализацию, то сразу упираемся в необходимость синхронизировать данные. Если поменялось в одном месте, надо не забыть поменять и в другом месте. Это цена денормализации и ее надо платить.

> Кстати есть такой концепт как синхронизирующие триггеры, которые вешают только для того, чтобы синхронизировать подобные данные. Когда-то я его активно использовал, но сейчас не стал бы

Но есть и альтернативный подход, который иногда работает лучше. Вместо того, чтобы синхронизировать денормализованные данные, мы можем пересмотреть саму систему и сделать данные иммутабельными (неизменяемыми), чтобы их не нужно было синхронизировать. Например в том же примере с уроками, мы сделали так, что урок принадлежит одной программе и не может перемещаться между программами. А это значит, что мы можем записать в урок все внешние ключи, которые никогда не поменяются. В таком случае цена денормализации это занятое место ключами, чем обычно можно пренебречь.

А что касается бизнес-логики? Да, такой подход работает не всегда, но, как показала практика, его можно использовать намного чаще чем кажется. Например в нашем случае это даже наоборот хорошо, иначе получается ситуация, что при переносе урока нужно переносить прогресс, что значительно усложняет логику и создает странное впечатление, когда в середине программы вдруг появляются пройденные уроки. При этом сама процедура довольно редкая, поэтому если кому-то придется пройти два раза один и тот же урок (перенос в нашем случае это копирование), то ничего страшного не случается.

Но есть места где без синхронизации данных не обойтись никак. В основном это касается статусов, они могут меняться и за ними нужно следить.

p.s. Вы денормализуете данные? Для каких задач?

Telegram | YouTube | AI Клуб
Telegram Хекслет Программы обучения - https://ru.hexlet.io/courses Сообщество @hexletcommunity AI Клуб @hexletclub Поддержка @hexlet_help_bot
  • 👍 37
  • ❤ 16
  • 😐 5
  • 🔥 3
  • 👏 1
  • 🤪 1
Older posts →

About this channel

How can I read @orgprog without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Организованное программирование | Кирилл Мокевнин: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Организованное программирование | Кирилл Мокевнин have?
Организованное программирование | Кирилл Мокевнин (@orgprog) has 14.2K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Организованное программирование | Кирилл Мокевнин know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →