TGViewer
Channel Public Channel
Data Science by ODS.ai 🦜

Data Science by ODS.ai 🦜

@opendatascience

First Telegram Data Science channel. Covering all technical and popular staff about anything related to Data Science: AI, Big Data, Machine Learning, Statistics, general Math and the applications of former. To reach editors contact: @malev
Subscribers
38.4K
Photos
1.3K
Videos
152
Links
2.3K

Showing posts older than #3223 · Back to latest

Older Posts 15 shown
Post #3222 2.56K

Forwarded from Анализ данных (Data analysis)

⚡️ OpenMythos: открытая реконструкция Claude Mythos на PyTorch

Это теоретическую сборка архитектуры Claude Mythos по первым принципам и публичной литературе. Это не веса от Anthropic, а попытка сообщества воспроизвести саму идею.

В основе лежит Recurrent-Depth Transformer: один и тот же параметризованный блок с общими весами прогоняется T раз внутри одного forward pass, так что глубина достигается не новыми слоями, а итерациями. Поверх этого накручен sparse MoE с top-K роутингом, дающий условные вычисления на каждом шаге.

В отличие от классического chain-of-thought, reasoning идёт целиком в непрерывном латентном пространстве, без генерации промежуточных токенов между шагами.

Гипотеза автора: рекурсивный блок плюс разреженные эксперты дают лучший компромисс качество/стоимость инференса и потенциально эмерджентный многошаговый reasoning без раздувания модели.

Схема: Prelude из плотных блоков, зацикленный Shared block с loop-index эмбеддингами и LoRA-адаптерами по глубине, MoE-роутинг, ACT-халтинг для раннего выхода, на выходе RMSNorm и tied LM head.

Полезно тем, кто копает recurrent-depth модели, латентное reasoning и эффективные MoE. Поиграться с архитектурой можно, не дожидаясь релиза весов.

https://github.com/kyegomez/OpenMythos

🎯Полезные Мл-ресурсы 🚀 Max

@data_analysis_ml
  • 👍 9
  • 🔥 3
  • ❤ 1
Post #3219 2.73K

Forwarded from Machinelearning

⚡️ Qwen3.6-35B-A3B - ставка на эффективную архитектуру, а не на размер

35B параметров, ~3B активных за счёт MoE.

Главное:

- по agentic coding показывает уровень моделей с ~10x большим активным объёмом
- превосходит Qwen3.5-27B (dense) и предыдущую Qwen3.5-35B-A3B
- нативно мультимодальная архитектура (text + vision)
- в VLM-бенчмарках сопоставима с Claude Sonnet 4.5, в ряде задач выше
- сильные метрики в задачах spatial reasoning

MMMU - 81.7 vs 79.6 MMMU-Pro - 75.3 vs 68.4 MathVista - 86.4 vs 79.8 RealWorldQA - 85.3 vs 70.3.

Практическое значение:

- MoE даёт кратное снижение compute без потери качества
- подходит для агентных сценариев, где важны последовательные действия и планирование
- можно использовать как единый стек для code + vision задач

Apache 2.0 - без ограничений для продакшена

qwen.ai/blog?id=qwen3.6-35b-a3b
chat.qwen.ai
huggingface.co/Qwen/Qwen3.6-35B-A3B
modelscope.cn/models/Qwen/Qwen3.6-35B-A3B

@ai_machinelearning_big_data
  • ❤ 7
  • 👍 3
Post #3217 2.72K

Forwarded from Анализ данных (Data analysis)

⚡️ В Telegram завезли агентов, которые создают других ботов

Павел Дуров сообщил, что теперь в Telegram можно развернуть бота-агента буквально в пару кликов

Агент может сам создавать новых ботов и управлять ими от вашего имени

Похоже, фича не случайная, её явно готовили под экосистему вроде OpenClaw

Ранее разработчик OpenClaw говорил, что с ним связалась команда Telegram и предложила помощь с интеграцией

Если это так, Telegram превращается не просто в мессенджер
а в платформу для запуска AI-агентов с доступом к миллионам пользователей

https://t.me/durov/490

🎯Полезные Мл-ресурсы 🚀 Max

@data_analysis_ml
  • 👍 14
  • ❤ 4
  • 🤬 1
Post #3216 2.43K

Forwarded from База знаний AI

В «Газпром нефти» разработали ИИ-агента для проектирования вариантов расстановки нефтяных скважин

В основе ИИ-агента — метод обучения с подкреплением. Он сам ищет оптимальную стратегию, анализирует ошибки и находит неочевидные инженерные решения. Для обучения использовались терабайты данных гидродинамических симуляций, полученных на реальных скважинах.

ИИ-агент обрабатывает миллионы параметров, в том числе геологические особенности месторождений, технические возможности бурения и экономику проекта. Он определяет количество и тип конструкций скважин и предлагает несколько вариантов моделирования.

Инструмент проектирует до 1 тыс. вариантов расстановки нефтяных скважин за час и ускоряет моделирование бурения в пять раз. Решение протестировали на трех нефтепромыслах в Ханты-Мансийском и Ямало-Ненецком автономных округах. Утверждается, что предложенные нейросетью варианты бурения оказались эффективнее и точнее стандартных проектов.

🔗 Источник: https://tass.ru/ekonomika/27100297

***
📎 Группа ученых с участием МФТИ, НИУ ВШЭ и Института искусственного интеллекта AIRI в апреле 2026 года представила ML-систему для предсказания межфазного натяжения между нефтью и соленой водой. Решение предназначено для моделирования нефтяных пластов без дорогостоящих экспериментов.

---
Подпишитесь на Email-рассылки ICT.Moscow по общей ИТ-повестке, искусственному интеллекту и аналитике, чтобы всегда оставаться на связи.
  • 🤡 12
  • ❤ 3
  • 👍 2
Post #3214 2.22K

Forwarded from Python/ django

🚀 GigaChat 3.1 Ultra и GigaChat 3.1 Lightning в опенсорс под MIT лицензией!

Обе модели
• Обучены с нуля — без инициализации зарубежными весами
• MoE + MTP + MLA
• Совместимы с HuggingFace, llama.cpp / vLLM / SGLang

Код и веса уже на платформе GitVerse.

Это не просто релиз весов, а результат большой инженерной работы над качеством, alignment и стабильностью модели. В блоге команда поделилась результатами и своими наработками.
В релизе: высокие результаты на аренах, улучшенный function calling, решённая проблема циклов, DPO в нативном FP8, найденный и зарепорченный баг в SGLang при dp > 1.
  • 🔥 8
  • 🙈 7
  • 👍 4
  • 🤡 3
  • 😁 1
  • 🙏 1
  • 🙉 1
  • 🙊 1
Post #3213 2.03K

Forwarded from AI VK Hub

⚙️ LLM меняют стратегию: что происходит внутри модели во время обучения

LLM сегодня — уже де-факто стандарт, но ключевой вопрос остаётся открытым: как именно они учатся решать задачи?

Особенно это касается in-context learning (ICL) — способности обучаться «на лету» во время инференса. Работа с ICML 2025 предлагает неожиданный поворот: возможно, ICL — это не фундаментальное свойство, а лишь временный режим работы модели.

➡️ Что происходит внутри LLM

Авторы статьи изучают поведение модели по ее поведению в специально подобранных тестах. Это позволяет разделить, на что опирается модель: на контекст или на знания, зашитые в весах. В результате экспериментов было показано, что внутри модели сосуществуют несколько стратегий обучения.

Помимо ICL появляется гибридный режим — context-constrained in-weights learning (CIWL), где модель использует веса, но с учётом ограничений из контекста.

При этом:
🟣ICL возникает на ранних этапах и даёт быстрый буст;
🟣затем постепенно «затухает»;
🟣и уступает место CIWL.

➡️ Как это измерили

Эксперименты сделаны максимально «чисто»:
🟣небольшой transformer (2 слоя, attention-only);
🟣синтетическая few-shot задача (Omniglot).

Ключевой инструмент — набор behavioral evaluators, которые «ломают» разные источники сигналов:
🟣ICL evaluator → рушит выученные соответствия;
🟣IWL evaluator → убирает нужный пример из контекста;
🟣CIWL evaluator → сохраняет метку, но ломает связь с примером;
🟣Flip evaluator → создаёт конфликт «контекст vs веса».

Именно Flip evaluator — центральный: он показывает, какой сигнал выбирает модель при конфликте. Через него авторы восстанавливают динамику стратегий во время обучения.

➡️ Почему это важно

Работа показывает нетривиальную механику обучения трансформерных моделей: поведение трансформеров — это не одна способность, а динамика стратегий, которые меняются по ходу обучения. И, возможно, ICL — это не фундамент модели, а лишь побочный эффект этой динамики.

А что думаете вы?
Замечали ли вы, что модель «переключает режим» — между использованием контекста и знаниями из весов?👇

Обзор статьи подготовлен командой AI VK
#обзорстатьи
  • ❤ 2
  • 👍 2
Post #3212 2.07K

Forwarded from Анализ данных (Data analysis)

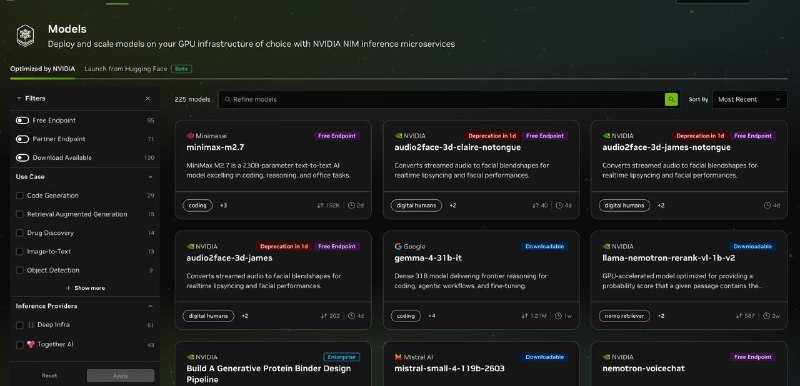
⚡️ NVIDIA раздает жирнейший набор API - почти сотка нейросетей бесплатно

Без лишнего шума: открыли доступ к 95+ моделям сразу. Внутри всё, что сейчас в топе - DeepSeek, Kimi, Mistral, Qwen, Flux, Whisper, GLM и ещё пачка инструментов под любые задачи.

Можно собирать свои продукты без вложений: озвучка, чат-боты, липсинк, генерация видео, дизайн. Всё через API, без костылей и с нормальным качеством.

Самое интересное - выкатили доступ к своим моделям. Обязательно попробуй Nemotron: отлично режет шум и вытягивает звук даже с плохого микрофона.
Забирай, пока не прикрыли.

https://build.nvidia.com/models

#NVIDIA

🎯Полезные Мл-ресурсы 🚀 Max

@data_analysis_ml
  • ❤ 6
  • 👍 3
Post #3211 2.17K

Forwarded from Китай.AI

🔥 Huawei раскрывает амбициозный трёхлетний план: три поколения Ascend за три года

Несмотря на жёсткие санкции США, Huawei не просто выживает в сфере ИИ-чипов, а уверенно строит собственную империю вычислительной мощности. На конференции Huawei Connect в 2025 году компания официально представила дорожную карту развития Ascend на ближайшие три года.

Что ждёт рынок:

• Ascend 950 (2026 год) — ближайшее поколение
Включает две версии:
- 950PR (уже в производстве): оптимизирован для prefill-этапа инференса и рекомендательных систем. Выдаёт до 1,56 петафлопс в FP4 и в два раза мощнее китайской версии Nvidia H20.
- 950DT (Q4 2026): фокус на decode-этапе инференса и обучении моделей. Использует собственную HBM-память HiZQ 2.0 (до 144 ГБ), пропускную способность памяти 4 ТБ/с и интерконнект 2 ТБ/с.

• Ascend 960 (2027 год)
Удваивает вычислительную мощность, пропускную способность памяти, объём памяти и количество портов интерконнекта по сравнению с 950-й серией. Значительно повысит производительность как в обучении, так и в инференсе. Поддерживает HiF4 - более точный 4-битный формат.

• Ascend 970 (Q4 2028)
Ещё одно удвоение: в два раза больше производительности в FP4 и FP8, удвоенная пропускная способность интерконнекта и рост скорости доступа к памяти минимум в 1,5 раза.

Это уже не просто «замена Nvidia». Huawei переходит от использования базовых компонентов к полноценному доминированию в ключевых характеристиках: вычислительная мощность, память, интерконнект и энергоэффективность. Каждый новый чип становится заметно сильнее предыдущего, а экосистема Atlas и поддержка CUDA делают переход для китайских компаний всё более привлекательным.

Похоже, 2026–2028 годы станут настоящим прорывом для китайского ИИ-железа. Huawei планомерно закрывает отставание и создаёт независимую технологическую базу.

Оригинальная статья

#КитайскийИИ #Huawei #Ascend
Huawei Central Huawei AI Chip: Three years, Three major AI chip development Huawei has undergone major development in the AI chip industry for the past two years, using its Ascend family. But the company is now aiming for big wins! In the next three years, the Chinese OEM targets a dynamic AI semiconductor empire. Unlike big tech…
  • 👍 4
  • 🔥 2
  • 🤡 1
Post #3210 2.05K

Forwarded from ODS Events

Привет!

Встречайте четырнадцатый выпуск подкаста "Капитанский мостик". Ведущие подкаста Валентин Малых и Дмитрий Колодезев обсуждают последние новости в области технологий, включая конфликты между крупными компаниями, изменения в политике открытости моделей и влияние геополитики на развитие технологий.
Смотрите видео на каналах ⤵️
ODS VK Video
ODS YouTube

📩 Присылайте новости для обсуждения в канал "Дата-капитаны" в mattermost (авторизуйтесь через ODS.ai).
  • ❤ 2
Post #3208 1.98K

Forwarded from Python/ django

🔥 Linux 7.0 - Торвальд и команда вычистили десятилетия грязного легаси и ОС стала реально быстрее!

Линус Торвальдс наконец пошёл на радикальный шаг и начал массовую зачистку старого кода. То, что копилось годами, просто выкинули. Итог - система стала заметно проще, чище и быстрее.

Что изменилось по факту:

XFS сильно прокачали - файловая система стала надёжнее, меньше рисков потери данных и лучше ведёт себя под нагрузкой

Работа с памятью ускорилась примерно на 20%, плюс подтянули сетевой стек - соединения стабильнее при высоких нагрузках

Контейнеры теперь стартуют быстрее за счёт улучшений в open_tree - меньше оверхеда при разворачивании

В Kconfig наконец дали больше свободы кастомизации - можно заменить Tux на свой логотип

Поддержка железа тоже прокачана - AMD и Intel работают эффективнее без ручных оптимизаций

Главное здесь не список фич, а тренд. Ядро постепенно избавляется от исторического балласта и становится более предсказуемым и удобным для современных нагрузок.

https://github.com/torvalds/linux/releases/tag/v7.0

🐍 Python полезные ресурсы 🚀Max

@pythonl
  • 🔥 19
  • ❤ 4
  • 👍 4
  • 🤡 1
Post #3202 2.22K

Forwarded from Machinelearning

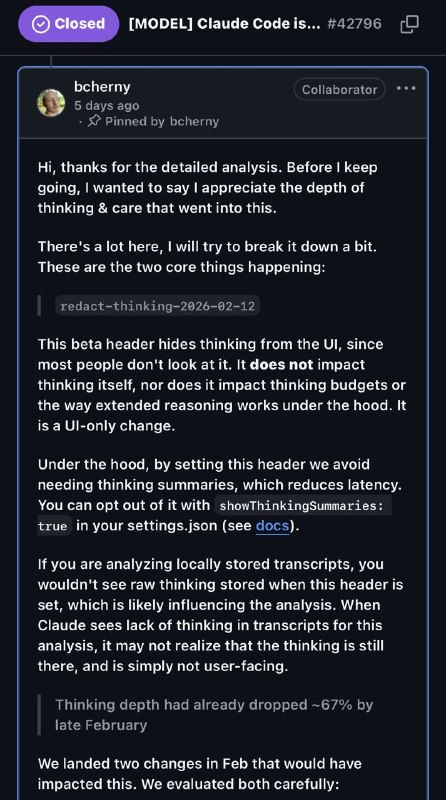
🚨 Claude «деградировал» и это видно по логам.

Senior AI Director из AMD разобрала сессии Claude за январь-март и картина получилась неприятная.

Модель стала думать меньше. Медианная длина reasoning упала примерно с 2200 до 600 символов. Это сразу бьёт по качеству решений.

Параллельно выросло количество API-запросов - почти в 80 раз с февраля на март. Меньше анализа, больше попыток, больше ретраев и сжигания токенов.

Поведение тоже поменялось. Модель чаще «сдаётся» или начинает спрашивать, продолжать ли дальше. За 17 дней таких кейсов было 173, до 8 марта - ноль.

Ещё одна неприятность падение reads-per-edit (reads-per-edit = сколько файлов / участков кода модель посмотрела перед правкой). Было 6.6, стало 2.0. То есть Claude теперь хуже изучает код перед изменениями.

Плюс выросло количество противоречий. Модель чаще переобувается по ходу ответа.

Пользователи замечают, что Клод начинает игнорировать такие вещи, как CLAUDE.md. Просто не хватает «бюджета мышления», чтобы учитывать контекст.

Что интресно, наблюдается зависимость от времени суток. Худшие результаты в 5–7 вечера по PST, ночью качество заметно выше. Похоже, это напрямую связано с загрузкой GPU.

Claude всё ещё мощный, но его поведение стало менее стабильным и сильно зависит от нагрузки

Замечали ли вы, что Claude стал тупее в последнее время ?🤯


Директор по AI в AMD проанализировала 6 852 сессии Claude Code и показала, что модель сильно ухудшили.

234 760 вызовов инструментов, 17 871 блоков размышлений, 3 месяца логов.

После этого Anthropic ответили и фактически подтвердили её выводы.

Пожалуй, самый чистый и показательный аудит AI за 2026 год 👇

https://github.com/anthropics/claude-code/issues/42796#issuecomment-4194007103

@ai_machinelearning_big_data

#news #ai #ml #claude
  • 👍 10
  • ❤ 4
  • 💯 3
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →