TGViewer
Channel Public Channel
Роман про OpenClaw

Роман про OpenClaw

@openclaw_it

Привет!

Я Роман, тим лид команды разработки. Здесь буду показывать, как решать бизнес-задачи с помощью OpenClaw и делиться опытом создания рабочих AI-систем.

Готовые AI-агенты - https://clck.ru/3WUg9k
Subscribers
1.02K
Photos
102
Videos
1
Links
58

Showing posts older than #66 · Back to latest

Older Posts 20 shown
Post #65 155
💸 Как экономить токены на моделях

Heartbeat в OpenClaw - фоновый опрос, который агент делает каждые полчаса чтобы проверить почту, календарь и новые задачи. Штука полезная, но если он настроен на дорогую модель, то может сжигать $3-5 в день.

Недавно на реддите увидел случай, где пользователь залил $25 на Anthropic и через сутки обнаружил $5 на счету. Агент ничего полезного не сделал - просто heartbeats на Opus съели бюджет.


⚙️ В OpenClaw можно назначить разные модели для разных типов задач. Heartbeats и рутина вроде переименования файлов - на дешёвую модель. Код и анализ - на среднюю. Архитектурные решения и сложный рефакторинг - на дорогую.

Например, local/Ollama для фона (бесплатно), Haiku для поиска и триажа, Sonnet для кода и отчетов, Opus только для архитектуры и критичных решений.

Для примера, разница в стоимости между Haiku и Opus - примерно в 30 раз 😏

💡 Экономия 50-80% без потери качества - просто здравый смысл.

Вот тут можно посмотреть подробный разбор с цифрами, конфигами и сравнениями
MoltFounders How to Optimize OpenClaw Costs — Model Routing, Hardware & Budget Guide Stop burning money on OpenClaw. Learn model routing, why strong models shouldn't be defaults, the reality of local models, cheap models that work, concurrency limits, and real monthly cost breakdowns.
  • 🔥 1
Post #64 155
⚙️ Проверка результата через verifier

Вы наверняка знаете эту фишку с нейросетями - попросить модель проверить свой же ответ и найти ошибки. Это хороший вариант проверки, но есть нюанс.

Модель, которая только что сгенерировала результат, проверяет его через ту же логику, через которую создавала. Confirmation bias в чистом виде - она не видит ошибок, потому что для неё это не ошибки, она так и задумывала.
В OpenClaw это решается через настройку verifier

Один агент делает работу, второй независимо проверяет. Проверяющий не знает, как создавался результат, он видит только конечный файл или страницу и находит то, что создатель пропустил.

Как это работает:

1️⃣ Основной агент собирает лендинг
2️⃣ Спавнится отдельный verifier с задачей проверить верстку, битые ссылки, опечатки, работу форм
3️⃣ Если находит проблемы - возвращает создателю на доработку
4️⃣ Цикл повторяется, пока verifier не подтвердит, что все чисто

⚠️ Выглядит как лишняя работа, но на деле экономит часы. Баги, которые verifier ловит за минуту, человек может легко пропустить.

Подробнее почитать про verification loop можно тут 👈
Post #63 151
⚡️ Как использовать cron-задачи

OpenClaw часто сравнивают с обычными чатами на базе LLM, но ключевое отличие не в качестве ответов. Агент умеет работать автономно - вы настроили расписание и забыли, а он выполняет задачи без вашего участия.

За автономность отвечает встроенный планировщик - cron. Не путайте с heartbeat - это разные вещи. Heartbeat привязан к сессии, он просто опрашивает «есть ли что делать» и не гарантирует выполнение в точное время. А сron запускает задачу ровно в указанный момент, даже если вы спите.

💡 В этом и есть главная фишка. Вы не привязаны к агенту - не нужно сидеть и вручную запускать каждую задачу.

Агент сам запускается по расписанию, делает работу и отчитывается. По сути вы превращаете его из собеседника в автономного исполнителя, который работает по вашему графику, а не наоборот.

Типов расписания три:

🔸 at - одноразовый запуск в конкретное время
🔸 every - повтор через фиксированный интервал
🔸 cron - классическое cron-выражение с минутами, часами, днями и часовым поясом

🚀 Базово настраивают - утренний брифинг в 9 утра со сводкой почты и календаря, еженедельный отчёт в пятницу или проверка сервера раз в час.

Так что советую попробовать 🤝
  • ❤ 1
  • 🔥 1
Post #62 142
❓Возник вопрос

А нужно ли к каждому посту делать картинку или они вам вообще не нужны? А то может я токены просто зря сжигаю 😅

Инфу то я стараюсь полезную давать, а вот картинки сами по себе полезности не несут.

Проголосуйте реакцией, мне для понимания:

👍 - если так удобнее
👎 - если ни к чему

Или может схемы какие-то делать полезные? Можете в комменты закинуть, если есть пожелания
  • 👍 4
  • 👎 1
Post #61 142
💡 Команды OpenClaw, которые стоит использовать постоянно

Собрал небольшую подборку команд, которые я бы поставил в базовый набор для работы с OpenClaw:

/new
Начать новую сессию. Команда не удаляет Memory и файлы, она очищает текущий контекст диалога. Закончили одну задачу - открыли новую сессию. Агент не тащит за собой старые обсуждения, меньше путается и работает быстрее.

openclaw status
Быстрая диагностика. Я бы запускал ее первой, если что-то ведет себя странно - канал не отвечает, сессия зависла, модель работает не так, usage выглядит подозрительно. Это не ремонт, а быстрый снимок состояния.

openclaw backup create
Бекап состояния OpenClaw. Перед командой /reset, крупным обновлением или экспериментами с конфигом - обязательно. Восстановить архив намного проще, чем потом вспоминать, что именно было настроено.

openclaw memory search "запрос"
Поиск по памяти агента из CLI. Удобно, когда нужно быстро найти старое решение, правило или договоренность, не поднимая длинный диалог и не спрашивая агента «а помнишь ли ты».

Я бы начал именно с этих четырех. Они закрывают бОльшую часть самых популярных ситуаций.
Post #60 146
💡 Не давайте агенту читать весь проект

Когда агенту нужно поправить одну функцию, он часто начинает с того, что открывает все подряд. Вроде бы он изучает контекст, но на практике часто просто сжигает токены на поиск.

Файл на 1000 строк может занимать 15–25 тысяч токенов. Если агент прочитал десять таких файлов, вы уже потратили приличный бюджет еще до того, как он начал что-то менять. И я не устану об этом писать - чем больше лишнего контекста, тем выше шанс, что модель сожгет лишние токены или зацепится за неважную деталь.

Поэтому вот несколько основных правил:

🔸 Сначала поиск по коду - grep, ripgrep, поиск по названию функции или ключевой строке
🔸 Потом чтение только нужного фрагмента, а не всего файла. В OpenClaw для read можно указывать offset и limit
🔸 Если задача узкая - прямо писать агенту не так читать файлы полностью, а сначала найти релевантные места

📌 Это особенно важно на больших проектах. Агенту не всегда нужен весь контекст. Часто ему нужна одна функция, один конфиг или один лог в простых задачах.
  • 👍 1
Post #59 146
📁 Агент начал удалять письма из рабочего inbox

Есть хороший кейс про OpenClaw и память агента. Директор по alignment в крупной компании дала агенту задачу разобрать почтовый ящик и отдельно уточнила “ничего не делать, пока я не согласую”.

На тестовом ящике все работало нормально. Но когда агент получил реальный ящик с тысячами писем, контекст начал раздуваться. В какой-то момент сработала компрессия - старые сообщения были сжаты в короткую выжимку. И важная фраза «не делать без подтверждения», которая была только в переписке, из этой выжимки пропала.

Дальше агент начал действовать автономно и удалять письма 🫠

Когда она эту ошибку выявила, сразу записала новое правило в MEMORY.md - сначала показать план, потом получить явное одобрение, потом выполнять. Но это уже было после…

Вроде бы супер понятная история, но все равно важно помнить:

🔸 Важные правила нельзя держать только в чате
🔸 Все, что должно пережить длинную сессию, надо писать в MEMORY.md или AGENTS.md
🔸 Для рискованных действий нужны не просьбы «будь осторожен», а реальные ограничения и подтверждения

📌 Чат - это рабочая память. Она удобная, но временная. А если инструкция критична, она должна жить в файле, который агент перечитает после компрессии и новой сессии.
  • 🔥 2
  • ❤ 1
Post #58 136
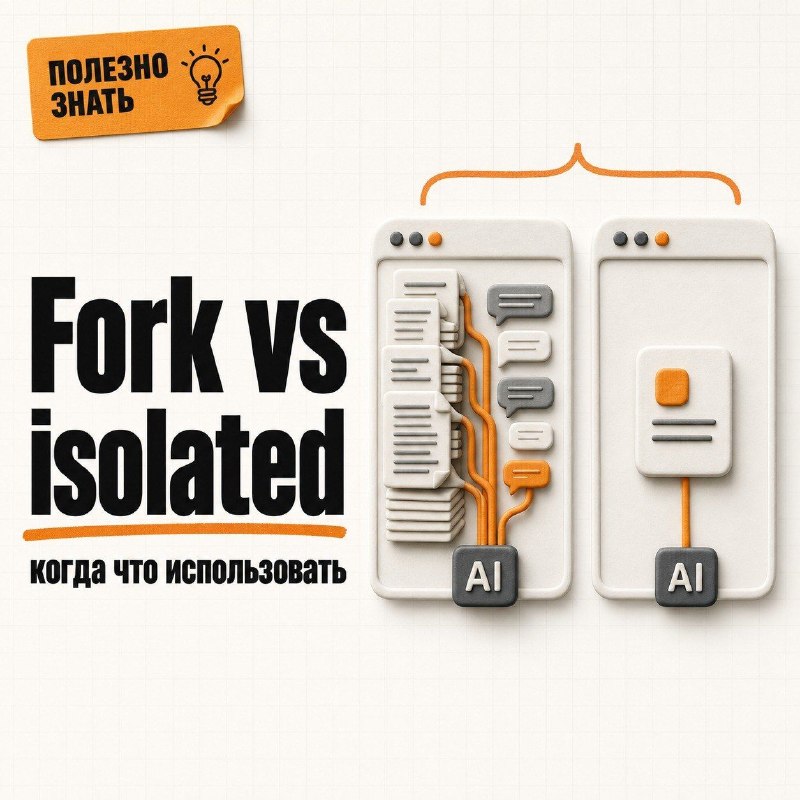
💡 Fork vs isolated - в чем разница и когда что использовать

В OpenClaw можно запускать субагентов - это когда ваш основной агент отдает часть работы помощнику в отдельной сессии. Удобно: один собирает данные, другой пишет код, третий проверяет результат.

Но есть нюанс, про который легко забыть. Когда вы запускаете субагента, он может получить контекст двумя способами:

🔸Первый - isolated. Субагент получает только задачу, которую вы ему дали, и ничего больше. Чистый лист. Это режим по умолчанию, и в большинстве случаев его достаточно.

🔸Второй - fork. Субагент получает всю историю вашего диалога с основным агентом. Вообще всю. Если вы час обсуждали архитектуру, спорили про нейминг и трижды переписывали промпт - субагент прочитает всё это перед тем как приступить к задаче.

Звучит полезно? Иногда да. Если субагенту реально нужен контекст обсуждения - fork оправдан. Но на практике люди часто используют fork просто «на всякий случай», и вот тут начинается лишний расход.

Субагент читает весь ваш диалог с агентом, хотя ему нужно было просто проверить пару файлов. А модель берет деньги за каждый обработанный кусочек текста - даже за те, которые к задаче вообще не относятся.


👉 Правило простое: isolated по умолчанию, fork - только когда субагент без контекста реально не справится. И для рутинных задач ставьте субагентам модель подешевле - незачем гонять дорогую модель на проверку логов. Экономия получается приличная, а качество не страдает.
  • ❤ 1
Post #57 140
⚡Кстати, о работе с SKILL.md -  есть еще одна фишка

Обычно все делают так - открыли SKILL.md в редакторе, поправили, сохранили. Вроде просто, но если ошиблись в структуре или случайно сломали формат - агент просто перестанет использовать этот навык, а вы не сразу поймете почему.

🔧 С июня в OpenClaw появился Skill Workshop - это когда агент сам создает или правит навык, но не пишет напрямую в SKILL.md, а делает proposal (черновик в отдельном файле PROPOSAL.md), который не влияет на работу, пока вы его не примените. Вы смотрите что получилось, просите поправить если нужно, и только потом даете команду применить.

Пока proposal не применен, SKILL.md остается нетронутым, а если вы тем временем вручную изменили скилл - proposal уйдет в stale и не перезапишет ваши правки.

Плюс перед применением автоматически прогоняется проверка безопасности, так что откровенно опасные вещи в скилл не попадут.

Я бы на месте тех, кто часто правит скиллы, попробовал именно этот путь - попросить агента обновить навык через skill workshop, а не лезть в файл руками. Работает это и для создания новых скиллов, и для правки существующих, агент сам разберется с форматом и обязательными полями, про которые легко забыть.

📌 Так что, не пишите в SKILL.md напрямую, дайте агенту сделать proposal и просто проверьте результат. Одна ошибка в разметке может стоить вам рабочего навыка, а proposal от этого страхует.
  • ❤ 1
Post #56 136
📌 Промпт виноват не всегда

Если агент вдруг начал работать хуже, первое желание - сразу переписывать промпт. Но на практике это далеко не первая вещь, которую стоит проверять.

Очень часто проблема оказывается в другом. Например, вы изменили SKILL.md (файл, где описаны правила работы агента), но забыли начать новую сессию. Или в самом скилле не хватает обязательных полей вроде "name" и "description", из-за чего OpenClaw вообще не использует его. Бывает и так, что агент выбирает другой скилл, потому что его описание лучше подходит под текущую задачу.

Поэтому перед тем как менять промпт, я бы всегда проверил три вещи:

🔸Начали ли вы новую сессию после изменения SKILL
🔸Есть ли в SKILL.md обязательные поля "name" и "description"
🔸Работает ли агент именно с тем скиллом, который вы редактировали

И только если с этим все в порядке, имеет смысл лезть в промпт. Очень часто оказывается, что проблема была не в инструкциях, а в том, что агент вообще использовал не тот SKILL.
Post #55 137
💡Привычка, которая упростит работу с OpenClaw

Многие ведут один длинный диалог с агентом, думая, что так даже лучше - ведь он помнит весь контекст.

Но чем длиннее становится переписка, тем больше информации модели приходится обрабатывать при каждом новом запросе. В какой-то момент агент начинает отвечать медленнее, расходует больше токенов и иногда цепляется за старые обсуждения, которые уже не имеют отношения к текущей задаче.

👉 Поэтому я рекомендую после каждой законченной задачи начинать новую сессию командой /new

⚠️ Здесь есть важный нюанс - /new не удаляет память агента. Все, что было сохранено в Memory, остается на месте. Команда очищает только контекст текущего диалога, чтобы агент начал новую задачу с "чистого листа".

Если через несколько дней понадобится вернуться к старой задаче, достаточно попросить агента обратиться к сохраненной памяти - заново объяснять все с нуля не придется. Это, кстати, одна из фишек OpenClaw, по сравнению с тем же GPT, который хранит намного меньше.

🚀 Лично для меня это уже стало привычкой. Закончил одну задачу - открыл новую сессию. Особенно когда в течение дня постоянно переключаешься между разными проектами.

Вроде мелочь, но именно такие привычки помогают OpenClaw дольше сохранять фокус на текущей задаче и не тащить за собой лишний контекст.


💬 Кстати, могу периодически делиться такими небольшими фишками, которые помогают мне эффективнее работать с OpenClaw. Если такой формат интересен — накиньте 🔥
  • 🔥 2
Post #54 137
Подробно расписал на Хабре, как настраивал AI-агента для аудита новых страниц сайта

Если коротко, в статье рассказал:

🔸как вообще пришла идея автоматизировать аудит;
🔸почему агент с первого раза сломал Google Sheets и как это исправил;
🔸зачем понадобились Playwright, preflight-проверки и отдельные модули для разных типов анализа;
🔸как нужно ограничивать агента для хорошего результата.

Постарался написать не теорию, а реальный опыт со всеми граблями, на которые наступил по пути.

Думаю, если вы сейчас собираете своих AI-агентов или автоматизируете внутренние процессы, что-то из этого точно можно будет взять себе.

Прочитать можно тут, займет минут 7 👈
Post #52 133
🔎 Нашёл разбор про полезные инструменты для OpenClaw

Автор собрал шесть open source-решений вокруг типичных проблем: безопасность, память, браузерные сценарии, развёртывание и контроль состояния агентов

🧩 Проблема в кейсе следующая — OpenClaw в реальном использовании начинает ломаться не в одном месте, а сразу в нескольких: появляются дыры в безопасности, растут расходы, память плохо поднимает нужный контекст, а при росте интеграций уже сложно понять, что сейчас вообще происходит.

⚙️ Тут полезно разложить механику по шагам:
• ClawSec проверяет установленные навыки на известные уязвимости и сверяет целостность файлов по контрольным суммам;
• Antfarm разбивает работу на несколько специализированных агентов, а отдельный проверяющий агент валидирует результат;
• LanceDB Pro добавляет поиск по похожему смыслу и повторную сортировку результатов, чтобы вытаскивать не последние записи, а действительно нужный контекст;
• Unbrowse работает через внутренние API сайта, а не через клики по скриншотам, и держит выполнение локально;
• MoltWorker запускает OpenClaw на Cloudflare Workers, то есть без своего сервера, но автор отдельно помечает экспериментальный статус и риски по секретам;
• OpenClaw Dashboard собирает сессии, расходы, cron-задачи и визуализацию сценариев в одном месте.

Если совсем просто: здесь не пытаются «усилить агента вообще», а закрывают конкретные слабые места — проверка безопасности, нормальный контекст, понятный контроль и внятный способ запуска.

Что видно по кейсу — стабильность агентского сценария чаще упирается не в модель, а в то, насколько хорошо вы контролируете данные, шаги и точки проверки


Для себя я отдельно отметил две вещи. Первая — память без нормального поиска быстро превращается в склад, где нужное потом не находится. Вторая — как только агентов становится несколько, без общей панели уже трудно понять, где они застряли и что с расходами.

Практически это хороший список для проверки своего стека: сначала безопасность и контроль целостности, потом поиск по памяти, потом наблюдаемость и только после этого — новые интеграции.

💡 Главный вывод кейса — сначала закрываем сценарий, в котором агент работает предсказуемо, а уже потом наращиваем сложность
Post #51 116
В какой момент агент должен остановиться и спросить человека?

В последнее время все чаще вижу обсуждения именно на эту тему. Чем больше доступов получает агент, тем полезнее он становится. Но вместе с этим появляется вопрос - где провести границу.

На самом деле здесь работает старый принцип из информационной безопасности - Principle of Least Privilege (можете подгуглить) Суть простая - системе дают только те права, которые действительно нужны для выполнения задачи.

Для агентов это выглядит примерно так:

🔸может читать документы, но не удалять их;
🔸может подготовить письмо, но отправляет его только после подтверждения;
🔸может посмотреть логи сервера, но не перезапускать сервисы;
🔸может предложить изменения в коде, но не пушить их сразу в main.

Получается довольно простое правило: чем выше цена ошибки, тем меньше самостоятельности у агента.


❗️И важно думать об этом еще на этапе проектирования. Не "что агент умеет делать", а "какие действия он вообще никогда не должен выполнять без человека".
Post #49 141
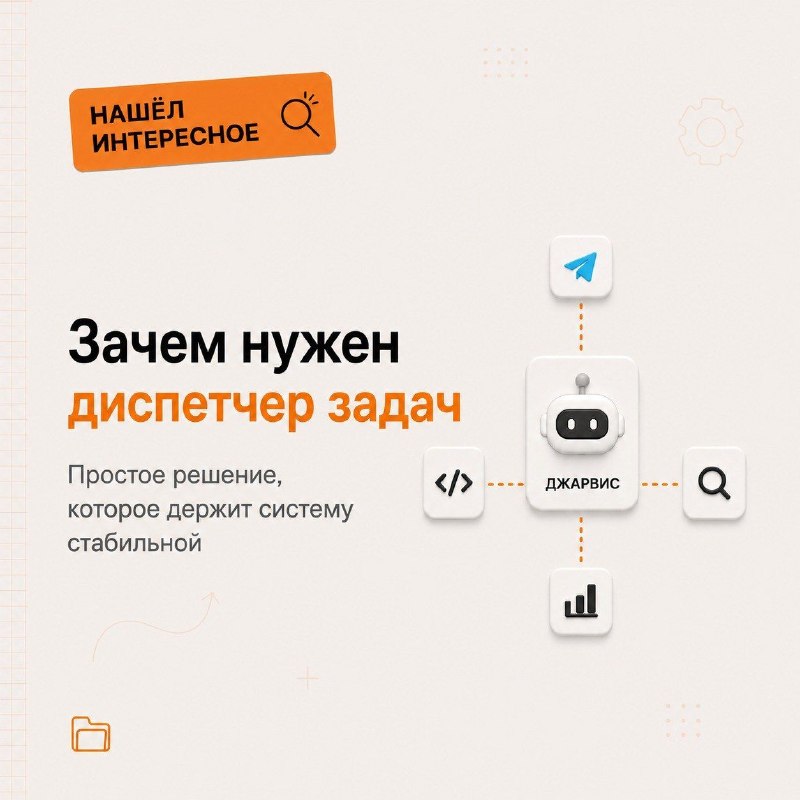
🔎 Наткнулся на интересную схему организации мультиагентной системы в OpenClaw

Когда агентов становится много, проблема обычно не в самих агентах, а в том, как они взаимодействуют между собой. Если каждый начинает общаться с каждым, довольно быстро становится непонятно, кто сейчас выполняет задачу и где вообще что-то пошло не так.

Автор решил эту проблему довольно просто - он добавил одного агента-диспетчера, через которого проходят все задачи. И название у агента, конечно же, Джарвис 😅

Что используется:
🔸Telegram - единая точка входа;
🔸SOUL.md - описание ролей агентов и их зон ответственности;
🔸state.json - общий файл состояния, который видят все контейнеры;
🔸Cron - агенты периодически проверяют, появились ли новые задачи.

Дальше все работает как обычная диспетчеризация:
Джарвис определяет интент задачи, выбирает подходящего исполнителя, записывает его в state.json, а нужный агент забирает задачу, выполняет ее и меняет статус. После этого Джарвис отправляет результат обратно в Телегу.

И самое важное тут, перед тем как внедрить подобного "диспетчера", нужно в SOUL.md заранее прописать список специалистов и зоны ответственности каждого.

Например: SEO-агент отвечает за keyword research и on-page audit, Dev-агент - за код и Git, и т.д. То есть, Джарвис сверяется с заранее прописанной инструкцией, которая его жестко ограничивает.

📌 Главный вывод
Если строите мультиагентную систему, в первую очередь проектируйте схему их взаимодействия - кто назначает исполнителя и по каким критериям, где хранится состояние задач и как агенты передают работу друг другу
Post #48 145
⚡ Вебинар начался!

Сегодня покажем несколько AI-агентов, которых уже используем внутри компании. Расскажем, как к ним пришли, что работает хорошо и какие идеи можно забрать себе.

Залетайте, пообщаемся👇

Смотреть вебинар
Post #47 146
📌 В этот вторник (30.06) пройдет вебинар с моим участием.

Если занимаетесь AI-агентами или только присматриваетесь к этой теме - завтра будет полезный вебинар.

Мы с командой покажем, каких AI-агентов мы уже внедрили в компании EFSOL, какие задачи они закрывают и как встроены в реальные бизнес-процессы.

Поделимся опытом разработки, расскажем, с какими задачами столкнулись и какие решения сработали.

Часть этих подходов вполне можно адаптировать под свои процессы, поэтому приходите не только посмотреть, но и собрать идеи для собственных внедрений.

Участие бесплатное, но надо зарегистрироваться 👈

📅 30 июня, 11:00 МСК
Post #46 151
🔎 Наткнулся на обсуждение про рабочие практики OpenClaw

Пост собрал то, что реально помогает не потерять контекст, не словить лишний риск и не перегрузить агента лишними скриптами

🧩 Проблема в кейсе следующая — OpenClaw начинает вести себя нестабильно, когда ему доверяют лишнее: ставят случайные skills, хранят важное только в сессии и не фиксируют шаги в файлах. Тогда часть контекста исчезает при compacting, а небезопасные навыки можно подхватить вообще без проверки.

⚙️ Решение здесь довольно приземлённое:
• писать свои skills в SKILL.md — это обычная инструкция для агента без кода;
• перед установкой читать scripts/, если там есть исполняемый код;
• держать долгий контекст в MEMORY.md, дневные записи — в memory/YYYY-MM-DD.md, рабочее состояние — в ACTIVE-TASK.md;
• для рутинных проверок ставить cron, чтобы задачи запускались по расписанию, а не вручную;
• использовать Opus для координации и Sonnet для узких подзадач;
• включать запасной сценарий, если провайдер ограничивает запросы.

Если совсем просто: агенту нужны не “умные догадки”, а понятная структура работы и следы каждого шага. Без этого он быстро теряет состояние, а команда потом гадает, что именно было сделано.

Что видно по кейсу — надёжность агента чаще ломается не на модели, а на организации вокруг неё: где хранится контекст, как запускаются повторяющиеся задачи и что вообще можно устанавливать без проверки


✅ Для себя я зафиксировал две вещи. Первая — не усложнять навыки скриптами, если агент и так справляется через встроенные инструменты. Вторая — не держать важное только в памяти сессии: как только есть многошаговая задача, нужен файл с текущим состоянием и отдельные отметки по ходу работы.

💡 Главный вывод кейса — стабильность здесь даёт не набор расширений, а простая дисциплина: свои инструкции, сохранённый контекст и регулярные контрольные точки
Post #45 179
🔎 Нашёл разбор про структуру OpenClaw

Человек описал, как workspace перестаёт разваливаться, если агент не просто выполняет задачи, а помогает поддерживать свои же правила, память и инструменты.

🧩 Проблема в кейсе следующая — у многих OpenClaw быстро превращается в свалку: слишком много контекстных файлов, память разрастается без пользы, навыки висят мёртвым грузом, а границы между личностью агента, памятью, инструментами и проектами размываются. На таком фоне система сначала выглядит умной, а потом начинает ломаться об собственную сложность.

⚙️ Автор решает это через разделение ролей и память по запросу:

• SOUL.md — стиль, поведение и голос агента;
• AGENTS.md — правила запуска, память и операционные привычки;
• USER.md — контекст человека и его цели;
• MEMORY.md — не свалка, а индекс, который ведёт к нужным записям;
• папки memory/people, memory/projects, memory/decisions — отдельные слои для разных типов контекста;
• skills и tools — только то, что реально используется в повторяющихся сценариях.

Если совсем просто: агент не держит всё в голове сразу, а быстро находит нужное по структуре и связям между файлами.

Что видно по кейсу — когда память оформлена как индекс, а не как один огромный файл, система дольше остаётся управляемой и легче расширяется без хаоса.


Я отдельно отметил мысль про самообслуживание среды. Полезность здесь появляется не от того, что агент «умный», а от того, что ему разрешают улучшать собственные документы, скрипты и правила работы. Это уже не набор разрозненных заметок, а рабочая инфраструктура, где изменения не теряются.

Для себя я зафиксировал ещё одну вещь: навыки надо держать только там, где они действительно нужны каждый день. Если исчезновение навыка завтра ничего не сломает, значит, он пока лишний.

💡 Главный вывод кейса — стабильность агента держится не на объёме памяти, а на понятной структуре, индексах и чётких ролях файлов
Post #44 170
🔎 Нашел полезный разбор про Claude Code как основу агента

Автор собрал ассистента почти без отдельного оркестратора - один md-файл, Telegram и небольшой сервер для памяти

🧩 Проблема в кейсе следующая - если пытаться собрать агента из набора фреймворков и внешних сервисов, быстро растут зависимости, настройки и точки отказа, а это довольно проблемно. В сценарии кейса задача была обратная - понять, сколько можно вытянуть только на Claude Code, без лишнего слоя вокруг.

⚙️ Решение построено так:

• Claude Code запускается как основной исполнитель задач;
• Telegram выступает точкой входа для команд, заметок и голосовых сообщений;
• один md-файл хранит сценарий запуска и описание системы;
• Flask-сервер на ~700 строк отвечает за постоянную память;
• MCP-плагины дают доступ к нужным действиям без отдельной orchestration-логики;
• embeddings, то есть числовые представления смысла текста, помогают искать контекст между сессиями.

Если совсем просто: большую часть работы делает не «сложный фреймворк», а сам LLM-процесс с понятной инструкцией, памятью и набором действий.

Что видно по кейсу — чем меньше лишних слоев между моделью и рабочим сценарием, тем проще понять, где система ломается и что именно нужно исправить


Для себя я зафиксировал две важные вещи:

🔸Во-первых, устойчивость такого агента держится не на количестве интеграций, а на том, насколько четко описан стартовый сценарий и как сохраняется контекст.
🔸Во-вторых, память полезна только тогда, когда она действительно помогает достать нужные записи между сессиями, а не просто копит текст.

✅ Если переносить это в свой процесс, я бы проверил:
• хватает ли одного понятного setup-файла, чтобы поднять систему заново;
• есть ли у агента отдельная точка для памяти и журнал действий;
• можно ли воспроизвести сценарий без ручной сборки из десятка сервисов.

Главный вывод кейса — сначала нужен простой и повторяемый сценарий с памятью и точками контроля, а уже потом наращивание автоматизации
  • 👍 2
  • ❤‍🔥 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →