TGViewer
Channel Public Channel
There will be no singularity

There will be no singularity

@nosingularity

Smartface, technologies and decay
@antonrevyako
Subscribers
1.96K
Photos
258
Videos
15
Links
1K

Showing posts older than #912 · Back to latest

Older Posts 17 shown
Post #910 1.63K
Дед с батей сцепились по пьяни и a испортили всем праздник каждую пятницу одно и то же...

Мне, честно говоря, тот вброс с бенчмарками от timescaleDB показался слегка странным, поэтому я не стал о нем ничего писать.
Post #909 1.75K
Post #906 2.34K
Хехе, и, конечно же, я накосячил в финальной подсказке :) Но валидность теста это не меняет
Post #904 1.95K
​Ждете ли вы от IT-инфлюенсера, что он будет писать НОРМАЛЬНЫЙ код?

Не вот чтобы прям какой-то супер оптимизированный, а просто НОРМАЛЬНЫЙ.

Хотя бы тот, что в паблик выкладывает...
Хотя бы чтобы можно было прочитать...
Хотя бы когда учит других...

Извините, открыл тут тестовые задания одного товарища...
Post #900 1.48K

Forwarded from Data-comics

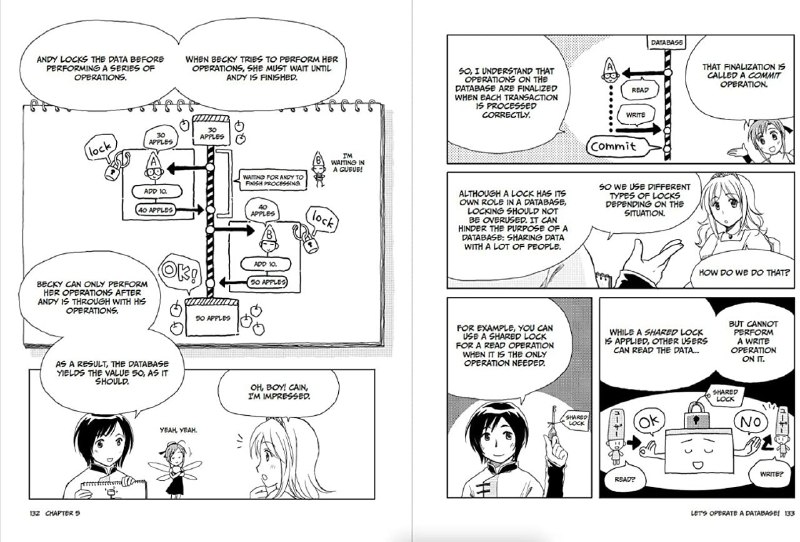
Учебник по базам данных в виде комикса!

Педагогическую ценность комиксов трудно отрицать - их интереснее читать, да и обилие картинок делает многие термины и кейсы понятнее. И не только для младшей школьной аудитории.

Азия к комиксам относится серьёзно. Индустрия манги (японский комикс), манхвы (корейский комикс) и маньхуа (китайский комикс) занимает важное место в экономике этих стран.

Только в Японии этот рынок составляет 5,7 млрд $ на 2020г. А к создателям манги обращаются "сенсей", что подчёркивает уважение к этой профессии.

https://www.amazon.com/Manga-Guide-Databases-Mana-Takahashi/dp/1593271905

За добычу спасибо @trumassive! ☺️

Мне же в связи с этим вспоминается "Энциклопедия профессора Фортрана". Кто помнит такой комикс-учебник? 😁
Post #898 1.86K
TOP GitLab DDL Warnings

Из top 15 найденных в DDL ворнингов, 13 касаются индексов. 5 из них рапортуют о различных пересечениях индексов - функциональных с обычными, частичных с функциональными и тд. Еще пять - о различных способах слишком большого покрытия таблиц индексами.

Еще парочка касается индексов и boolean полей.
Первое: не делать индексы только по булевым полям. В большинстве случаев такие индексы не будут использованы, т.к. по цене они будут дороже, чем seq scan.
Второе: не делать сравнение на равенство c булевыми константами (= TRUE). В pg есть две разные конструкции сравнения для булевого типа: = TRUE и IS TRUE. Рекомендуется везде использовать булево поле без сравнений вообще, чтобы не думалось.

Есть индексы на колонки без ограничений размерности. Например, типов TEXT и JSON(B) никак не ограничены. Это может привести к тому, что данные невозможно будет вставить с ошибкой "Values larger than 1/3 of a buffer page cannot be indexed.". Т.е. нужно либо ограничить размер колонки, чтобы он не превышал 1/3 от 8 кб (по умолчанию), либо нужно делать функциональные индексы на хеш значений из этой колонки.

Далее следует одна из совершенно базовых ошибок - сравнение с NULL.
 CREATE INDEX ON ... (group_id, title) WHERE (project_id = NULL::integer); 

Подразумевается, что он должен ускорить запросы вида
 WHERE group_id = 1 AND project_id = NULL 

Так вот, сам этот запрос не имеет физического смысла, т.к. project_id = NULL всегда вернет NULL. А TRUE AND NULL постгрес упростит до FALSE.
Т.е. этот индекс никогда не будет использован.

И завершает хит-парад ряд довольно популярных архитектурных ошибок.

Значение по умолчанию без ограничения NOT NULL. В большинстве случаев, если задано значение по умолчанию, разработчик не хочет чтобы оно было NULLом. Иначе зачем значение по умолчанию? :) Но если нет соответствующего констрейнта, то рассчитывать на это уже нельзя. А значит рано или поздно, NULL там окажется и сломает все, что можно сломать.
Причем часть разработчиков Gitlab это учитывает, а часть нет. В итоге схема напоминает письмо родителям дяди Федора из Простоквашино - рядом соседствуют поля с констрейнтами и без них.

Так же присутствуют поля с именем uuid, но типом VARCHAR, массивы идентификаторов, которые не проверяются на консистентность с таблицами, на которые они должны ссылаться и прочее и прочее...

Все сказанное выше, говорит, что архитектуру приложения стоит хорошенько переосмыслить, т.к. видно, что проблемы с тормозящими запросами пытаются решить созданием еще одного индекса, заточенного под конкретный запрос. Большое количество индексов снижает скорость вставки и обновления. Кроме того, как можно заметить, некоторые индексы никогда не будут использованы, а часть из них вообще может привезти к ошибкам в операциях вставки и обновления.
Post #897 1.43K
There will be no singularity Очередная история успеха приложения на рельсах. На этот раз у гитлаба https://about.gitlab.com/blog/2021/09/29/why-we-spent-the-last-month-eliminating-postgresql-subtransactions/ Они месяц с недешевыми консультантами разгребали то, что им нагенерили рельсы.…
А давайте посмотрим что там еще есть в этом гитлабе.... 1/2
Post #893 1.79K
В mysql при inline-объявлении внешнего ключа в CREATE TABLE, никакой FK не создается и сослаться можно на любые колонки, даже не имеющие unique констрейнта!

create table b (id int references a(id));


И это поведение не зависит от движка таблицы. При дампе DDL это свойство не будет отображено.

Создать внешний ключ можно только для движков innodb и ndb одним из 2 способов:

create table c (id int, constraint foreign key (id) references a(id));

или

alter table b add foreign key (id) references a(id);
Post #891 1.55K
Подведем итог ^
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →