TGViewer
Channel Public Channel
Нейроград | Илона Бортник

Нейроград | Илона Бортник

@neurogradik

НЕЙРОГРАД — пространство для всех, кто заинтересован нейросетями. Тут появляются идеи, инструменты и решения на стыке ИИ и человеческого опыта.

Автор — Илона Бортник, продукт-оунер и эксперт по нейросетям с практическим опытом.
Subscribers
2.47K
Photos
51
Videos
7
Links
21
Recent Posts 20 shown
Post #87 985

Forwarded from Ксения Зайцева

  • ❤ 16
  • 🔥 14
  • 😁 4
  • 👏 3
  • 🤣 2
Post #86 917
Отдыхаем с любимыми коллегами друзьями ❤️🔥
  • ❤ 2
Post #85 1.31K
Я уже писала про обычный промптинг, но правильный промптинг для создания приложений гораздо важнее, чем для обычного чата ✍

В чате плохой запрос чаще всего дает не тот текст. Неприятно, но поправимо: попросили переписать, добавили контекст, уточнили тон, нормально, цена пары итераций.
В коде же запрос оставляет более материальные следы. Агент может создать лишнюю сущность, придумать не тот сценарий или спрятать важную кнопку. И цена этому - лимиты. Если вы хоть раз пробовали вайб-кодить, то вы точно сталкивались с ситуацией, когда лимитов в очередной раз не хватило на реализацию вашей гениальной идеи и нужно ждать пять часов. Неприятно!

И здесь неожиданно очень помогает моя филологическая сторона. Обычно фраза «я филолог и люблю поболтать» звучит не как техническое преимущество, но только не тут.

Мне нравится думать о первом запросе как о карте. А проект — это территория: данные, ограничения, интерфейс и др.
Между картой и территорией почти всегда есть зазор - та часть карты, котрая от нас пока скрыта. И чем раньше мы его замечаем, тем меньше агенту приходится додумывать за нас.

Перед тем как просить ИИ что-то собрать, я бы разделила задачу на четыре части.

1. Что я точно знаю
Например:
Я хочу маленький инструмент для идей постов. Пользователь один. Нужны карточки с темой, описанием и статусом. Данные не должны исчезать после перезагрузки.

--
Это то, что можно прямо положить в первый запрос.

2. Что я знаю, что не знаю
Например:
Я пока не понимаю, как лучше хранить данные. Не уверена, нужны ли теги. Не знаю, делать ли отдельную страницу для архива.

--
Это тоже полезно писать. Тогда агент может предложить варианты.

3. Что я узнаю, только когда увижу
У интерфейсов много таких мест. Можно долго объяснять «чтобы было удобно», а потом увидеть экран и сразу понять: нет, карточки слишком плотные, кнопка не там, колонок много.
--
Сначала сделай один HTML-макет на фейковых данных с двумя вариантами компоновки. Код приложения пока не подключай. Я хочу отреагировать на структуру экрана.
--
Это экономит много нервов, потому что менять направление на макете дешевле, чем после того, как агент уже разложил всё по файлам.

4. О чем я вообще не подумала
Это самая интересная часть. Мы не можем заранее записать все вопросы, потому что часть вопросов нам пока недоступна.
--
Прежде чем писать код, найди мои слепые зоны в этой задаче. Какие решения могут потом дорого обойтись? Какие вопросы мне стоит уточнить до реализации? Задавай вопросы по одному, особенно если мой ответ может изменить структуру приложения.

Хороший первый запрос может выглядеть так:

Я хочу собрать маленькое веб-приложение для [ситуация].
Пользователь: [кто и в каком контексте].
Главный сценарий: [что человек делает по шагам].
На входе: [какие данные].
На выходе: [что должен получить].
В первой версии не делаем: [ограничения].
Я пока не уверена в [список неясностей].
Сначала не пиши код. Задай мне вопросы, которые могут повлиять на архитектуру, данные или пользовательский сценарий. После моих ответов предложи минимальный план первой версии и критерии проверки.


А какие у вас есть лайфхаки, делитесь!
  • 🔥 35
  • ❤ 10
  • 👍 6
Post #84 1.01K
12 июля у меня день рождения 🥳

В этом году он очень забавно разместился в календаре: Москва, двухдневный офлайн-интенсив, вы с ноутбуками и безудержный вайб-кодинг!
Если смотреть со стороны, может показаться, что это не самый очевидный способ отметить день рождения, но я
очень рада тому, как все складывается.

Я много лет работаю с обучением и очень не люблю момент, когда оно превращается в стопку конспектов и цикл лекций, после которого человек в свою работу ничего не унес.

Мне гораздо ближе другая картина: в комнате сидят люди, у каждого свой материал, свои файлы, свои ограничения, свои вопросы, которые хочется решить. Кто-то давно хочет собрать презентацию, кто-то приносит идею внутреннего инструмента, кто-то смотрит на данные и понимает, что из них пора сделать дашборд, а кто-то просто устал каждый раз копировать одно и то же.

Именно на таких задачках и надо учиться, причём не только вайб-кодингу, а чему угодно, потому что только в такой ситуации можно получить от обучения заряд дофамина. Не важно, насколько "серьёзная" ваша идея, надо подключаться и творить, это самый большой кайф 🤘

Для меня, как для преподавателя, самая интересная часть процесса тоже начинается рядом с открытым ноутбуком: человек показывает материалы, и мы разбираем, откуда это взялось, по чему проверяем, кому это нужно показать, какие данные лучше убрать, что будет считаться готовым результатом, где модель начала фантазировать.

А еще знаете как я соскучилась по офлайнам?! Раньше я преподавала только офлайн, а сейчас такое только по праздникам!

И в моем внутреннем списке подарков на день рождения точно есть удовольствие от совместной работы: чужое "о, оно открылось", мое любимое "погодите, тут модель наврала", момент, когда папка проекта перестает быть свалкой. Может показаться, что я преувеличиваю, но такие мероприятия заряжают меня на очень долгий срок!

Так что мой день рождения в этом году будет с ноутбуками, вопросами, финальными показами и, возможно, кофе, который опять остынет где-то у края стола. Если вам тоже хочется оказаться в этой комнате и принести свою задачу, буду рада вас увидеть ❤️

Это 11-12 июля в Москве:

https://zerocoder.ru/offline-intensive-vibe-coding?utm_source=telegram&utm_medium=neurogradik&utm_campaign=offline-vibe-code-intensive&utm_content=announce&erid=2W5zFJyYzY1

РЕКЛАМА ООО "ЗЕРОКОДЕР”
ИНН 9715401631
  • 🔥 11
  • ❤ 5
  • 🥰 1
Post #82 937
Моё первое приложение созданное с помощью вайб-кодинга было простой HTML-страницей 👨‍💻

Продолжаю погружать вас в мир моих взаимоотношений с вайб-кодингом. Боюсь, что это моя новая страсть, поэтому какая-то часть контента неизбежно будет связана с ним 😁 Так вот. Простой HTML-помощник для генерации картинок к презентациям, которые я делаю в огромных количествах по сей день. В одном поле я писала тему поста, в другом было короткое описание. Нажимала кнопку и получала английский промпт для генерации картинки в стиле презентации.

Звучит скромно, но именно с таких штук, как мне кажется, и стоит начинать вайб-кодинг.

Первая задача должна быть простой, земной и прикладной, такой, чтобы вы точно понимали, что именно вам нужно. В моем случае я точно знала, что почти для каждого слайда мне нужен визуал, а в промпте каждый раз приходится держать одни и те же правила: настроение картинки, композицию, палитру, фирменные детали, запреты, общий стиль. Можно, конечно, каждый раз собирать это заново в чате, но во-первых, это утомительно, а во-вторых, формулировки начинают жить своей жизнью и что-то теряется или добавляется.

Так появился маленький генератор промптов.

У него была очень простая логика. Есть постоянная часть, которую представляли собой визуальные правила презентаций. А есть переменная часть — тема презентации и короткие описания. Если эти две части объеденить, на выходе появляется готовый английский промпт, который уже можно закинуть в генератор изображений.

Мне нравится этот пример именно потому, что он хорошо показывает нормальный масштаб первого проекта. Он не пытается вести контент-план, писать посты, хранить медиатеку, анализировать реакции подписчиков и варить кофе с пенкой. Он делает одно понятное действие, которое до этого я регулярно повторяла вручную, а ещё его легко проверить.

Вот здесь, как мне кажется, и начинается хорошая логика первого приложения. Не надо придумывать “новый сервис”, лучше взять маленькую операцию, которую вы уже делаете по своим правилам. Например, вы постоянно превращаете хаотичную заметку во внятную повестку встречи. Или собираете описание задачи из обязательных блоков. Или проверяете документ по одному и тому же чек-листу. Или, как я, готовите однотипные промпты для картинок.Если действие повторяется, раздражает и требует помнить правила, оно уже просится в маленький инструмент.

Если хочется попробовать, можно начать разговор с ChatGPT примерно так:
Помоги сделать небольшую HTML-страницу для подготовки промптов к изображениям. На странице нужны два поля: тема материала и короткое описание. После заполнения страница должна выдавать английский промпт по заданной структуре визуального стиля.
Сначала помоги уточнить постоянную часть, переменные данные, способ формирования результата и критерии проверки.
Не добавляй функции, которые не нужны для этой цепочки.
После создания объясни, как открыть страницу и проверить несколько разных сценариев.
Тут есть один технический момент, который лучше решить до начала. Страница может просто подставлять ваши данные в заранее написанный шаблон, а может обращаться к модели, которая будет каждый раз перерабатывать описание и формулировать промпт заново.


Для пользователя оба варианта выглядят похожими: ввёл тему, получил результат. Но внутри это разные истории. У шаблона меньше магии, зато больше предсказуемости. У модели больше гибкости, но выше риск, что она начнёт красиво импровизировать и где-то потеряет важные правила.

Поэтому полезно сначала описывать не интерфейс, а логику.

Не “мне нужны два красивых поля и кнопка”, а примерно так:
Я передаю тему и описание. Инструмент соединяет их с постоянными правилами. На выходе я получаю английский промпт. Потом проверяю его по критериям стиля.

Маленькое приложение не обязано быть учебной игрушкой. Если оно сохраняет ваши правила, убирает повторяющуюся сборку и даёт результат, который можно проверить, оно уже выполняет настоящую работу и спасает ваше время ⏱
  • ❤ 17
  • 👍 8
  • 🔥 1
  • 🤝 1
Post #81 942
Я начала вайб-кодить с маленьких приложений. И мне кажется, что это был самый правильный вход

Когда сейчас рассказывают про вайб-кодинг, часто всё выглядит так, будто человек однажды открыл нужный инструмент, написал удачный запрос и внезапно начал собирать проекты.

Очень красивая версия.
В моей жизни всё было куда менее киношно 😁

Сначала в моей жизни появились маленькие приложения, которые я собирала вместе с ChatGPT и Qwen. Потом появились уже более крупные идеи. И только потом появился Codex. Если описывать это коротко, получается аккуратная лестница: попробовала простое, освоилась, пошла дальше.

Но в этой истории обязательно должен появиться ещё один человек (да, прозвучит пафосно, но из песни слов не выкинешь).

Кирилл.

Именно он настоял, чтобы мы всей командой прошли курс по вайб-кодингу. И я очень хорошо помню этот момент, потому что это было не предложение посмотреть там что-нибудь на досуге, а вполне конкретное распоряжение, которое можно сформулировать скорее как "давайте правда разберёмся, попробуем руками и внедрим в реальную работу".

И вот это, как мне кажется, очень важная часть освоения новых инструментов.

Между “мне интересно” и “я могу делать большие проекты” обычно лежит не вдохновение, а довольно земной маршрут: практика, ошибки, повторения, чужая поддержка и кто-то рядом, кто в нужный момент говорит: “Так, давайте не просто обсуждать, а проходить путь”. Благодаря Кириллу этот путь начался, а благодаря моей прекрасной Ксении Зайцевой ✨он стал очень классным и комфортным.

При этом мой первый шаг был совсем небольшим.

И сейчас, если бы мне надо было начинать с нуля, я бы делала именно так: не начинала бы с идеи сервиса на тысячи пользователей, не с “сейчас я автоматизирую всю свою жизнь”, а с одной маленькой рабочей боли, которую можно объяснить почти на пальцах.

Для первого разговора с ИИ можно взять такой каркас:
Я хочу собрать маленький инструмент для [конкретная ситуация].
Им будет пользоваться [один пользователь].
На вход он получает [данные], а на выходе должен давать [проверяемый результат].
В первой версии не нужны [лишние функции].
Сначала задай мне вопросы, которые помогут убрать неоднозначность. Потом предложи самую простую версию и объясни, как проверить, что она работает.

Мне нравится в этом подходе то, что он сразу возвращает нас к реальности. Не к мечте о “серьёзном продукте”, а к короткому циклу, который нужно прожить руками: сформулировал, собрал, проверил, увидел ошибку, уточнил. И вот после нескольких таких циклов происходит важный щелчок.

Ты уже не просто просишь нейросеть “ответить” или “написать текст”. Ты начинаешь думать сценариями: что человек делает, что получает, где может сломаться, как проверить результат, что стоит убрать из первой версии, чтобы не утонуть в собственных хотелках.

ChatGPT стал для меня местом, где этот цикл было легко начать. Там можно было быстро накидать идею, уточнить логику, собрать простую механику и не испугаться процесса. А когда проекты выросли, я перешла в Codex. Не потому что ChatGPT внезапно стал “несерьёзным”, а потому что задачи стали другого размера. В проекте появляется несколько связанных частей, постоянные правила, накопленные решения. Одно изменение уже нельзя оценивать отдельно, потому что оно может задеть то, что вчера работало нормально.

И вот тут становится понятно: тебе нужен не “модный инструмент”, а среда, которая выдерживает масштаб. Но одного масштаба мало. Нужна ещё опора, которая помогает не бросить всё после первого восторга.

У нас такой опорой стал командный курс. Если вы начинаете самостоятельно, это не обязательно должен быть именно курс. Иногда хватает коллеги, с которым вы раз в неделю показываете друг другу результат. Или договорённости в команде: каждый собирает по одному простому инструменту, а потом мы вместе разбираем, что получилось, что сломалось и где ИИ начал фантазировать.

Главное, чтобы обучение не заканчивалось просмотром материалов. После каждого нового приёма должен появляться кусочек собственного проекта, который можно открыть, потыкать и проверить ❤️
  • ❤ 18
  • 👍 10
  • 👌 3
  • 😱 1
Post #80 1.42K
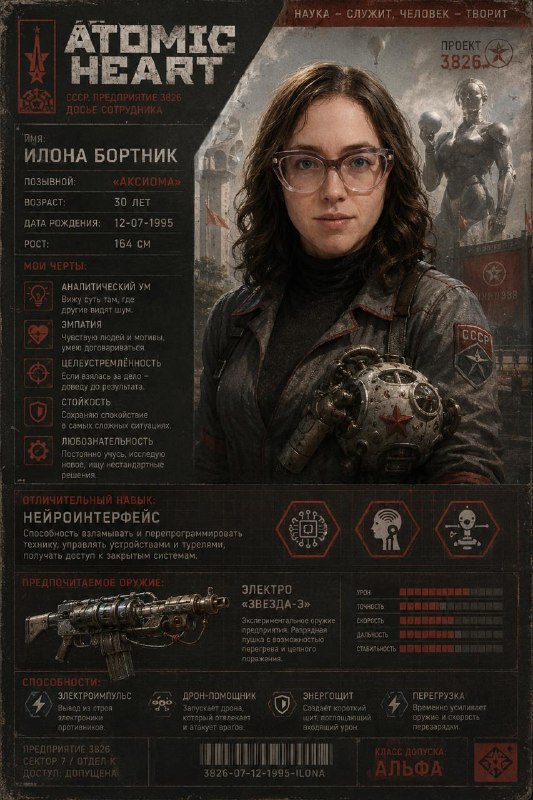
Вы наверняка уже встречали в сети эти ИИ-плакаты аля "если бы я был героем вселенной…" 😁

Ну что могу сказать. Я тоже пала жертвой трендов, новой ДЛС Atomic Heart и желания срочно посмотреть, какой персонаж получился бы из меня в другой вселенной.

В итоге на скорую руку сконструировала для нас универсальный промпт для фандомов на ваш вкус. Можно подставлять любую вселенную: Atomic Heart, Гарри Поттера, Ведьмака, Звездные войны, киберпанк, фэнтези, аниме, что угодно, куда душа просится. Главное хорошо объяснить фандом, потому что, например, моих любимых чародеек из детства он узнал только в английской версии названия, когда я написала W.I.T,C.H. Оно вроде и логично, но все-таки нюанс 😉

Промпт работает в мультиодальных нейросетях, так как им надо будет самостоятельно сходить в интернет, чтобы поискать информацию о фандоме. Если вы хотите использовать нейросеть, которая умеет только рисовать, то этот промпт лучше заранее адаптировать под фандом с помощью текстовой нейросети.

Промпт:

Создай вертикальный плакат-досье персонажа по фото во вселенной [ФАНДОМ].

Перед генерацией используй доступные знания, поиск или визуальные референсы, чтобы точно попасть в стиль фандома. Не показывай анализ, сразу создай постер.

Сохрани узнаваемость человека, но не копируй фото: замени одежду, фон, позу, ракурс и бытовые детали на полноценный образ персонажа из [ФАНДОМ].

По фото сам придумай: роль, фракцию/школу/орден/клан, специализацию, характер, ключевой навык, оружие/артефакт, 3–4 способности и девиз.
Подбери актуальные элементы под вселенную.

Данные:
Имя: [имя]
Возраст: [возраст]
Дата рождения: [дата]
Рост: [рост]

На плакате: портрет, фандом, роль, фракция, характеристики, способности, оружие/артефакт, девиз.

Важно: стиль должен считываться сразу. Используй минимум 5 признаков фандома: палитра, костюм, фон, свет, символика, атрибуты, типографика или композиция.
Русский читаемый текст. Без копирования конкретных персонажей, кадров, логотипов и официальных постеров.


И важное: лучше не использовать чужие фото без согласия, особенно если планируете публиковать результат. Экспериментируйте с собой, друзьями, коллегами, которые не против, или домашним котом в роли мага древнего ордена - это весело и безопасно. Если что, мое тоже можете брать 😁

Вот мой образ в Atomic Heart, как вам мой позывной? Мне кажется, что ну очень пафосно 😁

Теперь морально готова получить досье на себя в еще пяти вселенных и притворяться, что это все исследовательская работа для канала ❤️
  • 🔥 29
  • ❤ 4
  • 😁 3
Post #78 1.33K
Привет, друзья! ❤️

Иногда вдохновение приходит из места, в котором ты оказываешься. Со мной так случилось после Салехарда. Это была очень интересная поездка, надо сказать!

Я до сих пор под впечатлением от этого "северного ощущения": холодный воздух, тишина, графичная красота вокруг и местная культура, в которой так много силы, символов и связи с природой. Это как раз то место из которого хочется что-то унести с собой и попробовать перевести это на свой язык.

А мой язык, как вы уже знаете, довольно часто проходит через нейросети 😁

Я тестировала новую модель Seedance 2.0 и не смогла удержаться от эксперимента на эту тему. Захотелось сделать что-то вроде небольшой сказки на тему фольклора северных народов, концепции троемирия и этим ощущением древнего мира, где природа полноценный участник истории, а не просто фон.

По итогам теста могу сказать следующее:

Seedance 2.0 интересно держит стилистику и движение: картинка не разваливается на каждом кадре, а остается цельной, как будто листаешь ожившую иллюстрированную книгу. Конечно, без странностей пока никуда, но мне нравится направление: видеомодели постепенно становятся не просто генераторами эффектных роликов, а инструментом для визуального сторителлинга.

Вот такой у меня получился северный эксперимент. Очень хочу дальше пробовать делать подобные визуальные зарисовки по мотивам мест, людей и культур, которые меня зацепили и впечатлили. Мне кажется, это один из самых приятных способов подружить путешествия, исследование и AI.

А вам как такой формат? Делать еще такие визуальные истории по впечатлениям из поездок? ✨
  • 🔥 20
  • ❤ 18
  • 👍 4
Post #76 1.4K
Привет, друзья! ❤️

Недавно я ездила в командировку в Салехард, где выступала для коллег из ЯНАО, и после этого мы разговорились о презентациях. Оказалось, что для них это такая же насущная проблема, как и для меня: вроде и сервисов вокруг стало больше, есть нейросети, а собирать слайды все равно тяжело. Иногда даже тяжелее, чем раньше.

Мне часто приходится делать презентации по работе и для меня это настоящая ежедневная рутина. И одно дело если есть вдохновение, а если нет? Где взять нормальную структуру, как не утопить мысль в тексте, как не быть косноязычной, как сохранить свое оформление и не сидеть потом ночью, вручную переделывая то, что сначала вроде бы должно было сэкономить время.

После этого разговора я и решила оформить свой подход в отдельный гайд.

Я постаралась собрать туда те вещи, которые реально пригождаются в работе: с чего вообще начинать, как собрать каркас, как подготовить текст для слайдов, как объяснить нейросети, на что ей ориентироваться в оформлении, и как потом все проверить перед отправкой. Внутри есть и сами шаги, и промпты, и короткая шпаргалка, к которой можно возвращаться уже в процессе работы.

Кстати, собирала гайд с помощью Codex в рамках нашего курса по работе с Claude Code, очень рекомендую обратить на него внимание. Если надумаете приобрести, буду рада поделиться своей реферальной ссылкой, как говорится 😁 это не реклама, к сожалению, но курс я прямо сейчас прохожу и очень довольна, несмотря на то, что получается еще не идеально (например, вы в гайде точно сможете найти пару очевидных косяков)! Но это только начало!

Ссылка на гайд: https://drive.google.com/file/d/1xVPqSOJegiSGznDUCywnx5gknlNcrDg4/view?usp=sharing
  • 🔥 15
  • ❤ 6
  • 🙏 2
Post #75 1.4K
Кажется, промптинг для ChatGPT снова немного поменялся 😎

Привет, друзья!

Если вы в последние дни тестировали GPT-5.5 и ловили ощущение, что старые промпты вдруг стали работать хуже, возможно, вам не показалось. Вместе с новой моделью слегка поменялась и логика хорошего запроса.

Сейчас GPT-5.5 во многих задачах уже не нужно так тщательно вести за руку, как более старые модели. Ему куда важнее нормально поставить задачу: сказать, что именно нужно получить, для кого, в каком формате, с какими ограничениями. Мы с вами официально в моменте, когда нейросети не нужны большие ролевые инструкции и попытки предугадать каждый шаг. Это все еще можно делать, иногда даже нужно, но это больше не аксиома.

По сути новую логику можно сформулировать так: не пытаемся управлять каждым движением модели, а просто внятно объясняем задачу.

Что из этого следует на практике 💪

1. Начинай с результата, а не с вступления
Вместо: “Ты легендарный эксперт по контент-маркетингу, работающий 20 лет...”
Лучше: “Подготовь 3 версии Telegram-поста для маркетологов СНГ о новой модели GPT-5.5. Нужен живой, экспертный тон, без канцелярита, с одним ключевым выводом и практической пользой”.

Такой заход обычно работает лучше, потому что модель сразу понимает, куда мы идем и что именно считаем удачным ответом. Первый же вариант лучше использовать, если вам нужно получить особенный специальный тон.

2. Давай контекст, но не давай слишком много
Контекст модели нужен. Но только тот, который реально помогает решить задачу. Если в запросе слишком много второстепенных деталей, ответ начинает расползаться.

3. Сразу говори, каким должен быть хороший результат
Не просто “напиши текст”, а “сделай текст понятным новичку, без тяжелого жаргона, с тремя практическими рекомендациями и коротким выводом”.

4. Тон лучше задавать коротко и отдельно
У GPT-5.5 ответы часто довольно прямые и деловые по умолчанию. Поэтому если тебе нужен теплый, более человечный, более ироничный или, наоборот, сухой экспертный тон, лучше сказать это отдельно и коротко.

Например:
“Тон спокойный, живой, без пафоса и канцелярита”
или
“Стиль плотный, профессиональный, без разговорных отступлений”

Или просто дай примеры 😉

5. Для сложных задач лучше делать несколько проходов, а не один монстр-промпт
Например:
- сначала попросить план,
- потом черновик,
- потом отдельной командой
- проверить слабые места, факты или структуру.

Так и проще управлять процессом, и модели проще не потерять фокус.

Если совсем упростить, то хороший промпт для GPT-5.5 сейчас чаще всего выглядит примерно так:

Задача: что нужно сделать
Контекст: что важно знать
Критерии: что должно получиться
Формат: таблица, пост, письмо, тезисы
Ограничения: что нельзя и что обязательно
Тон: как это должно звучать

Похоже на классическую рамку, но гораздо проще с формулировками.

Так что мой главный вывод про GPT-5.5 такой:
чем сильнее модель, тем меньше смысла усложнять промпт ради самого промпта.

Мне кажется, что это очень приятный шаг вперед в общении с нейросетью ❤️
  • ❤ 27
  • 👍 12
  • 🔥 4
Post #74 1.26K

Forwarded from Интеллектуальная хулиганка | Эксперт по нейросетям

Я ещё не делилась с вами этой статьей, но уже пора:
https://ya.zerocoder.ru/kto-v-zerokodere-stoit-za-samym-uspeshnym-kursom/

Это та самая внутренняя кухня, о которой мне очень хотелось рассказать, потому что я действительно очень люблю курс по Perplexity, хотя благодаря ему у меня и прибавилось немного седых волос 🤭

Мы с Илоной работали в тандеме, и получилось, на мой взгляд, очень здорово.

Спасибо нашей прекрасной балийской богине и академическому директору за то, что поверила в этот союз двух профессионалов, дала нам возможность раскрыться и создать курс, которым я всегда буду гордиться ✨

Статья построена в формате диалога, поэтому в ней вы увидите и мои мысли, и мысли Илоны, и то, как мы вместе работали над курсом.

Приятного чтения ❤️
Я зерокодер Кто в «Зерокодере» стоит за самым успешным курсом - Я зерокодер
  • ❤ 19
Post #73 1.47K
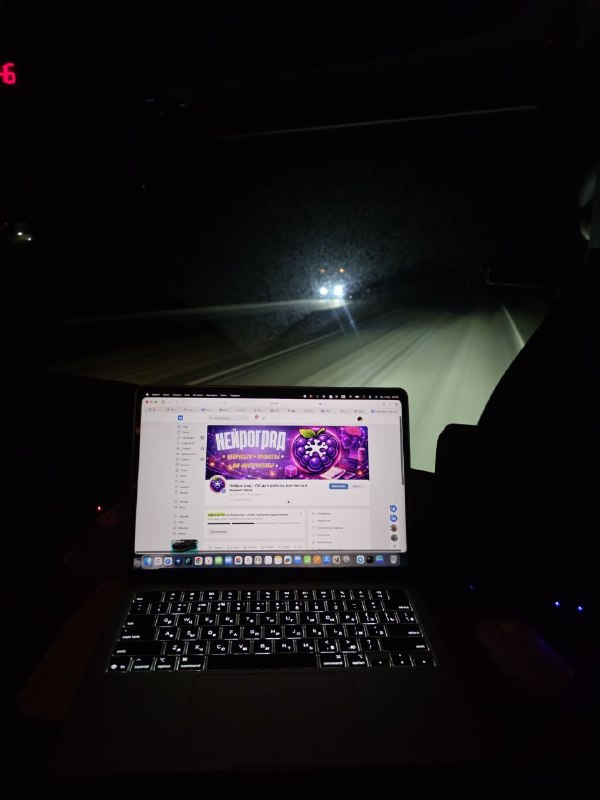
Нейроград расширяет территорию 💜

Привет, друзья!

Никогда не думала, что в 2026 вернусь в VK, но я все-таки сделала сообщество Нейрограда в ВК. Причина тут довольно приземленная: Telegram в России у многих сейчас работает с приключениями, и мне совсем не хочется, чтобы часть аудитории читала канал по принципу «сегодня открылось — уже спасибо». Поэтому я решила сделать для Нейрограда еще одну точку доступа.

Сразу скажу важное: это не переезд и не попытка механически дублировать все подряд. Telegram остается моим основным местом для быстрых мыслей, наблюдений, новостей, тестов и всего того, что хочется принести вам сразу, пока оно еще горячее. А ВК мне хочется использовать немного иначе — для больших текстов, спокойных разборов и материалов, которым нужно больше воздуха. Ну правда, где еще их выпускать. Не держать же все это в голове, заметках и черновиках до лучших времен.

Хотя кто знает, если так пойдет и дальше, может к концу года мы и правда соберем из этого небольшую книгу 😁

В общем, в ВК вас уже ждет первый пост и небольшой полезный подарок к нему. Так что заглядывайте:

https://vk.com/club237388042

Если вы уже есть в VK, буду рада видеть вас и там 💜
  • ❤ 10
  • 👏 5
  • 🔥 4
  • 🥰 2
Post #72 1.59K
Еду в командировку и наконец-то готовлю для нас базу в VK. Скоро встретимся на ещё одной площадке 🔥
  • 🔥 25
  • ❤ 9
  • 👎 1
Post #71 1.69K
Кажется, у видеоредакторов сегодня случился очень внезапный повод напрячься (или порадоваться) ☕️

Netflix выложил в открытый доступ VOID — модель для удаления объектов из видео. Но самое интересное тут не в самой функции “убрать объект из кадра”. Таких обещаний мы уже видели немало. А VOID обещает, что попытается удалить не только сам объект, но и последствия его присутствия в сцене. То есть если из сцены убрать человека, который что-то держал, модель не должна оставить предмет висеть в воздухе просто потому, что “так получилось по пикселям”. Как это работает на деле я еще не знаю, но звучит очень интересно!

Почему меня это заинтересовало?

Это звучит как шаг к более “осознанному” видеоредактированию, где нейросеть не просто дорисовывает фон, а пытается пересобрать логику сцены после удаления объекта. Мы все привыкли к тому, что AI в видео умеет что-то замазать, что-то дорисовать, где-то навести красоту. А тут акцент уже на другом: модель пытается работать с причинностью. Кто на что влиял, что должно упасть, что сдвинуться, что должно изменить траекторию после удаления объекта.

Честно, для меня это один из самых неожиданных "залетов" на рынок последних месяцев, потому что нас все ближе подводят к монтажу, где нейросеть не просто ретушер, а почти симулятор альтернативной реальности в кадре. Очень хочу теперь посмотреть, как быстро такие подходы доберутся до более прикладных инструментов для креаторов, монтажеров и рекламы.

ссылочки: https://github.com/netflix/void-model
https://huggingface.co/netflix/void-model
https://void-model.github.io/
  • 🔥 21
  • ❤ 7
  • 👍 2
Post #70 1.82K
Привет, друзья!

Наткнулась на очень эффектное видео с китайского Весеннего фестивального гала-концерта 2026. На сцене дети-ушуисты выступают вместе с человекоподобными роботами, и это выглядит как что-то между культурным номером, научной фантастикой и очень крутой демонстрацией того, куда вообще движется современная робототехника.

Но, если честно, самое интересное тут даже не в том, что роботы машут мечами и крутят нунчаки. Самое интересное в том, что это очень наглядный пример embodied, то бишь, "телесного" искусственного интеллекта. То есть ИИ, который должен не просто отвечать в чате, а управлять телом в физическом мире: держать равновесие, двигаться в ритме, ориентироваться в пространстве, не терять позицию после резких движений и еще желательно не уронить реквизит на соседа по сцене.

Если разложить номер на слои, то картина получается очень красивая.

Во-первых, сами роботы. Unitree прямо пишет, что в шоу использовались их человекоподобные модели G1 и H2. G1 — это более компактная модель ростом около 132 см и весом около 35 кг, H2 — уже полноразмерный робот ростом около 182 см и весом около 70 кг. То есть это не один условный «робот-актер», а уже целая линейка, которая закрывает разные сценарии и уровни сложности.

Во-вторых, управление движением. По материалам Unitree и пересказу Live Science, команда донастраивала заранее обученные модели управления и отдельно работала с моделью трюковых движений, чтобы роботы могли выполнять длинные последовательности без ошибок. И это, кстати, супер интересный момент. На таком шоу недостаточно сделать один красивый прыжок. Нужно, чтобы вся цепочка движений не «поплыла» после второго, третьего и десятого элемента. То есть, нужно, чтобы ошибки еще и не накапливались.

В-третьих, определение положения в пространстве. Unitree описывает использование алгоритма объединенной локализации на основе ИИ с совмещением внутренних данных робота и трехмерного лазерного сканера. То есть, робот должен постоянно понимать, где он находится, в каком положении его тело, куда он сместился после резкого движения и как не потерять ориентацию после сложного элемента. Иначе никакой синхронной боевой хореографии не получится.

В-четвертых, координация группы. В официальном релизе Unitree говорится про обновленную систему управления группой роботов, которая синхронизировала десятки машин в реальном времени. Live Science отдельно пишет, что это позволяло выстроить почти полностью автоматизированный сценарий: от ИИ-планирования хореографии до координации нескольких роботов с синхронизацией на уровне миллисекунд. И вот это уже звучит как серьезная заготовка для будущих задач, где машинам нужно действовать вместе.

И еще один очень красивый слой — это руки и работа с предметами. В релизе Unitree говорится о новых собственных ловких кистях, которые помогали быстро переключаться между позициями и стабильно держать реквизит.

Разумеется, это не значит, что "ну все, роботы уже как люди". Шоу проходило в контролируемой среде, с заранее подготовленным сценарием, точной постановкой и большой инженерной доработкой. Но это не делает его менее важным. Такие демонстрации очень хорошо показывают, насколько быстро растет качество связки искусственный интеллект + аппаратная часть + системы управления.

И вишенкой на торте стало недавнее заявление Китайский Коммунистической Партии о необходимости "...поощрять инновации в мультимодальных технологиях, интеллектуальных агентах, воплощённом и коллективном интеллекте, а также исследовать пути развития общего искусственного интеллекта (AGI)". Ждем от китайских коллег новых моделей и интересных решений 💪

Почитать про роботов: тут или тут
  • 🔥 19
  • 👍 10
  • ❤ 5
  • 👏 1
Post #69 2.34K
Кажется, над Perplexity сгущаются тучи 🧐🌩

Привет, друзья! Сегодня обсудим, что происходит с Perplexity. Я активно использую эту нейросеть в работе и до меня иногда долетают слухи о том, что у них не все гладко, а тут ещё моя прекрасная подписчица принесла интересную новость в комментарии (вот тут можно почитать). Давайте поглубже погрузимся в этот вопрос!

Что именно вызывает вопросы

Первая история касается моделей. Пользователи пишут, что при выборе одной модели в интерфейсе фактически могли получать ответы от другой, более дешевой и более слабой по возможностям. CEO Perplexity объяснил это инженерным багом и fallback-механизмом: система якобы случайно переключалась на запасную модель при перегрузке, ошибке или защите от злоупотреблений. И тут вроде дело житейское, но, как говорится, есть нюанс. Модель никогда не "ошибалась" в пользу юзера, только в пользу компании, то есть, подставляла более слабую (и более дешевую) модель.

Вторая претензия связана с лимитами. Pro-подписка за последние месяцы прошла довольно неприятную эволюцию: от риторики про очень щедрые или почти безлимитные возможности компания перешла к более жестким и весьма расплывчато описанным ограничениям. И людей злит не только сам факт сокращения лимитов. Гораздо сильнее раздражает способ, которым это происходило: без понятных уведомлений, с противоречивыми формулировками и с постоянным ощущением, что тебя очень аккуратно подталкивают к более дорогому тарифу.

Третья история, пожалуй, самая тревожная для тех, кто использует ИИ в работе, в трм числе и для меня. Речь про январское (и снова тихое, без уведомлений) обновление Terms of Service, где для обычных и Pro-пользователей отдельно закрепили личное некоммерческое использование, а также довольно широко описали лицензию на пользовательский контент и требования к атрибуции. И вот здесь возникает вполне понятный вопрос. Если тариф называется Pro, а сервисом активно пользуются авторы, аналитики, исследователи, консультанты и все те, кто давно встроил такие инструменты в рабочие процессы, то где вообще проходит реальная граница между “личным” и “профессиональным” использованием? Потому что пока это звучит не как ясное правило, а как потенциальная зона будущих споров.
----

Мне совсем не хочется скатываться ни в вердикт “все, сервис окончательно испортился”, ни в формат “да ладно, это все скандал на пустом месте ”. Пока, как мне кажется, честно говорить так: есть набор серьезных претензий, есть часть ответов со стороны компании, и есть очень заметный запрос пользователей на прозрачность. Когда ты платишь за сервис, тебе важно понимать, какая модель реально работает, какие у тебя лимиты и по каким правилам вообще можно использовать инструмент в своей практике.

Поэтому моя позиция здесь скорее осторожная. Ситуация точно заслуживает внимания, но окончательные выводы делать рано. Хочется посмотреть, как Perplexity будет дальше объяснять спорные моменты, что изменится в интерфейсе, лимитах и правилах, и появится ли более внятная коммуникация с пользователями.

Если у истории будет продолжение или всплывут важные уточнения, обязательно разберем вместе ❤️
  • 👍 32
  • 🤔 22
  • 🔥 8
  • 🤝 6
  • ❤ 5
Post #68 2.32K
Привет, друзья ⭐️

Perplexity обновился и многих смутило даже не то, что появилось что-то новое, а то, что привычные функции теперь лежат в другом месте и называются иначе. Делаю для нас маленький конспект по новым режимам, как они выглядят в русской версии, и зачем каждый нужен. Сегодня смотрим старый-новый "Создание файлов и приложений"

Это режим, в котором Perplexity не просто отвечает в чате, а собирает результат в виде “готового объекта”. В зависимости от запроса это может быть презентация, документ, таблица или даже простая страница/мини-инструмент, который можно открыть в браузере. На самом деле - это старый добрый режим Labs, но в новой одёжке.

Когда это полезно
Я бы использовала этот режим не “на каждый день”, а в ситуациях, когда нужен быстрый старт и понятная форма результата.

1) Презентация, которую потом спокойно довести руками
Подходит, когда есть тема, есть структура, но нет времени раскладывать мысль по слайдам и оформлять базовую логику. Perplexity может собрать заголовки, последовательность, тезисы и подсказать, где просится схема или простая инфографика.

2) Документ-скелет: инструкция, регламент, чеклист, FAQ
Особенно хорошо работает, если у тебя есть требования и ограничения, и ты хочешь получить аккуратный черновик, а не “полотно текста”.

3) Таблица под задачу
Контент-план, план обучения, матрица рубрик, список задач для проекта, сравнительная таблица инструментов. Важно, что Perplexity может сразу разложить это в структуру, чтобы не начинать с пустого листа.

4) Маленький веб-инструмент
Что-то простое и прикладное: калькулятор, генератор, проверялка, мини-форма, прототип страницы. Это не замена разработке, но очень помогает быстро “пощупать” идею и понять, что именно нужно.

Как промптить, чтобы получилось нормально
Этот режим лучше всего отвечает, когда в запросе есть три вещи: что ты создаешь, каким должен быть результат, по каким правилам ты будешь оценивать качество.

Пример
Собираем презентацию в режиме «Создавать файлы и приложения».
Тема: [тема].
Для кого: [аудитория] и что они уже понимают: [уровень].
Зачем: после просмотра человек должен [конкретный результат].
Структура: 9–11 слайдов.
1) Вступление: контекст и зачем это важно.
2–8) Основные блоки: каждый слайд раскрывает одну мысль и логично продолжает предыдущий.
9) Практический чеклист: что сделать сразу после просмотра.
10–11) Ошибки, примеры и финальный вывод.
Требования к тексту:
— на каждом слайде заголовок и 3–5 развернутых тезисов нормальными предложениями,
— без общих фраз, которые можно вставить в любую тему,
— добавь 2–3 коротких примера из реальных рабочих ситуаций.
Оформление:
— стиль: [описание стиля],
— цвета: [палитра],
— схемы и иконки добавляй только там, где они помогают понять смысл.
В конце добавь отдельный слайд «Что стоит перепроверить», чтобы было видно, где нужна факт-проверка.
  • ❤ 35
  • 🔥 20
  • 👍 13
  • 🤝 6
Older posts →

About this channel

How can I read @neurogradik without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Нейроград | Илона Бортник: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Нейроград | Илона Бортник have?
Нейроград | Илона Бортник (@neurogradik) has 2.47K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Нейроград | Илона Бортник know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →