
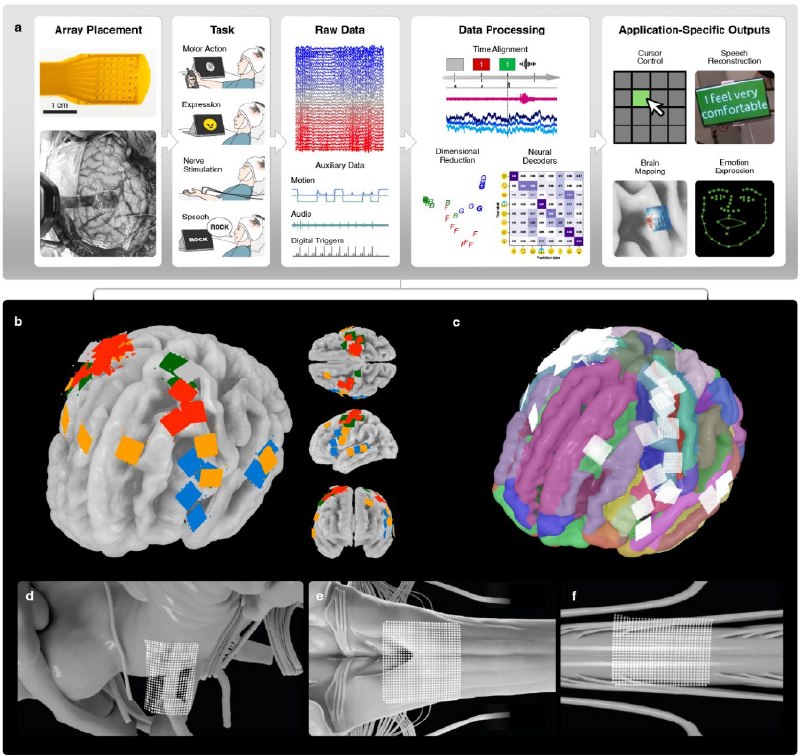
Precision Neuroscience выложили большой препринт: записали 70 пациентов своими гибкими сетками на 1024 электрода(ECoG) и собрали из этого атлас. Кора, ствол и даже спинной мозг.
Идея у статьи интересная. Whole-brain interface обычно представляют как одно огромное устройство в одной голове, которое пишет весь мозг сразу. Они заходят с другой стороны: записать много людей по кусочкам, свести всё в общие анатомические координаты и получить что-то функционально похожее.
Как записывали
Сетка лежит на поверхности мозга и ничего не протыкает. Шаг между электродами 400 мкм, ровно как у Utah массива, с которым мы работаем. Только электродов в 10 раз больше, и видно LFP и high-gamma, а не спайки. По сравнению с клиническим ECoG с шагом около 1 см это в 600 раз плотнее. Кстати, в нашей статье FingerFlex использовались данные на клинической сетке. Теоретически с такой плотностью как у precision можно сильно улучшить качество.
Пациентов записывали во время операций на мозг. Поэтому большинство записей короткие: в 58 случаях из 70 сетку клали прямо на операции, медиана 22 минуты. Ещё у 12 человек сетка стояла несколько дней, и на них приходится 85% всех часов. Всего около 180 часов.
Что увидели.
Смена полярности SSEP на центральной борозде укладывается в два электрода, пальцы в S1 лежат по порядку как в гомункулусе, в слуховой коре видна тонотопия. Отдельно круто, что записали ствол и спинной мозг, хотя там только вызванные ответы под наркозом: например, на грудном отделе ответ на стимуляцию левой и правой ноги приходит в разные стороны сетки.
Декодинг тоже есть, но везде внутри одного пациента и на маленьких задачах. Джойстик в 4 стороны 83% при шансе 25%, три слова и тишина 92% на 18 примерах для обучения, 8 выражений лица до 67% на лучших классах. Декодировать можно!
Что бы я попробовал на этих данных
Такой датасет очень интересен для того чтобы протренить разные модельки Вот что мне было бы интересно проверить.
1. Одна модель на всех.
В этой статье весь декодинг внутри одного пациента, а самое интересное посмотреть сможет ли модель обобщится и начать работать на новом пациение. Жесты руки записаны у 21 пациента, так что можно учить на 20 и смотреть, как модель справится с 21-м. В speech BCI недавно сделали похожее (Fogg et al. 2026): общая модель плюс свой входной слой на каждого человека, и WER в среднем на 51% ниже, чем у моделей под одного. Было бы круто увидеть такой же эффект на поверхностных сетках.
2. Претрейн на всех 180 часах.
Авторы сами упоминают foundation models в Discussion, и данные для этого уже есть: 180 часов с тысяч электродов. Я бы попробовал MAE, а потом дообучение на задачи с маленьким числом примеров (сейчас от 18 до 200). Электроды я бы кодировал относительным эмбеддингом, например из функциональной связности (какие электроды коррелируют между собой), а не только координатой на шаблонном мозге: у неё ошибка до 2 мм.
Links
Toward A Whole-Brain Interface Enabled by High-Resolution Surface Electrophysiology
https://doi.org/10.64898/2026.09.24.754261
Post #345
343
- ❤ 9
- ⚡ 3