TGViewer
Channel Public Channel
the last neural cell

the last neural cell

@neural_cell

we write about BCI, AI and brain research.

authors:
@kovalev_alvi - visual neural interfaces at UMH, Spain | Co-Founder of ALVI Labs
@Altime - comp neuro phd @ GTC Tübingen

Our chat: @neural_cell_chat
Subscribers
1.45K
Photos
118
Videos
11
Links
142
Recent Posts 16 shown
Post #345 402
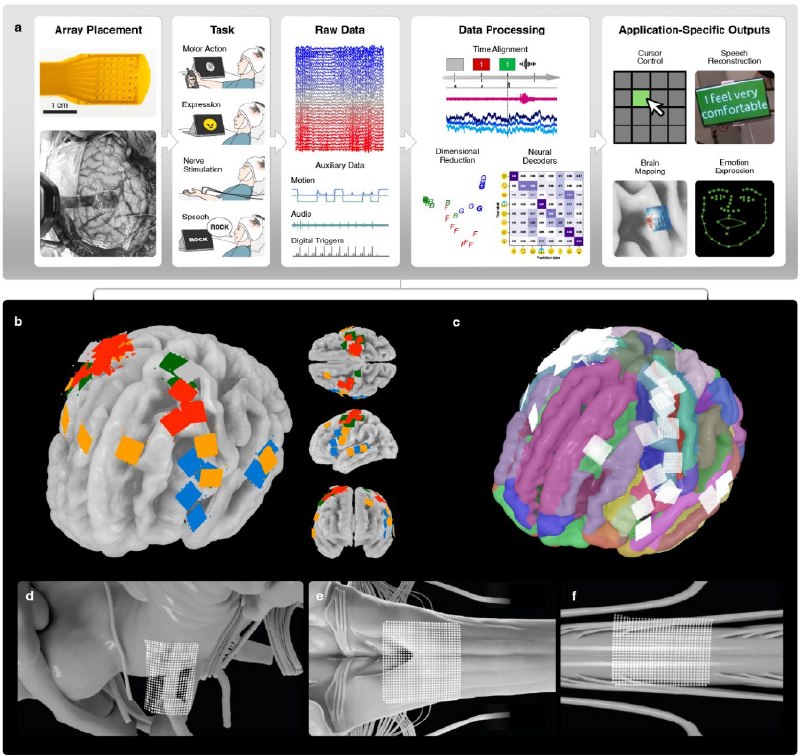
Precision Neuroscience выложили большой препринт: записали 70 пациентов своими гибкими сетками на 1024 электрода(ECoG) и собрали из этого атлас. Кора, ствол и даже спинной мозг.

Идея у статьи интересная. Whole-brain interface обычно представляют как одно огромное устройство в одной голове, которое пишет весь мозг сразу. Они заходят с другой стороны: записать много людей по кусочкам, свести всё в общие анатомические координаты и получить что-то функционально похожее.


Как записывали
Сетка лежит на поверхности мозга и ничего не протыкает. Шаг между электродами 400 мкм, ровно как у Utah массива, с которым мы работаем. Только электродов в 10 раз больше, и видно LFP и high-gamma, а не спайки. По сравнению с клиническим ECoG с шагом около 1 см это в 600 раз плотнее. Кстати, в нашей статье FingerFlex использовались данные на клинической сетке. Теоретически с такой плотностью как у precision можно сильно улучшить качество.

Пациентов записывали во время операций на мозг. Поэтому большинство записей короткие: в 58 случаях из 70 сетку клали прямо на операции, медиана 22 минуты. Ещё у 12 человек сетка стояла несколько дней, и на них приходится 85% всех часов. Всего около 180 часов.

Что увидели.
Смена полярности SSEP на центральной борозде укладывается в два электрода, пальцы в S1 лежат по порядку как в гомункулусе, в слуховой коре видна тонотопия. Отдельно круто, что записали ствол и спинной мозг, хотя там только вызванные ответы под наркозом: например, на грудном отделе ответ на стимуляцию левой и правой ноги приходит в разные стороны сетки.

Декодинг тоже есть, но везде внутри одного пациента и на маленьких задачах. Джойстик в 4 стороны 83% при шансе 25%, три слова и тишина 92% на 18 примерах для обучения, 8 выражений лица до 67% на лучших классах. Декодировать можно!

Что бы я попробовал на этих данных
Такой датасет очень интересен для того чтобы протренить разные модельки Вот что мне было бы интересно проверить.

1. Одна модель на всех.
В этой статье весь декодинг внутри одного пациента, а самое интересное посмотреть сможет ли модель обобщится и начать работать на новом пациение. Жесты руки записаны у 21 пациента, так что можно учить на 20 и смотреть, как модель справится с 21-м. В speech BCI недавно сделали похожее (Fogg et al. 2026): общая модель плюс свой входной слой на каждого человека, и WER в среднем на 51% ниже, чем у моделей под одного. Было бы круто увидеть такой же эффект на поверхностных сетках.

2. Претрейн на всех 180 часах.
Авторы сами упоминают foundation models в Discussion, и данные для этого уже есть: 180 часов с тысяч электродов. Я бы попробовал MAE, а потом дообучение на задачи с маленьким числом примеров (сейчас от 18 до 200). Электроды я бы кодировал относительным эмбеддингом, например из функциональной связности (какие электроды коррелируют между собой), а не только координатой на шаблонном мозге: у неё ошибка до 2 мм.


Links

Toward A Whole-Brain Interface Enabled by High-Resolution Surface Electrophysiology

https://doi.org/10.64898/2026.09.24.754261
  • ❤ 9
  • ⚡ 3
Post #344 1.01K
Нобелевская премия по физиологии или медицине 2026

«За открытия светоуправляемых ионных каналов и оптогенетики».

Peter Hegemann, Georg Nagel, Karl Deisseroth.
nobelprize.org/prizes/medicine/2026/press-release


Сегодня утром я решил разобраться в этом и попросил опуса мне сделать видео. Оно мне очень сильно зашло, поэтому делюсь с вами.

Смотрите со звуком.
  • ❤ 10
  • 🤯 2
Post #343 707
Deep learning-based control of electrically evoked activity in human visual cortex
link
: https://doi.org/10.1016/j.neuron.2026.07.006

Классная статья в Neuron от нашей лабы. Меня там нет, ибо приехал позже.

Коротко:
- делаем кучу случайных стимуляций в V1 человека (разные токи и комбинации электродов)
- учим сетку в обе стороны: предсказывать ответ мозга по параметрам стимуляции и наоборот

В итоге получаем модель, которая выдаёт параметры стимуляции под нужную активность мозга. На реальном пациенте попадает в использует меньше тока и даёт более стабильные фосфены, чем ручная калибровка.

p.s.
Следующие шаги:
1. работаем только с определенный статичным протоколом стимуляций - то есть никаких bimemetic и прочего.
2. Не предсказывает активность во времени - только средний нейронный отклик для каждого канала.
  • 🔥 9
  • ❤ 3
Post #341 628
Masked Autoencoders Learn Perception-Relevant Representations from Resting State Neural Data
link: https://arxiv.org/abs/2607.22615

tl;dr: предобучаем MAE на 14.6 часах спонтанной активности из V1 слепого пациента с Utah array и по нейронному отклику на стимуляцию декодируем, видит человек фосфен или нет. Реальные данные пациента.

Наконец-то дошли руки написать мини обзор моей статьи с AAAI 26. Постером я уже делился, а теперь она доехала и до архива.

Итак, мы работаем с сигналами Utah массива из V1 слепых людей: можем и стимулировать, и записывать. Было бы здорово не спрашивать человека каждый раз, видит он что-то или нет, а понимать это прямо по нейронному отклику на стимуляцию. Плюс у нас накопилась куча спонтанной активности: 252 сессии, 14.6 часа записи с 96 каналов. Вот и вопрос: можно ли предобучить модель на этих данных так, чтобы она помогала понять, видит человек или нет.

Модель
За основу взял MAE, кстати один из первых обзоров на этом канале был именно про эту модель, много лет назад. Натренировал и увидел в латентах кучу кластеров по сессиям, что совсем не ложится на задачу: мы хотим отличать, видит человек или нет, а не угадывать, в какой день была сделана запись. Поэтому добавил второй лосс, по сути sigmoid loss как в SigLIP, только наоборот: притягиваю фичи из разных сессий и отталкиваю фичи из одной. Плюс подаю в декодер эмбеддинг сессии отдельным токеном: вся сессионная информация уходит туда, и энкодеру просто незачем хранить её в латентах. Латентное пространство стало выглядеть сильно лучше, и метрики подтянулись.

Результаты
Поверх замороженного энкодера учим обычную логистическую регрессию. На психометрической задаче (человек отвечает видит или нет на стимуляции с разной силой тока и электродами) получаем 84.1% против 80.2% на сырой MUA и 82.4% на PCA. Забегая вперёд, в латентах ещё видно, каким электродом стимулировали и с каким током: соседние электроды кластеризуются вместе. Но самое интересное это пороговая задача: тот же электрод, ток зафиксирован на пороге 50%, человек то видит фосфен, то нет. И даже тут мы декодируем восприятие на 64% против 60% на сырых данных.

Так что наконец закрыл гештальт и поделился, а то собирался уже несколько недель и всё никак не мог дойти. Дальше думаю превратить это в полноценную статью: обучиться на нескольких людях и сделать нормальные абляции.
  • ❤ 12
  • 🔥 6
  • ⚡ 1
Post #340 675

Forwarded from LIFT feed

Та самая группа из UC Davis, которая работает по программе BrainGate2, публикует отчет: они подробно пишут про опыт использования внутрикортикального интерфейса «мозг-компьютер» для управления речью и курсором в домашних условиях в течение нескольких месяцев. Их 45-летний пациент с БАС за время исследования произнес 183 060 предложений.

#prosthesis | #brain | #readout
Nature Long-term independent use of an intracortical brain–computer interface for speech and cursor control Nature Medicine - An automated intracortical brain–computer interface, used at home with no researcher intervention, provides long-term and accurate restoration of speech-based communication...
  • ❤ 6
Post #336 1.09K
Шестой день после имплантации и первая запись в лабе

Сегодня мы увидели намного больше спайков. Мозг все ещё адаптируется к импланту. Записали спонтанную активностиь и также успели про стимулировать несколько электродов, однако пока что без фосфенов. Они должны появиться позднее, примерно на 2-3 недели.

Сделал фото: Antonio Lozano
Записал активность: Adrian Villamarin
Руководил процессом: Eduardo Fernandez (наш профессор)
  • ❤ 19
  • 🔥 13
  • ⚡ 5
Post #335 1.31K
Мы начали работать со слепым пациентом.

Напомню, что я в лабе уже чуть больше года и занимаюсь визуальными имплантами. Пару дней назад мы имплантировали электроды Utah array в визуальную кору новому пациенту. У нас теперь есть шесть месяцев на эксперименты.

Сегодня был первый день записи данных. Записали спонтанную активность с закрытыми и открытыми глазами. Сигналы пишутся, спайки есть, импеданс нормальный. Мы используем ripple stimulator.

P. S. На фото мой коллега и первые спайки. К сожалению, пока что не могу выложить с пациентом.
  • ❤ 32
  • 🔥 16
  • ⚡ 1
Post #334 880
Neuro embeddings of resting state 😅

Первый раз вижу такие колечки)

На самом деле в этих кольцах (маленьком и большом) в основном артефакты
  • 🤯 9
  • 🤓 5
Post #333 2.06K
The most tasty neuro papers in 2025

Мой личный, абсолютно субъективный список лучших статей по нейро-декодингу за 2025 год. Тренд года: кидай больше данных и молись чтобы стало лучше. Но главный вопрос по-прежнему в том, как объединить данные между животными, областями мозга и типами электродов в одной модели.

Разбил 10 статей на 4 секции: инвазивные сигналы, неинвазивные, нейро софт и напоследок принес статью из нашей лабы (я не соавтор, работа началась ещё до меня).

01. Invasive signals

▸ Foundation model of neural activity predicts response to new stimulus types
Foundation model trained on mouse V1 generalizes to completely new stimulus types (motion, noise, Gabor) and predicts cell types from MICrONS.
Nature 2025

▸ Neural Encoding and Decoding at Scale (NEDS)
One model does both encoding and decoding across 83 mice on Neuropixels/IBL data. Multi-task masking, SOTA on both directions, predict brain activity and behavior.
ICML 2025

▸ A cross-species neural foundation model for end-to-end speech decoding (BIT)
End-to-end brain-to-text: transformer pretrained on 367 hours of Utah array data (human + monkey), paired with audio-LLM. WER drops from 24.69% to 10.22%, transfers to imagined speech.
ICLR 2026

▸ A Generalist Intracortical Motor Decoder (NDT3)
Autoregressive transformer pretrained on 2000 hours of intracortical spiking from 30+ subjects. Beats from-scratch models when you have less than 1.5 hours of task data.
NeurIPS 2025

▸ OMiSO: Adaptive optimization of state-dependent brain stimulation
Closed-loop stimulation that uses pre-stim brain state to pick which electrodes to zap on a Utah array in monkey PFC. Adapts online, outperforms state-blind methods.
NeurIPS 2025

02. Noninvasive signals

▸ REVE: A Foundation Model for EEG
MAE on 60,000 hours of EEG from 25,000 subjects across 92 datasets. 4D positional encoding handles any electrode config. SOTA on 10 downstream tasks.
NeurIPS 2025

▸ LSM-2: Learning from incomplete wearable sensor data
Foundation model for wearables pretrained on 40M hours of day-long sensor data. Learns directly from incomplete recordings via learnable mask tokens, no imputation.
arXiv 2025

03. NeuroTools

▸ Kilosort4
Graph-based clustering with merging trees for spike sorting. Best across all conditions, handles low-amplitude neurons under high drift.
Nature Methods 2024

▸ Jaxley: differentiable simulation of biophysical neural models
JAX framework for biophysical neuron models with autodiff and GPU acceleration. Fit compartmental models orders of magnitude faster, trained a 100k-param morphological network on vision.
Nature Methods 2025

04. Our lab

⚡️ Neural correlates of phosphene perception in blind individuals: A step toward a bidirectional cortical visual prosthesis
Science Advances 2025


p.s.
Пишите в комментарии, какие работы я пропустил и должен был добавить в этот топ.
  • 🤓 7
  • ❤ 5
  • 🔥 4
  • ⚡ 1
Post #332 719
ReVision Implant получает FDA breakthrough

Бельгийцы из ReVision Implant получили FDA breakthrough device designation на свой Occular - кортикальный визуальный протез с 1000+ гибкими микроэлектродами прямо в visual cortex, минуя ретину и оптический нерв полностью. Первый trial в октябре 2026, полноценные испытания на слепых волонтерах - лето 2027.

link: https://www.massdevice.com/revision-implant-fda-breakthrough-vision-bci/
MassDevice ReVision Implant wins FDA breakthrough nod for vision-restoring BCI ReVision Implant announced today that it received FDA breakthrough device designation for its Occular visual cortical prosthesis.
  • 🔥 10
  • ❤ 2
Post #331 788
tasty aaai-26 papers

🔹 MindSight: Bio-Inspired Neural Architecture for Visual Restoration via Cortical Electrical Stimulation
tl;dr: система учится генерировать паттерны напряжений на электродах чтобы создавать нужные зрительные образы через стимуляцию коры. Протестировано на реальных макаках.


Запись с 1280 каналов V1, декодирование из 50мс окон MUA, предсказание тока на каждый электрод. Два пути обучения: через MUA декодер и через симулятор фосфенов. Минимум 16 каналов должны активироваться вместе на электрод (нашли через эксперименты с саккадами). Макаки с завязанными глазами различают формы на уровне нормального зрения и обходят препятствия.

💬 Пожалуй самая необычная работа с конференции. Не симуляция, не "мы показали что в принципе можно", а реальная штука, которая работает на приматах. 1280 каналов это серьёзный масштаб, и то что макаки реально навигируют и различают формы, это уже чуть больше чем proof of concept.

🔹 Multi-dimensional Neural Decoding with Orthogonal Representations
tl;dr: регуляризация через ортогональность латентного пространства для декодирования движений. Utah array, моторная кора макак, декодируют направление, позицию, скорость и ускорение одновременно.

Orthogonality loss разделяет латент на куски под каждый параметр движения. Голова классификации сессии, при переносе её веса используют чтобы выкинуть сессионные фичи. Cross-session 2-shot точность направления 72.6% -> 80.2%, cross-subject R2 скорости 0.592 -> 0.653. Ablation: только комбинация ортогонализации и головы сессии даёт эффект, по отдельности почти ноль.

💬 Пообщался с Kaixi на конфе, но всё равно не до конца понял зачем классифицировать сессию. По мне логичнее анти-классифицировать, то есть явно убирать всю инфу о сессии из представлений и стараться делать это во время обучения, а не после. В любом случае направление правильное, session drift одна из главных проблем в BCI.

🔹 MindCross: Fast New Subject Adaptation for Cross-subject Video Reconstruction from Brain Signals
tl;dr: реконструкция видео из мозговых сигналов с быстрой адаптацией на нового субъекта. Разделяют латент на subject-specific и subject-agnostic части.

Один shared encoder + N subject-specific энкодеров. Specific часть отвечает за особенности пациента, shared за семантику видео. При адаптации на нового субъекта обучают только его specific encoder.

💬 Я бы сделал ровно наоборот. Shared encoder должен давать session-specific информацию, а individual энкодеры, session-invariant фичи. У каждого человека мозг уникален, и именно индивидуальный энкодер должен маппить эту уникальную топологию в общее семантическое пространство. А ещё лучше, использовать LoRA для каждого участника и обучить мета-модель которая генерирует LoRA веса по resting state нового субъекта.

🔹 New Synthetic Goldmine: Hand Joint Angle-Driven EMG Data Generation
tl;dr: генерация синтетических ЭМГ данных по движениям пальцев для улучшения классификации жестов. Модель решает обратную задачу, придумывает активность мышц под заданный жест. Прирост 2-3% по точности.

💬 Я пробовал заводить синтетику несколько раз, и для ЭМГ и для МЭГ. Генерировать получалось, но прироста по качеству это не давало. Эта работа очередной раз доказывает что у меня просто руки не оттуда росли и надо пробовать ещё!
  • ❤ 7
  • 🔥 4
  • 🤓 3
Post #330 769
Что происходит в LLM. Февраль 2026

Несмотря на то, что LLM — главный хайп последних 2 лет, вокруг больших моделей остаётся много путаницы и заблуждений. Чем отличаются модели? Надо ли доучивать модель? Хостить или ходить по API? На что можно рассчитывать при построении агента или RAG-системы? Почему у кого-то работают RAG и агенты, а кто-то вовсе в них разочаровался?

Deepschool ответит на эти и другие вопросы на онлайн-лекции в четверг! За полтора часа вы получите актуальный срез индустрии вокруг LLM:
— актуальные модели и их свойства
— бенчмарки
— self-host VS API
— типы задач
— главные «болячки» ванильных решений
— и актуальные советы по их лечению

Спикер — Дмитрий Калашников, NLP Team Lead в Яндексе🔥

А ещё расскажут про курс «LLM», где вы узнаете, как устроены современные LLM, как их обучать, запускать и оптимизировать — всё под кураторством опытных инженеров.

Всем участникам лекции подарят скидки на обучение 🎁

Подключайтесь в четверг, 12 февраля в 19:00 МСК!

Регистрируйтесь по ссылке и приходите на лекцию в четверг!

#промо
  • 🔥 3
  • ❤ 2
Post #327 882
Впечатление от AAAI 26.

Я съездил на свою первую AI конференцию. Показывал нашу работу над визуальными имплантами на воркшопе AI for Neuro, общался с кучей людей, слушал доклады. Расскажу, как это было.

После года в Эльче (маленький город на юге Испании) Сингапур впечатляет. Всё сверкает, всё большое. Но за углом от небоскрёбов Hawker Center и Chinatown: грязно, шумно, вкусно. Еда отличная, погода с постоянными 30 градусами.

Конференция
Почти 5000 принятых статей. Огромные ангары с постерами, посмотреть всё нереально. Технические сессии и приглашённые лекции, честно говоря, не очень зашли. Что-то было слишком общим, а на технических сессиях многие спикеры просто читали с листочка. Намного полезнее подойти к постеру и поговорить с автором напрямую. Там и вопросы нормальные задать можно, и обсудить работу. Также неожиданно для себя встретил много ребят из России. Люди занимаются многими вещами: RL, пайплайны для агентов, NAS, предсказывают погоду и конечно generative AI.

Ещё интересная штука: разговорился с китайскими ребятами, которые делают motor decoding на обезьянах. Оказалось, только в Пекине сейчас 4 лаборатории, которые этим занимаются и конкурируют друг с другом. Так что BCI-статей из Китая в ближайшие годы будет сильно больше.

Воркшоп AI for Neuro
Главное событие для меня. Организовал Reza Abbasi-Asl с командой, и организовали отлично. Из спикеров больше всего зацепили Andreas Tolias (Stanford) и Martin Schrimpf (EPFL). Оба про одно: хватит играться с маленькими моделями, пора скейлить.

Запомнилась фраза Tolias:
"We don't have a choice. We should stop doing toy experiments. Train big models."


Он показал свою foundation model для зрительной коры, обученную на данных ~135 000 нейронов 14 мышей. При переносе на новое животное требует в 2-3 раза меньше данных, чем обучение с нуля. То есть можно реально ставить эксперименты in silico, а не каждый раз заново собирать данные. На канале Дарьи Клеевой есть подробный разбор.

Schrimpf показывал TopoLM, трансформер где у юнитов есть 2D позиция, как у нейронов в коре. При обучении модель сама организуется в кластеры, которые напоминают языковые зоны мозга. Мне это зашло, потому что идея простая: добавь spatial loss и получи brain-like организацию. У его лабы ещё вышла работа про scaling laws для brain-aligned vision моделей, по сути то же сообщение: масштаб работает.

Мой постер
Я показывал работу "Masked Autoencoders Learn Perception-Relevant Representations from Resting State Neural Data" на постерной сессии воркшопа. Если коротко: мы берём resting state данные (мозг просто "шумит", без стимуляции), делаем на них pretrain модели, и после этого она лучше предсказывает, что человек воспринимает при стимуляции зрительного импланта.

Про
планы
Пока мы готовимся к следующему пациенту для имплантации электродов, хотим набрать как можно больше данных, в том числе с обезьян, и наконец нормально отскейлить модели. Главная боль: данные плывут между сессиями, и модель с одного пациента очень тяжело перенести на другого.
  • ❤ 17
  • 🔥 9
  • ⚡ 2
  • 🤔 1
  • 🤯 1
Post #326 688

Forwarded from Chain-of-thought Unreasoning

Рад поделиться тем, что у команды частью которой Я являюсь, на HuggingFace вышел ТехРепорт по VLA, которая работает на разных роботах в том числе и нашем антропоморфном роботе - Грине (не китайском!). Если вкратце: за последний год стало ясно, что просто «навалить данных» уже не помогает. Чтобы робот перестал тупить в реальных задачах, нужно копать в сторону качества, переносимости между воплощениями и адаптацией в реальном мире

Что в отчете:
Выстроили многоуровневый пайплайн обучения: VLM (L0) -> SFT VLM (L1) -> претрейн VLA (R0) → SFT VLA (R1) → RL finetune (R2), где каждая фаза последовательно адаптирует модель понимать и действовать в физическом мире.
Унифицировали действия (R64): Сделали единый интерфейс для разных роботов. Использовали маскированный loss, для того чтобы разнородные пространства действий у воплощений не путали модель
Выстроили жесткий пайплайн работы с данными: Выстроили пайплайны фильтрации данных, оценки качества и разнообразия датасетов, оценки и выравнивания скорости движений в данных.
RL, JPM и OOD-detector: Научили роботов не просто копировать движения, а восстанавливаться после ошибок + обобщаться на абсолютно новые предметы без переобучения. И главное — вовремя останавливаться, а не «суетиться» после того, как задача уже сделана.

В итоге — SOTA на бенчмарках и отличная работа вживую на том же ALOHA, и нашем антропоморфном роботе - Грине. Внутри много «скучной», но важной инженерки, благодаря которой всё это реально работает, а не просто красиво выглядит на видео.

📌 Почитать можно тут: https://huggingface.co/papers/2602.00919

Наш сайт: https://sber.ru/robocenter

Резюме и предложения: @alex_postnikov26
@pdemen
(Можно написать мне если ребята не доступны:@Alexander_Nutalapati)

Будем благодарны за апвоуты и поддержку! 🙏
huggingface.co Paper page - Green-VLA: Staged Vision-Language-Action Model for Generalist Robots Join the discussion on this paper page
  • 🔥 7
  • ❤ 2
Post #325 514
Давайте поддержим ребят, они делают крутого робота гуманоида Грин!

Так ещё и рассказали как они его обучали!
Older posts →

About this channel

How can I read @neural_cell without a Telegram account?
TGViewer shows the public web preview Telegram publishes for the last neural cell: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does the last neural cell have?
the last neural cell (@neural_cell) has 1.45K subscribers on Telegram, refreshed roughly every 30 minutes.
Does the last neural cell know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →