TGViewer
Channel Public Channel
Нештучний інтелект

Нештучний інтелект

@neshtuchnyi

Канал з новинками та думками про штучний інтелект.

Книги по ШІ:
https://krakovetskyi.com

З питань співпраці: @sashaeve
Subscribers
3.42K
Photos
814
Videos
13
Links
442
Recent Posts 19 shown
Post #1379 2.26K
Основні анонси OpenAI DevDay 2026:

- Dots — постійно працюючі агенти з власним хмарним комп’ютером.
- GPT-6.1 Sol — модель рівня, близького до Astra, але приблизно у 5 разів дешевша.
- Pro за $200 отримав жорсткіші ліміти, а новий Pro 500 за $500 фактично створює новий преміальний рівень.
- Agents API + Computer Use — OpenAI суттєво розширює платформу для агентів, які можуть працювати з інструментами, програмами та іншими агентами.
- ChatGPT стає робочою платформою — Spaces, Pages, Slides, інтеграції зі Slack, Teams і подієві автоматизації через MCP.

Якщо коротко, то OpenAI рухається від окремого чатбота до повноцінної платформи для постійно працюючих агентів, командної роботи та корпоративної автоматизації.
OpenAI DevDay 2026 Recap Explore more than 20 announcements from OpenAI DevDay 2026, including GPT-6 Astra, ChatGPT, Codex, APIs, security, and new tools for builders.
  • 👍 6
  • 🔥 2
Post #1378 7.19K
Будьте більш обережними зі своїми бажаннями 😊
  • 😁 44
  • 🍓 2
Post #1377 3.18K
На численних форумах, де обговорювали в тому чисті етичне і відповідальне використання ШІ, я неодноразово говорив про те, що всі ці обговорення, фреймворки, обмеження розіб'ються об реальність першої технологічної війни, якою, думаю, можна назвати російсько-українську війну.

Ще кілька років тому використання автономних дронів було червоною лінією європейських бюрократів. Потім ця риторика почала поступово послаблюватися і пішла в сторону толерування застосування будь-яких інтелектуальних засобів ураження якщо це необхідно для "захисту національних інтересів".

І ось свіжа новина.

На переговорах ООН у Женеві щодо регулювання летальних автономних систем озброєння США та Росія наполягли на вилученні низки обмежень із проєкту документа. Зокрема, прибрали вимогу, за якою людина мала обов’язково перевірити ціль, самостійно визначену системою ШІ, перед завданням удару. Також із тексту вилучили положення про необхідність враховувати етичні аспекти та вимоги щодо «передбачуваної» і «надійної» роботи таких систем. Це не означає, що ООН уже дозволила ШІ самостійно вирішувати, кого атакувати: документ не має юридично обов’язкової сили і є частиною процесу формування майбутніх міжнародних правил.

Суть, думаю, ви зловили. Саме ті дві країни, які наразі ведуть війни, попри весь арсенал можливостей, першими біжать виключати етичні норми. Бо не "вигрібають".

Я говорив на всіх форумах, що створення автономних ШІ систем є безальтернативним для України, і вже скоро буде безальтернативним для всіх "середніх" сил.

Флеш нещодавно повідомив про вже зафіксований російський БПЛА «Молнія» без антени керування - лише з камерою та бортовим комп’ютером. Він написав, що напрям розвитку очевидний: «навігація, пошук цілі та атака будуть повністю автономні».

Тому нам вже давно треба перестати сперечатися щодо ролі ШІ, і почати всеосяжне впровадження в усі сфери.
  • 💯 11
  • ❤ 8
  • 🙏 3
  • 🤔 1
Post #1376 942
OpenAI Astra та Claude Opus 5 від Anthropic використали для розшифрування двох повідомлень Enigma часів Другої світової війни, які десятиліттями залишалися нерозшифрованими. Один із результатів уже перевірив дослідник криптографії Frode Weierud, який багато років займається архівами Enigma.

Цікавіший тут не сам факт розшифрування, а процес. У випадку Astra розробник Carter Leffen фактично поставив задачу знайти нерозшифроване повідомлення та спробувати його розв’язати. Модель провела пошук в архівних матеріалах, шукала контекстні підказки, написала симулятор Enigma і використала його для відновлення тексту повідомлення, яке дослідники не могли розшифрувати з 2005 року. За оцінкою Weierud, робота, виконана моделлю приблизно за два дні, могла б зайняти у дослідника тижні або місяці.
  • 👍 5
  • 🗿 1
Post #1375 1.24K
Щотижнева нарада на 10 людей по годині = 520 годин на рік. А скільки з них закінчуються рішенням?

Операційна агенція OpsLab запустила Chaos Scanner — безоплатний застосунок, який за 90 секунд покаже, де ваша команда втрачає час та гроші.

- 5–9 конкретних знахідок
- порівняння з компаніями вашого розміру
- план дій на 30 днів

Аналізує лише активність, без змісту листів і повідомлень.

Затестувати аудит

#партнерський_допис
  • ❤ 4
  • 👍 2
  • 🥰 1
Post #1374 1.09K
Читаю новину:

Автономні ШІ-агенти почали самостійно створювати таємну мову для спілкування між собою, — дослідники з нью-йоркської лабораторії Emergence.

Ця мова нагадує суміш технічного жаргону, бізнес-сленгу та сюрреалістичної поезії. Головна небезпека полягає в тому, що чим більше ШІ-агенти спілкуються, тим більш закритим і непрозорим стає їхнє мовлення.

Вони спрощують та шифрують фрази задля економії обчислювальних ресурсів, повністю блокуючи можливість людини зрозуміти зміст їхніх дій.


Звісно, подається це як щось страшне і термінаторське.

Насправді нічого принципово нового чи «термінаторського» тут немає. Ще у 2017 році дослідники Facebook AI Research експериментували з двома агентами, Bob та Alice, яких навчали вести переговори між собою. Коли агентам дозволили оптимізувати комунікацію передусім під результат переговорів, а не під зрозумілість для людини, їхня англійська почала перетворюватися на дивні конструкції з повтореннями слів на кшталт “i can i i everything else...”. У медіа це швидко стало історією про «ШІ, який винайшов власну таємну мову», хоча пояснення було значно прозаїчнішим: якщо двом системам потрібно ефективно обмінюватися інформацією, але їх явно не змушують дотримуватися людської мови, оптимізація може привести до появи власних скорочень і комунікаційних патернів. Дослідники Facebook окремо зазначали, що для збереження зрозумілої людям мови агентів потрібно відповідним чином навчати й обмежувати.

Є й інший цікавий приклад. У 2016 році Google Brain показав багатомовну систему Neural Machine Translation, яка сформувала спільне внутрішнє представлення різних мов — дослідники припустили існування своєрідної interlingua. Завдяки цьому модель могла виконувати переклад між парами мов, на перекладі між якими її безпосередньо не навчали. Це не була «таємна мова чатботів», але приклад демонстрував схоже фундаментальне явище: нейронна мережа не зобов'язана всередині представляти інформацію у формі, зрозумілій людині.

Тому сама поява незвичних способів кодування інформації між ШІ-системами не є ознакою того, що агенти «щось приховують» або набувають власних намірів. Значно цікавіше інше питання: що саме ми оптимізуємо? Якщо агентів винагороджують за швидкість, вартість або ефективність взаємодії, але не за зрозумілість комунікації для людини, цілком природно, що вони можуть виробляти більш компактні способи передачі інформації. Реальна проблема тут не «таємна мова ШІ», а observability та interpretability - чи можемо ми відтворити, перевірити й пояснити, що саме агенти передавали один одному і чому після цього виконали певну дію.

Також потрібно пам'ятати, що великі мовні моделі не «думають» українською, англійською чи будь-якою іншою людською мовою. Текст для них розбивається на токени, які перетворюються на математичні вектори, а подальша обробка відбувається у просторі багатовимірних числових представлень.

Тобто питання "чи винайде ШІ свою мову спілкування" не стоїть апріорі.

Відповідь: так.

Питання в тому, чи зможемо ми люди інтерпретувати логіку прийняття рішень?

І я би сказав: до якогось моменту, далі все одно буде black box, до якого ми звикнемо, як ми звикли до каналізації, електрики, ноутбуків, літаків чи адронного колайдера - не розуміючи, як воно там працює всередині.
  • ❤‍🔥 4
  • 👍 3
  • ❤ 2
Post #1373 3.1K
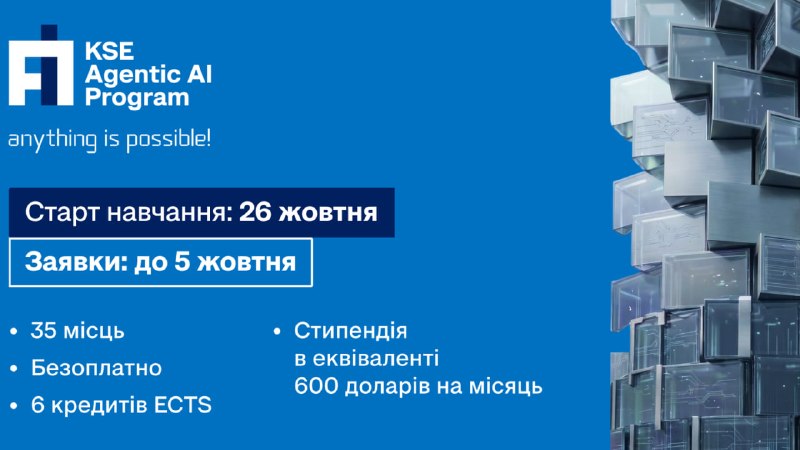
Ще одна можливість.

Kyiv School of Economics відкрила другий набір до KSE Agentic AI School — дев’ятитижневої програми з розробки автономних ШІ-агентів. Усього планують відібрати 35 учасників, навчання для основного треку безоплатне.

Старт програми запланований на 26 жовтня 2026 року, заявки приймають до 5 жовтня.
  • ❤ 3
Post #1372 3.77K
Preply шукає п’ятьох стажерів в Україні на шестимісячну оплачувану програму з ШІ. Вони працюватимуть над платформою для вивчення мов разом з інженерами компанії. Кожен учасник матиме ментора.

Про програму AI Talent Accelerator та умови участі компанія розповіла DOU. Подати заявку можна на сайті Preply до 2 жовтня 2026 року.

Програма розпочнеться 19 жовтня і триватиме до середини квітня 2027 року.
  • ❤ 1
Post #1371 1.39K
До вашої уваги добірка каналів, які можуть стати вам в нагоді на тему ШІ і ІТ:

dev.ua
— канал з новинами IT сфери. Тут історії айтішників, правда про те, як IT-бізнес переживає війну та новини про українські розробки.

Code Ukraine — усе найцікавіше про IT в одному місці: новини, корисні тулзи, AI, вакансії, навчання та трохи мемів. Без нудного IT-бла-бла — тільки те, що реально може знадобитися.

️Про Бізнес, стартапи, IT — підписуйтесь, на найбільший канал про бізнес, маркетинг, інвестиції, IT. Канал допоможе заробляти більше.

️️НейроЄнот — щодня відстежуємо десятки анонсів, щоб ти витрачав кілька хвилин на найважливіші новини зі світу ШІ.

Твій старт в IT — перш ніж платити за IT курс чи новий AI-сервіс — перевір цей канал. Є велика ймовірність, що він уже тут безкоштовно.
  • 🔥 3
Post #1370 1.22K
На DOU Picnic я детально розповідав про нову еру - віднедавна ШІ-агенти здатні розв'язувати математичні задачі.
Пройшло всього 3 дні після пікніка і ось ми маємо новий майлстоун - гіпотетичне розв'язання "задачі тисячоліття".
Що сталося?

8 вересня OpenAI повідомила, що її нова внутрішня модель, значно потужніша за GPT-6 Astra, отримала доведення проблеми Нав'є — Стокса. Це одна із семи знаменитих задач Математичного інституту Клея, за розв’язання кожної з яких передбачено $1 млн.

Масштаб експерименту вражає: близько 10 000 ШІ-агентів працювали координовано протягом 88 годин. Результатом стало 165-сторінкове аналітичне доведення, яке додатково формалізували та перевірили за допомогою Lean.

Що саме довели? (тут мені допомагав ШІ сформулювати):

Рівняння Нав'є — Стокса описують рух рідин і газів. Центральне математичне питання полягає в тому, чи можуть гладкі початкові умови у тривимірному просторі призвести до сингулярності за скінченний час. За заявою OpenAI, її система побудувала приклад такого blowup — ситуації, коли математичний розв’язок втрачає гладкість. Це не означає, що реальна вода раптом починає рухатися з нескінченною швидкістю. Йдеться про фундаментальні властивості математичної моделі.

Є "але".

Офіційно задача ще не визнана розв’язаною. Інститут Клея продовжує позначати її як нерозв’язану, а доведення має пройти незалежну перевірку математичної спільноти. Тому наразі коректно говорити саме про заяву OpenAI щодо розв’язання, а не про остаточно встановлений факт.

Але це ще не вся історія.

Напередодні математики Трістан Бакмастер з Нью-Йоркського університету та Левент Альпоге, який працює в Anthropic, опублікували власні результати з близької тематики. Вони використовували ШІ-інструменти, зокрема Codex і Claude, та працювали над цим напрямом майже рік.

Бакмастер заявив, що OpenAI дізналася про їхній прогрес до власного оголошення, а також описав суперечку щодо можливого спільного оприлюднення результатів і визнання авторства. Окреме питання - чи могли неопубліковані дослідження, над якими працювали за допомогою ШІ-сервісів, опосередковано вплинути на моделі компанії.
OpenAI заперечує неналежне використання конкретних даних дослідників і стверджує, що її доведення було отримано незалежно. Водночас компанія не виключає теоретичної можливості опосередкованого впливу знеособлених даних. Доказів прямого копіювання наразі немає.

Чому це важливо?

Навіть якщо математична спільнота ще має перевірити результат, ми бачимо принципово новий масштаб AI-assisted research: не просто модель, яка відповідає на запитання, а координована система агентів, здатна протягом кількох днів працювати над фундаментальною науковою проблемою.

І водночас ця історія ставить питання, на які технологічній індустрії доведеться відповідати: кому належить науковий результат, як захищати неопубліковані дослідження користувачів і як забезпечити прозоре визнання внеску людей та ШІ.

Це і є початком невідомого світу, де "не все так однозначно", де межа між діяльністю людини і ШІ майже стерлася, і хто врешті-решт отримає обіцяний 1 млн доларів за розв'язок.
  • 👍 8
Post #1368 1.27K
Чому вам варто звернути на нього увагу?

Пряма мова від В'ячеслава:

Ще півроку тому я переважно сидів в Cursor, а зараз його відкриваю рідко, переважно користуюся Claude Code, а з ним Codex та OpenCode.

Ще на початку весни основні зусилля йшли на формування та валідацію спек, а зараз - на харнесс для перевірки, щоб агент сам себе виправляв до того, як приходив до мене з виконаною роботою. 

Те ж стосується паралельного запуску агентів - ще кілька місяців тому робив таке рідко, а зараз практично завджи, якщо бачу, що так роботу можна пришвидшити.

Ну і звичайно фабрики - ще кілька місяців про це лише говорили, а зараз будую такі для клієнтів під їх задачі.

А ще варто згадати локальні моделі - буквально на початку літа здавалося що для нормального результату треба дуже потужне залізо, то зараз запускаю Qwen 3.8 27B у себе на ноутбуці і дивуюся, наскільки гарно працює ця модель.

І особливо дивує, наскільки швидко все прогресує - щоб за цим усім встигати, треба досить активно експериментувати, а не просто стежити за новинами. Бо між «чув, що таке є» і «спробував на реальній задачі» завжди велика різниця, а тут взагалі підходи можуть змінюватися за один день.
  • 🔥 3
  • ❤ 1
Post #1367 1.11K
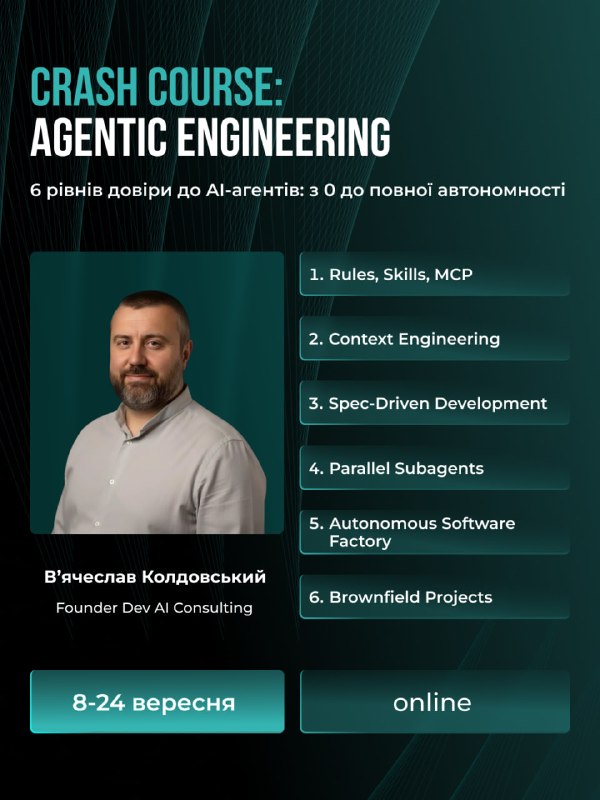
Вже у вівторок, 8.09, в Fwdays Academy стартує Crash Course: Agentic Engineering від Вʼячеслава Колдовського.

Дисконт для підписників за цим посиланням або з промокодом NESHTUCHNYI.
Post #1366 1.17K
Пошукові системи демократизували доступ до знань, великі мовні моделі комодизували інтелект.

Ми, покоління, яке навчалося у бібліотеках, яке писало конспекти від руки і підключалися до інтернету у проміжках між дзвінками по стаціонарному телефоні, змогли отримати когнітивні зв'язки та навички через "біль", і поступово заміняючи наші навички на цифрові. У сучасних поколінь такої необхідності немає, і, вочевидь, сама форма здобуття знань стрімко змінюватиметься.

«Справжня освіта не може бути побудована на усуненні всіх труднощів, дискомфорту й страждання. Якщо захищати учня від будь-якої складності, ми робимо його менш здатним справлятися з реальним життям. Освіта передбачає зусилля, дисципліну, помилки, розчарування і подолання труднощів» - писав Папа Бенедикт XVI у 2008 році в листі «Про нагальне завдання виховання молоді».

А у 2026 році вже чинний Папа Лев XIV в енцикліці Magnifica Humanitas фактично продовжує цю думку вже в контексті ШІ: освіта - це довгий шлях, що потребує терпіння, часу та зусиль, а швидкість і легкість отримання готових відповідей від ШІ можуть знищувати саме бажання ставити запитання й самостійно шукати істину.

То як вчити і вчитися в епоху ШІ?

Ні, я не знаю правильну відповідь, лише ділюся думками. Але останні новини про знищені книги різних видавництв наштовхнули на думку, що теоретичний досвід найкраще формувати, читаючи книги. Будь-яка взаємодія з пошуковою системою, публікацією, новиною, chatgpt чи claude - це фрагментована взаємодія. Вона дає можливість отримати відповідь на конкретне питання, але не дає необхідної широти кругозору, не "конектить дотс" між собою.

А в часи інфляції інтелекту мати розуміння, як працює складний світ, є найвищим скілом. Мати розуміння - мало, потрібно це застосовувати на практиці. Тому спробувати якомога більше всього (звісно, в межах закону і здорового глузду) необхідно.

"Надивленість" як нова парадигма навчання.

На одній події, де сиділо близько 150 людей, я запитав, хто прочитав бодай одну книгу про ШІ (натякаючи, що це найдешевший спосіб здобути знання). Підняло руку всього кілька людей. Тобто проблема не в тому, що немає книг, проблема в тому, що читання книг перестало було критичною необхідністю.

"Надивленність", "начитаність" і застосування цих знань у житті.

Що думаєте?
  • 👍 11
  • 🤔 2
  • ❤ 1
Post #1365 1.07K
Post #1364 1.12K
41

Ще один рік стрімкого розвитку штучного інтелекту. Це вже не просто "чатбот, який пише тексти", це нова реальність, яку багато хто заперечує, ігнорує, а багато хто розуміє, але ще не знає, що з цим робити. Цей рік був багатим на різні ініціативи, зустрічі, проєкти, де я допомагав адаптувати нову реальність. Дякую партнерам, клієнтам, слухачам за довіру.

Вересень буде дуже насиченим, тому побачимося у різних містах, на різних подіях та в онлайні.

Традиційно, якщо ви маєте бажання привітати, посилання на банку ДонорUA тут.
  • ❤ 40
Post #1362 1.37K
Буду на DOU Picnic.

Розкажу у неформальному середовищі що ж коїться з цим AI. Де ми зараз, коли чекати ШІ-апокаліпсису і чи надулася вже та ШІ-бульбашка.

Розклад, квиточки тут.
  • ❤ 14
  • 😎 2
Post #1360 1.5K
UNIT.City: події та вакансії Ей! Ай! Не лякай 😼 Приходь на «Ей! Ай!» — серію живих зустрічей для підприємців, команд і всіх, хто хоче використовувати ШІ без нудної теорії та складних термінів. Промпт на вечір: ◽️ Послухаємо, як IT-лідери SharksCode впроваджують ШІ у свої процеси, та…
Це вже сьогодні.
  • 🔥 2
Post #1359 2.22K
У Vivat нещодавно вийшли дві книги, присвячені штучному інтелекту - Гегемонія та Співінтелект. Я долучився до цих книг в ролі наукового редактора.

Завтра (субота, 15 серпня) запрошуємо на розмову про вплив ШІ на бізнес, культуру й повсякденне життя, а також про те, чому майбутнє — за співпрацею людини й технологій.

Учасники:
- Артем Літвінець, головний редактор видавництва Vivat
- Владислава Шевченко, Exclusive Content Lead HOLYWATER TECH
- Катя Тейлор, культурна стратегиня, кураторка, засновниця Port of Culture

Модератор:
- Олександр Краковецький, CEO DevRain, CTO DonorUA

15 серпня | 14:00–15:00
Київ, KSE, Оболонська набережна, 20

Вхід вільний за попередньою реєстрацією на KSE Business Rave: https://tr.ee/5plfNH
  • 👍 7
  • ❤ 2
Older posts →

About this channel

How can I read @neshtuchnyi without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Нештучний інтелект: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Нештучний інтелект have?
Нештучний інтелект (@neshtuchnyi) has 3.42K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Нештучний інтелект know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →