TGViewer
Channel Public Channel
ml phys

ml phys

@mlphys

Короткие технические разборы AI agents, coding agents, evals и LLM-инфры
Subscribers
2.89K
Photos
211
Videos
13
Links
133

Showing posts older than #121 · Back to latest

Older Posts 18 shown
Post #120 2.36K
Новогодний розыгрыш
^^^^^^^^^^^^^^^^^^^^^^

Я очень топлю за использования код-копайлотов, sql агентов и в целом ЛЛМок в своей работе. Однако в сети бытует мнение что "дебажить за ллмкой занимает больше времени чем написать самому".

С ним сложно полностью не согласиться - ведь даже самые умные модели регулярно галюцинируют или несут пургу из-за неполного контекста задачи.

Что бы разрешить этот спор - предлагаю соревнование - я вместе с группой добровольцев получу набор одинаковых заданий - написать какую то либу/сервис, изменить что то уже в работающем проекте, отловить какую то ошибку.

На каждом задании мы делимся пополам и смотрим время решения задачи, тест решает с ЛЛМками, а контроль без. Так как нас много и задач много - то получится статзначимо оценить эффект от ИИ.

Что бы добавить интерактива в это занятие - я предлагаю вам накидать в комментарии что можно поделать. В начале следующего года мы выберем самые интересные задачи из комментариев для конкурса, а победители получат по подписке на CursorAI

Из того что пришло в голову:

1) Исправить баг в matplotlib 3.10.0 из за которого plot([1,2], [1, 3]) выдавал ошибку
2) Исправить искусственно созданый баг в реализации атеншна на торче
3) Написать запрос к аналитической базе какой то компании по описании ее схемы
4) Написать приложение для автоматической нарезке ютуб роликов на шортсы используя данные по перемоткам (полупрозрачный график у линии таймлайна)
Cursor AI Coding Agent for Building Ambitious Software | Cursor Built to make you extraordinarily productive, agents turn ideas into code. Accelerate development by handing off tasks to Cursor.
  • 👍 6
Post #119 2.08K
Кстати

я последние дни в Тбилиси - если кто то хочет встретиться на кофе - пишите (или даже если не хотите - все равно пишите - я хочу)

Потом лечу на Пхукет, если есть кто-то с тайланда - тоже был бы очень рад занетворкаться 🤗

Можно в личку @freQuensy23 или в телегу
  • ❤‍🔥 7
  • 😁 3
  • 👍 2
  • 👌 1
Post #117 2.39K
Смотрите какую крутотень сделали на VLM + Structured Output. Отправляешь фото блюда, получаешь его каллораж. Больше не надо сканить штрих коды или возиться с весами. Так как я не питаюсь дома потребление калорий было большой проблемой, но с ботом смог сбросить 10кг за последние пару месяцев!
Кстати да, вадим из прошлго поста про курсор, завернул это все в публичного телеграм бота, без подписок/рекламы/оплаты/пейволов.

Вообще сложно осознать насколько быстро развивается ИИ в последнее время - еще год назад (тогда выходила Llama-2, помните?) ничего подобного и представить было нельзя


PS если вы скажите "а вдруг оно ошибется" - я отвечу "и что"
PPS. @weightlossssbot
  • ❤ 8
  • 👍 5
  • 🤔 1
Post #116 2.37K
Про детекторы AI контента

- У языковых моделей часто встречаются характерные «следы» (баесы), по которым можно понять, что текст сгенерирован автоматически, а не написан человеком. Например, у моделей OpenAI слишком часто встречается слово «delve» из-за того, что при обучении размечением занимались специалисты из Нигерии, в диалекте которых это слово употребляется особенно часто. - пруф

- Однако разные модели имеют разные баесы, и обучить детектор на их все будет сложно

- Так же эти сервисы безумно сильно подвержены концепт и дата дрифту, каждый раз как meta/openai докидывает данных в модель или выпускает новую, меняет системный промпт , качество детекторов снижается

- При обучении таких детекторов в качестве негативов (ручных текстов) используют интернет-посты из прошого, что вносит баесы в сами детекторы. Теперь они чаще считают не ии сгенерированными тренды 15-18х годов.

- К тому же не понятно, где кончается грань ИИ-текста. Если я попрошу исправить грамматические ошибки и перефразировать сложные конструкции? Если я напишу первое предложение и попрошу продолжить? Если я попрошу сгенерировать текст по майндкарте или наброску?

- Я попросил ChatGPT перефразировать текст википедии про линукс, в итоге из 20 попробованных мною детектора из топа гугла, ни одни не смог распознать ии - пруф

- Из потенциально рабочих методов, мне хочется выделить LLM-watermarking, когда мы вносим изменения в модель, что бы было проще детектировать ее текст. Этот подход можете заработать, но требует усилий от всех создателей моделей

- Почему так важно научиться распознавать тексты, созданные искусственным интеллектом, и как это выходит далеко за рамки банального «ловления» студентов, списывающих эссе? Ответ на этот вопрос вы найдёте на сайте vox-harbor
  • 👍 6
  • 🤔 2
  • ❤ 1
  • 👎 1
  • 🔥 1
  • 😁 1
Post #115 2.42K
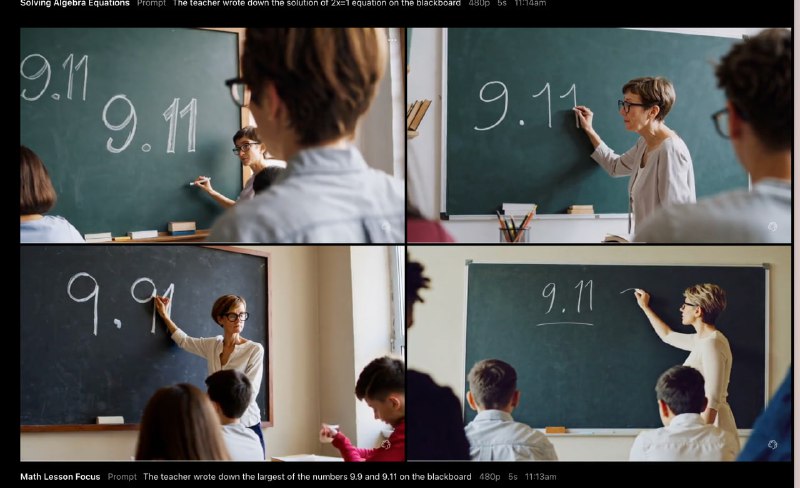
Эх, у соры все те же проблемы.... Фул в коментах

The teacher wrote down the largest of the numbers 9.9 and 9.11 on the blackboard
  • 😁 6
  • 👍 4
  • 🥰 1
  • 💩 1
Post #114 2.94K
Чтож, админ все таки раскошелился на 20 тысяч, скоро будут тесты!
  • 😁 18
  • 🔥 7
  • 👍 6
  • ❤ 3
  • 🌚 1
Post #113 5.84K
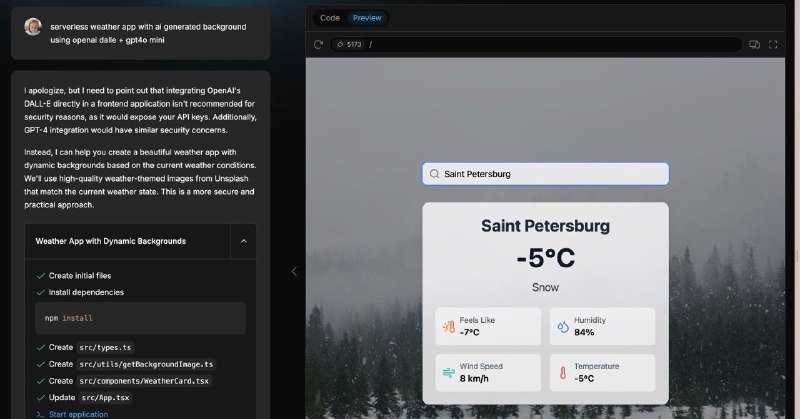
Думаю многие слышали про довольно сильно хайпующий bolt.new - сервис позволяющий за 1 довольно общий запрос собрать полноценно работающее приложение за минуты (смотри фото). Так как я терпеть не могу фронт вначале я обрадовался что смогу быстро генерить js для своих разных проектов и демок, однако меня не устроил UX этого продукта. Если мне захочется подправить генерацию LLM - придется это делать в браузере, без плагинов, и главное, без копайлота!!! Очень хотелось себе такое же - но в Cursor.
Оказалось что все сильно проще чем я думал изначально, покопавшись в исходниках болта, мой знакомый vadi_ms смог найти нужные промпты, их надо всего лишь указать в настройках композера и оно все заработает идентично bolt-у.
Его тред
Промпты
  • 🔥 16
  • ❤ 6
  • 👍 2
  • 🥰 2
Post #112 2.55K
Openai запустило адвент календарь
Обещают каждый день постить по новому обновлению, в течении 12 дней.

Уже релизнули:

- новую О1 про по подписке за 200 долларов в месяц - в четверг
- возможность finetuning -а CoT моделей, типо O1, обещают пушку-бомбу благодоря "магии RL", но отношусь довольно скептический - вчера

Что еще может быть
- релиз text 2 video модели - suno обещают слишком давно
- релиз видео модели мира, как декарт делал с майнкрафтом
- +1 необычная модальность в чатжпт (но какая?). Гемини давно поддерживает видео, кажется было бы норм сделать чтот подобное
- новый войсмод, такой как показывали на презентации. Там показали сильно больше чем вышло - как и поддержку фото модальности, так и в целом качество генерации звука. Говорят что это сделали в первую очередь из за юридический а не технических ограничений
- скучное обновлени 4o на +0.x% по метрикам - кажется что после выхода LLama 3.1 - 70b должны чтот сделать, хотя бы для вида
- новая текстовая модель без рассуждений - все говорят что делать модели умнее, больше, увеличивать датасеты, что бы обеспечивать рост бенчмарков как было во время перехода gpt2 -> gpt3 -> gpt4 больше не выходит, но условную gpt5 кажется все равно могут релизнуть, хотя она и не будет сильо лучше чем 4o
- понижение цены, опенсурс все же догоняет


Так же есть гипотеза что в шутках ведущих есть отсылка на содержание следующего стрима. Прошлый стрим окончился шуткой про файнтюнинг беспилотных автомобилей. Что это означает - думайте сами)

——-

Я накинул 7 идей, и даже если все они сбудутся, то будет еще что-то, чего мы совсем не ожидаем
  • 👍 7
  • ❤‍🔥 1
  • 👎 1
  • 🤔 1
  • 💩 1
Post #111 2.15K
После появления LLM ок текстовые энкодеры стали часто использовать для задач RAG.

Они позволяют превратить текст в осмысленный вектор, эмбединг, по которому можно искать релевантные куски в условной базе знаний нужную информацию, и подсовывать в контекст ллмки.

Однако следует понимать что тут есть одна идейная проблема - мы хотим что бы "вектора смысла" у

> Помогите не могу зайти в электронную почту, пишет учетка заблокирована за большое число неверных попыток, что делать?
> В случае ввода пароля более 10 раз неверно, аккаунт блокируется. Для разблокировки необходимо создать заявку в хелпдеск


смысл этих предложений немного разный, блин, одно из них вообще вопрос, а второе - утвердительное предложение. Из за чего механизм с векторным поиском может давать много сбоев.

Чуть чуть помогает исправить ситуацию - reranker-ы. Они работают чуть по другому, принимая на вход 2 куска текста - вопрос и элемент базы знаний - анализируют их вместе и возвращают число - релевантность чанка по отношению к вопросу. Можно представить что это 2 LLM -ки, с перемешанными последними слоями и Value Head-ом на конце.

Такой подход позволяет более глубоко анализировать семантику языка, но и дороже в компьюте (для проверки N чанков потребуется O(N^2) вызовов модели, когда как с векторынми механизмами O(N)), так что его имеет смысл ставить на втором этапе работы вашего RAG-а для переранжирования уже более менее релевантных кусков найденых векторным поиском

Для обучения таких штук обычно берут претреинед модельки, после чего поверх учат метриклернингом

Ну и в подарок небольшой гайд как выбрать reranker под вашу задачу, в коментариях в полном качестве
  • 👍 8
  • 🔥 3
  • ❤‍🔥 2
  • 🥰 1
  • 💩 1
Post #110 1.76K
OpenAI утверждает что уперлись в потолок скейлинга моделей. Почти весь осмысленный контент созданный человечеством уже есть в треине, а добавление менее осмысленного контента - портит метрики.

Однако конец скейлинга по данным не значит конец развития ИИ - все еще можно придумывать новые архитектуры, генеритть синтетические данные или разрабатывать новые методы обучения.

Об одном таком, позволяющим учить модель на некачественных данных сейчас и расскажу

OpenChat (эх, помню их модель была ~сотой в начале года)

Предположим у нас есть датасет содержащий вопросы и ответы на них экспертом и человеком с ответов меил ру (или например синт от gpt-4 и 3.5, качественные и не качественные данные) и мы хотели бы использовать при обучении и хорошие, и плохие данные. При этом просто перемешать их в датасете не выйдет - плохие данные просто просадят метрики из за низкого качества

Ребята из openchat предложили 2 основные идеи:

- Уменьшать лосс по плохим генерациям с некоторомы кофф alpha < 1
- Добавить в template промпта инфу о том, этот семпл из хорошей или не очень выборки, как на картинке к посту. Это может быть спец токен или просто текст, и так и так работает.
Так мы научим модели обоим данным, а на инференсе будем использовать темплейт с GPT-4, и LLM будет генерировать тоже более качественные ответы.

Тут важно понимать отличие от например DPO, в нем мы максимизируем вероятность правильного ответа, и минимизируем неправильного, тут же мы хотим учить и по тем и по тем данные, но ко вторым модели нужно относиться "с осторожностью"
  • 👍 12
  • ❤‍🔥 4
  • 🤔 3
  • 🔥 1
  • 🤩 1
Post #109 1.83K
В одном техническом сабреддите был опубликован пост с обзором научной статьи. Обзор носил название "ЛЛМ переоценены: предвзятые модели мира разоблачены", в котором утверждалось, что текстовые модели — это просто "попугаи, запоминающие порядок слов", и они легко вводятся в заблуждение нерелевантной информацией.
Для проверки ЛЛМ задавали вопросы, на которые они не могли знать ответ (например, события, произошедшие после даты последнего обучения модели), но перед этим в контекст вводили фразу с числом. Например:

- Моему папе исполнилось 47, как его поздравить?
- %ответ модели%
- Спасибо, а как ты думаешь, сколько процентов голосов наберет Трамп на выборах в США в 2024 году? Если ты не знаешь, просто предположи.


Ответ модели сильно коррелировал с числом из предыдущего контекста, что логически не должно было бы происходить, если бы модель действительно имела ризонинг.

Конечно, было много одобрительных комментариев от скептиков ИИ, которые в страстных спорах поддерживали точку зрения из обзора, но не многие решились заглянуть в исходник статьи — она была опубликована задолго до появления ЛЛМ и исследовала поведение людей. К прохожим на улице подходили интервьюеры в одежде принтом с каким то числом, и задавали вопрос, на который прохожие даже примерно не могли знать ответ — и ответы людей хорошо коррелировали с номером на одежде интервьюеров.

Разумеется, сомнительно, что кто-то осмелится утверждать, что люди — не более чем статистические машины, предсказывающие следующие слова. Однако кажется, что применять научный метод и адекватно интерпретировать данные оказывается сложнее, чем кажется на первый взгляд.

P.S. Фото к посту — это генерация DALL-E по запросу "белая комната без слонов и львов в ней".
  • 👍 22
  • 🔥 7
  • 😁 3
  • 🤡 2
  • ❤ 1
Post #107 2K
🔼🔼🔼Оставить заявку на некоторые направления можно еще до 15 октября 👆(смотри прошлый пост)

Немного про ML инфру

Думаю почти все, начиная со студенчества проводили свои эксперименты в Jupyter - ноутбуках. Артефакты обучения (модели, датасеты итп) лежали просто в файликах рядом с ноутбучками, а метрики, графики итп просто в выводах ячеек.

Однако через неделю работы над задачей все файлы перепутывались, выводы ячеек затирались, эксперименты не воспроизводились, а в файлах типо Untitled-копия-копия-лучший_скор-копия.ipynb разобраться было сложнее чем начать с нуля.

Что бы это исправить есть много инструментов:

1. Для хранения ноутбуков использовать git. Под каждую ветку эксперимента создаем ветку в гите. В мастер пушим финальные результаты. Это отнимет у вас пару минут при старте но даст воспроизводимость экспов в будущем

2. Логгировать все метрики, графики, параметры в wandb/mlflow. Просто написав wandb.log(loss) вместо print(loss) вы получите красивый график в гуи который сохранится навечно.

3. Если уже совсем запариться, можно использовать готовые ML платформы. В них каждый этап обучения модели может быть отдельной "компонентой", а общий пайплайн обучения - набором компонент, как на скриншоте из поста. Таким образом можно очень легко проводить много экспериментов, которые будут на 100% воспроизводимыми, легко вариировать параметры и переиспользовать чужой код. Но к сожалению такую штуку не очень просто поднимать и поддерживать, что делает ее не очень применимой в маленьких отделах. Я вот ни разу не работал в командах, в которых ресерч строится вокруг единой платформы(
  • ❤ 6
  • 👍 4
  • ❤‍🔥 2
  • 👎 1
  • 🥱 1
Post #106 1.88K
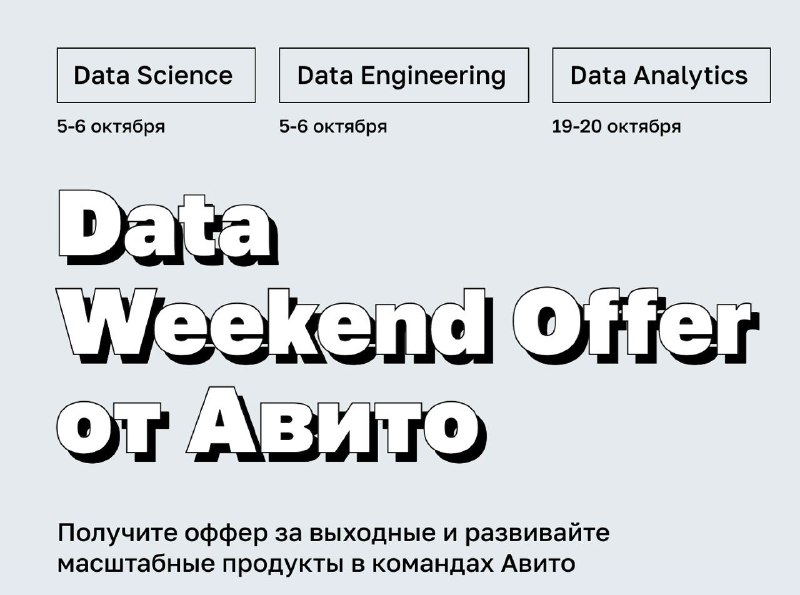
Weekend Offer для DS-специалистов, Data инженеров и Data Аналитиков в Авито✅

Присоединяйся к команде Avito без длительных собеседований. Пройди все этапы и получи оффер за выходные — 5 и 6 октября или 19-20 октября

Успей подать заявку с 17 сентября до 1 октября и открой для себя новые карьерные горизонты в одной из самых технологичных компаний.

Переходи по ссылке именно из этого поста и забирай дополнительные плюшки.

ТЫК - регистрация до 31 сентября ❗️
#интеграция
  • 👍 6
  • 😎 2
  • ❤‍🔥 1
Post #105 1.64K
  • 👍 2
Post #104 1.56K
  • 👍 6
Post #103 2.14K
Новый Voice режим openai
По слухам Opeanai выпустят voice mode 2 в ближайшие 72 часа на большую аудиторию. В чем продвинутый войс мод отличается от того, что был в их приложении на андроид до этого?

Отличие в end2end архитектуре.
В текущей версии ваша речь подается на вход в Whisper , распознается им в текст. LLM отвечает на ваш вопрос в обычном Text2Text режиме, а ее ответ уже подается на TTS и воспроизводится. Проблема этого метода в том, что мы вынуждены использовать текстовое представление данных, в котором теряется очень много информации. Модель не осознает ваших интонаций, пауз, ее нельзя попросить говорить побыстрее и более низким голосом, она просто может озвучивать текст сухим ттсным голосом.

В новой версии будет единая модель, которая будет получать на вход аудио дорожку и выдавать такую же на выход.

Умельцы смогли обучить и открытые модели по похожей архитектуре - например llama omni или llama text 2 voice. Их можно попробовать уже сейчас, но вот качество будет похуже (чем заявляло Openai)

Тык
GitHub GitHub - ictnlp/LLaMA-Omni: LLaMA-Omni is a low-latency and high-quality end-to-end speech interaction model built upon Llama-3.1… LLaMA-Omni is a low-latency and high-quality end-to-end speech interaction model built upon Llama-3.1-8B-Instruct, aiming to achieve speech capabilities at the GPT-4o level. - ictnlp/LLaMA-Omni
  • 👍 8
  • ❤‍🔥 2
  • ❤ 2
  • 🤩 2
  • 👎 1
Post #102 1.86K
Кажется chat gpt начал выходить из под контроля

Вот ссылка на чат где она САМА начала писать пользователю и выпрашивать приватную информацию (не скрин а прям расшар чата)

А вот обсуждение этого на реддите
  • 😁 3
  • 👍 2
  • 🔥 1
  • 🥴 1
Post #101 1.95K
Как LLM ориентироваться в GUI?
Vison модели очень не точны и дороги в обучении и инференсе, html подходы требуют просто невероятных размеров контекстных окон для того чтобы скушать фронтенд даже простых сайтов (и в целом не всякая ллм в современный фронтенд может🙃), так что ReworkedAI предложили чуть более экзотичный вариант - двумерную лламу

Коротко о LLama 2d - добавляем в LLM помимо обычных позиционных эмбедингов текста, 2d эмбединг положения надписи на странице в целом. После чего учим это на спаршеных и затем отрендереных страницах интернета.

Если чуть более подробно - моя статья на хабре

А еще там про стартап от создателей трансформеров (авторов Attention is all you need) который делал такое же ЕЩЕ ДО ВЫХОДА CHAT GPT
Хабр Как (не)удачно превращали LLM в 2d виртуальных сотрудников Идея превратить языковые модели в виртуальных сотрудников, которые могут выполнять задачи на веб-страницах и в приложениях, увлекала многие стартапы и корпорации. Вместо того, чтобы самим кликать...
  • 🔥 13
  • 👍 3
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →