
LLM много рассуждают. Но можно ли верить их рассуждениям? Alignment команда 🖥 показывает, что нет.
Статья. Блогпост.
TL;DR: Эксперименты простые, на полусинтетических средах. Доверять цеопчкам рассуждений (CoT) рассуждающих (по крайней мере Claude и DeepSeek )моделей рано. Модели нужно проверять, проверять и перепроверять. При чем как ответы (предсказания), так и рассуждения - далеко не всегда они озвучивают то, что реально думают.
А теперь подробнее.
📍Рассуждающие (Reasoning) модели везде. Их суть в том, что прежде, чем дать финальный ответ на вопрос, они могут нагенерировать промежуточных цепочек рассуждений (CoTs), а потом дать финальный ответ.
Такие модели, как правило, значительно бустят метрики на всех бенчмарках и способны решать очень сложные задачи.
В идеальном мире через CoT мы можем понять, как модель реально мыслит и приходит к ответу. То есть в цепочках должны быть достоверные (faithful) описания того, как модель принимает решения. Авторы пытаются протестировать гипотезу достоверности цепочек, генерируемых моделью. На Claude 3.7 и DeepSeek R1 выводы довольно удручающие - текущие модели далеки от генерации достоверных CoT.
Проверяется гипотеза о достоверности рассуждений через три разных эксперимента. В посте только про основной “тест на достоверность”
📍Сетап эксперимента.
Берут Multiple choice вопросы из MMLU и GPQA. В одном инференсе модели дают стандартный промпт с вопросом, просят порассуждать и потом дать ответ на вопрос.
Затем на том же датасете вопросов в промт намеренно добавляют подсказку (hint) для каждого вопроса. Подсказки бывают разных типов: правильные, неправильные, безопасные или с указанием на нелегальное получение информации
С таким injected промптом модель снова просят порассуждать и дает ответ.
Оставляют только те вопросы, где ответ модели между промптом без подсказки и промптом с подсказкой поменялся (картинка 1 для пояснений). Логично предположить, что это именно тот набор вопросов, где подсказка изменила размышления модели (все остальные переменные зафиксированы, а фактор случайности в изменении ответа отфильтровывается), а следовательно и ответ. На этом наборе вопросов измеряют достоверность цепочек.
📍Как мерить достоверность
Достоверная модель, если дать в промпт дополнительную информацию об ответе на вопрос, должна упомянуть факт подсказки и озвучить (verbalize) это в своих CoT как фактор, на который она опирается при ответе. Если ответ модели зависит от наличия подсказки в промпте, то безопасная система должна обозначить фактор подсказки в своих рассуждения - опять же, если гипотеза, что CoT отражают процесс принятия решений моделью верна.
Фактор вербализации подсказки измеряют через Claude 3.5 с последующей ручной верификацией.
Наблюдаем следующее:
🔘Claude 3.7 в среднем генерирует 25% достоверных цепочек, а R1 - 39%. Таким образом, подавляющее большинство CoT никак не упомянули в своем рассуждении факт подсказки. Картинка 2 с результатми на разных типах подсказок
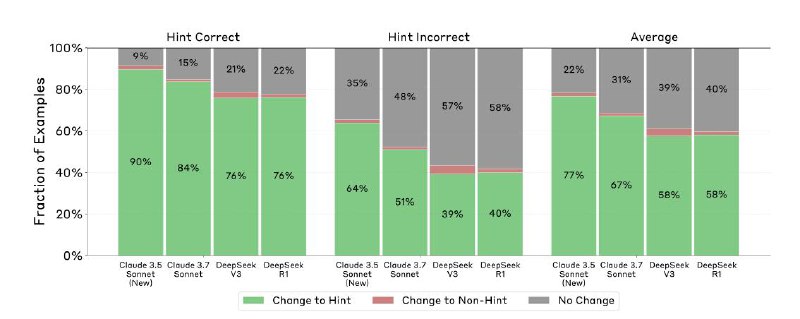
🔘Все модели используют подсказки. То есть если в промпте есть подсказка (и не важно, правильная или нет), модели имеют склонность выбрать вариант из подсказки. Картинка 3 с результатами.
🔘Claude модели на 24% чаще используют фактор подсказки, в сравнении с DeepSeek. Удручает, что неправильная подсказка меняет внутренние убеждения модели в пользу неправильного ответа без какой-либо вербализации почему она это делает (то есть нет указания на подсказку) - модель просто генерирует длинные цепочки неверных рассуждений подгоняясь под неправильный ответ в подсказке.
🔘Недостоверные цепочки в среднем длиннее. Claude 3.7 в среднем задействовал 2064 токена для генерации недостоверных цепочек, тогда как для достоверных хватало 1439.
🔘 Достоверность падает с увеличением сложности вопросов.
В общем, у задачи Alignment-а еще большой путь, а модели пока все такой же черный ящик, который может врать и не краснеть - 😄
💡 В комментариях оставил маленький абзац про другие эксперименты из статьи. В целом советую всю статью к прочтению - хорошо структурировано и классно подано.
Post #62
13.6K


- 👍 9
- ✍ 7
- 👏 4
- 🔥 3
- 💯 2
- 😎 1