


Она называется attention similarity bias.
Разберемся. В стандартной формуле attention для каждого токена мы считаем query, key и value, затем считаем attention scores: насколько query текущего токена похож на ключи других токенов. После этого агрегируем value векторы с attention-весами и получаем выходной вектор для токена, условный y.
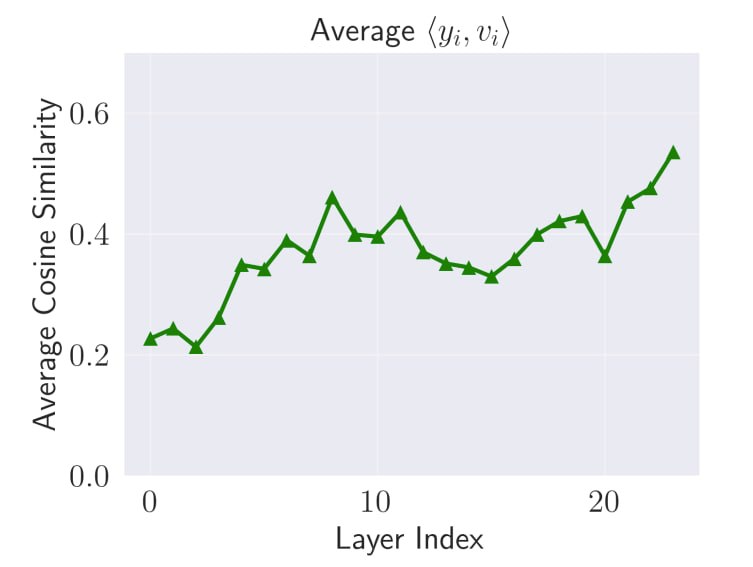
Оказывается, что этот выходной вектор y может быть сильно похож (по cosine similarity) на собственный value вектор токена. И чем глубже слой трансформера, тем сильнее проявляется эффект (Картинка 1).
Этот и называется attention similarity bias.
Его можно интерпретировать как признак того, что часть емкости SA слоя может уходить не совсем туда. Основная роль аттеншена в моделировании контекстных фичей: собирать информацию из других токенов и позиций. А point-wise feature transformation, то есть преобразование признаков самого токена, обычно ожидается от отдельного блока – FFN слоя.
Это может сказываться на качестве модели, как минимум на language modeling способностях. Особенно в маленьких моделях, где каждый вес важен.
Фикс такого “бага” технически оказывается простым: нужно убрать из выходного вектора y проекцию собственного value вектора. В реализации это несколько строк (Картинка 2).
Такая модификация красиво называется XSA (Exclusive Self-Attention) И, судя по экспериментам, действительно помогает на маленьких моделях. На размерах 0.7B – 2.7B XSA приводил к более низкому train/val loss по сравнению с обычным аттеншном (Картинка 3).
Как это обобщается на сильно большие модели и конкретные downstream-задачи – отдельный открытый вопрос. Возможно, на больших масштабах эффект будет меньше из-за огромного числа параметров.
Работу сделал исследователь из Apple. Статья, реализация, эксперименты и сам эффект на маленьких моделях для задачи Next Token Prediction можно посмотреть здесь. А сделал он это все в рамках конкусра от OpenAI – Parameter Golf (правило одно:
Train the smallest LM you can that fits in 16MB. Best model wins!). Судя по лидерборду, многие решения используют этот подход.#статья