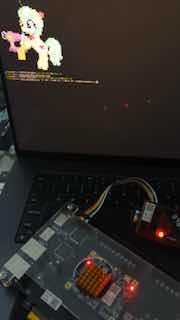
Тут вся работа свелась к тому, чтобы attention перестал быть последовательным куском логики, потому что именно он съедал большую часть циклов.
Первое что переехало это сами matvec'и. Раньше matvec_fp16 ел по одному int8-весу за такт через 8-битный weight bus, и QKV с proj шарили этот bus через мультиплексор. Сейчас стоит matvec_fp16_w32 (и w16 для head_proj), который читает по 32 веса за такт из своего weight_store, а qkv и proj получили свои отдельные банки и могут работать параллельно, не толкаясь за один порт.
Дальше пошел score внутри attn head (Q*K). K cache отдает 4 fp16-позиции за одно чтение, над ним стоят четыре fp16_mul, которые делят один q_head[dim], и за такт получаем 4 произведения Q*K вместо одного. Дальше эти произведения нужно складывать по dim, и тут возникает обычная для fp16-арифметики проблема: fp16_add имеет 4-тактную обратную связь, и если складывать в один аккумулятор, то получается одно сложение раз в 4 такта. Поэтому вместо одного аккумулятора стоят 16 fp16_reduce_k8 в 4-way ping-pong (4 позиционных lane'а на 4 фазы pair_idx). A берет каждый четвертый quad (0, 4, 8...), B следующий (1, 5, 9...), C (2, 6, 10...), D (3, 7, 11...). Пока A досчитывает свой quad, B уже принимает следующий, потом C, потом D, и к моменту когда снова доходит очередь до A, его 4-тактная задержка уже прошла. Так держится throughput одно сложение за такт на lane.
AV устроен похоже, четыре fp16_mul читают 4 V-вектора из одного 64-битного чтения, дальше balanced add tree и один аккумулятор av_acc[d].
Самое жирное это параллелизм между attn heads. Инстансов softmax два (u_sm_a для четных, u_sm_b для нечетных), и за ними два ping-pong attn_buf'а. Score sub-FSM и AV sub-FSM крутятся независимо: пока AV ест выходы attn head N из attn_buf_a, score уже стреляет dot-product'ами для attn head N+1 в u_sm_b, который пишет в attn_buf_b. K и V в кэше имеют раздельные адреса чтения ровно для этого, чтобы score (читает K) и AV (читает V) не дрались за порт. Pipeline depth ограничен через scored_count - av_done_count <= 2, чтобы score attn head N+2 не начал перезаписывать буфер, который AV еще читает для attn head N.
Из мелкого еще дописал нормальный сэмплер вместо argmax'а: логиты умножаются на inv_temp с repetition penalty, уходят в softmax, top-k выбирается через compare tree, дальше multinomial draw через CDF-walk. Источник энтропии 16-битный Fibonacci LFSR (потому что Mersenne Twister и Philox на один сэмпл в такт это перебор для такой модели мне было лень).
Тащем-то, ответ на главный вопрос: “сколько токенов”? Эта чилслодробилка выдает примерно 1100 токенов в секунду на 854k W8A16, но потенциально может и больше, если добавить еще параллельных вычислений и обработки весов за раз
Марков цепи пропилRed eyes is all you need, или пихаем LLM в FPGA Вдохновился недавней новостью, о том, что LLM зашили в железо, и решил попробовать повторить в меньших масштабах, написав проект на verilog, где ~854K модель зашивается в Artix-7 (XC7A200T). Задачей было уложиться…
Продолжение red eyes is all you need
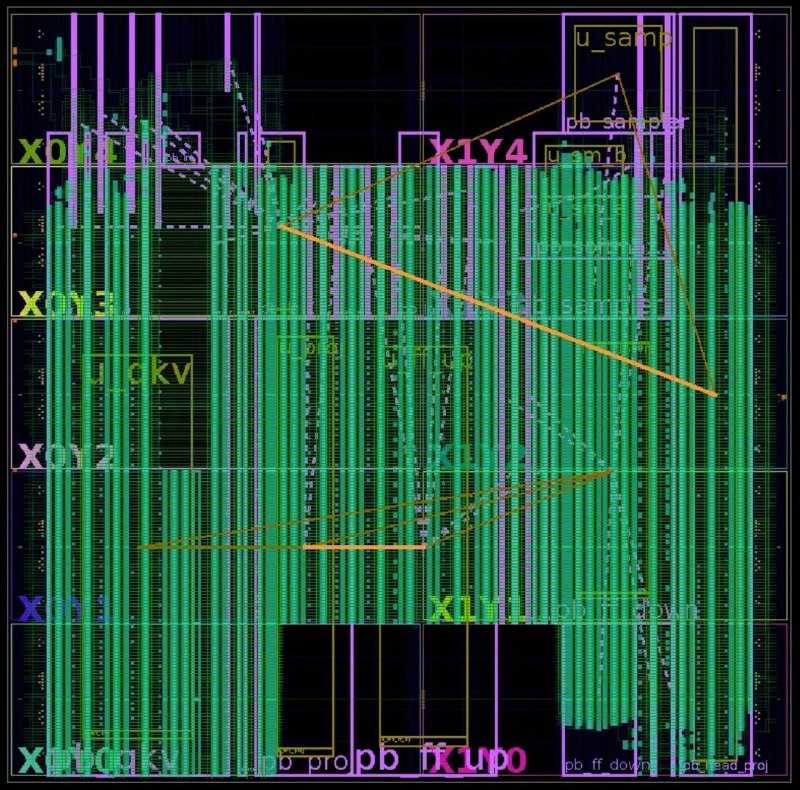
В общем, глобально было два пути оптимизации этого исчадия: через увеличение тактовой частоты железки и через уменьшение tokens per cycle. Первое в самом начале решалось простым раскидыванием регистров в нужных местах, но со временем я уперся в тот факт, что один большой BRAM модуль с весами слишком медленно доставляет данные из-за физического положения (веса/активации нужны многим модулям, и сам путь до нужного модуля занимает слишком много времени). Поэтому пришлось дробить на кучу блоков + конфигурировать все модули в свои pblocks.
Идея в том, что place&route по умолчанию раскидывает логику по кристаллу как ему удобнее, а удобнее ему обычно не там, где надо, и clock tree synthesis потом героически пытается развести тактовый сигнал через всю эту кашу. Если matvec u_qkv оказался в одном углу, а его weight_store в другом, то на трассы между ними уходят те самые наносекунды, из-за которых слайсится тайминг. Поэтому каждому matvec'у выделяется своя территория с примерно нужным количеством SLICE/DSP/BRAM, и его weight_store селится туда же.
Нижняя половина кристалла (X0..X145, Y0..Y149) поделена на четыре вертикальные полосы под четыре w32-matvec'а внутри transformer_layer: u_qkv в X0..X41, u_proj в X42..X69, u_ff_up в X70..X109, u_ff_down в X110..X145. Каждый pblock включает и сам matvec, и парный к нему weight_store, чтобы трассы от выхода weight_store (256 бит на u_qkv/u_proj/u_ff_up/u_ff_down, 128 на u_head_proj) не тянулись через полкристалла. Размеры полос пропорциональны размеру весов: pb_ff_up жирнее pb_proj по BRAM, потому что ff_up хранит 512x128 против 128x128 у proj, и так далее.
Head projection ушел на правый край (X146..X163) во всю высоту кристалла, потому что он живет в transformer_top, и его удобно держать на отшибе - он шарит tok_emb с embedding lookup, и весь этот weight-tied кусок логически отдельный. В верхней половине (Y150+) поселились остальные. Слева ln_f (X0..X100), правее в полосе X100..X145 живут u_sm_a и u_sm_b в одном pblock'е (чтобы оба softmax'а были рядом со своими ping-pong буферами), а сэмплер сидит в той же X-полосе сверху и снизу от softmax'а - в Y150..Y169 и Y211..Y249, обтекая его.
Благодаря этому удалось достичь Fmax ~98.8 MHz и зафиксировать рабочую частоту на 95 MHz
В общем, зарелизил исходники proxy-only для iOS [тык]. Может кто-нибудь захочет накидать свой пет-проект с полноценным VPN через NetworkExtension.
Так как телемост закрыл DC туннель - оптимизировал VP8 подход: на тесте скорость выросла с 1.5mbps до 6mbps. В теории можно выжать еще больше, но оно становится менее стабильным из-за congestion control. Плюс исправлен ряд минорных багов вроде 401 при попытке создать headless звонок в creator-app'е на винде.
В ближайшее время новых релизов не планируется - хочу передохнуть и позаниматься чем-нибудь другим. Если в новом релизе что-то поломалось/отвалилось - пишите в [конфу канала]. Попробуем отдебажить и я обновлю имеющийся релиз
Могу только дропнуть в виде исходников с режимами headless-only и proxy-only. Не знаю, насколько долго система позволит этому решению жить - оно находится в бэкграунде благодаря хаку с односекундным WAV-файлом, состоящим из нулей. Ну и еще система не дает стабильно биндить проксю на определенный порт, поэтому он из раза в раз может слегка отличаться. Но вроде оно работает (по крайней мере на ios 16) + нет необходимости в NetworkExtension
Добавил headless creator'a для телемоста + пофиксил ВК, чтобы в случае разрыва звонка сервером оно автоматически переподключалось по созданной ссылке.
Так же перелопатил архитектуру, чтобы окончательно перенести webrtc стэк из WebView в Go. Теперь работа в бэкграунде должна быть стабильнее, так как андроид будет менее агрессивно урезать ресурсы. В идеальных условиях (хорошая связь, близкое расположение к серверам/creator'у) получилось достичь довольно неплохой скорости.
Плюс добавлен режим proxy-only с настройками логина/пароля.
Правда, капчу для присоединения к звонкам ВК все так же нужно проходить. Может потом что-нибудь придумаю.
- Корпоративное жильё - сотрудники и их семьи жили в защищённых корпоративных анклавах, изолированных от опасностей улиц - Медицинское обслуживание - доступ к высококачественной медицине, включая кибернетические улучшения за счёт корпорации - Безопасность - личная охрана и защита от уличной преступности - Юридическая защита - корпоративные адвокаты и иммунитет от многих городских законов
Работа на корпоратов в реальности:
- Возможность взять однушку в ипотеку в СберСити - Возможность посмотреть ютуб через корпоративный ВПН (наверное)
Марков цепи пропилПока железки в пути, решил заняться насущным вопросом, который в последнее время что-то обострился.
Про дальнейшее развитие проекта и канала
Изначально я начал заниматься темой блокировок, потому что мне было нечего делать по вечерам в ожидании железа, которое мне нужно для дальнейшего ботанья hardware + ML штук. Вчера оно доехало, и я понял, что не смогу одновременно изучать интересные мне вещи и активно контрибьютить в опенсорс: сейчас я уделяю проекту по 5-6 часов в будние дни и по 12+ в выходные.
Кроме того, мне не очень хочется превращать личный блог в релиз-ноуты. Поэтому я планирую проработать в таком режиме еще пару-тройку недель чтобы доделать необходимые фичи, поправить критические ошибки/недоработки и стабилизировать кодовую базу (за это время там появилось много спорных/кривых/слоп решений, так как понимание общей картины приходило по мере написания). После чего оно перейдет в стадию ленивой поддержки, а я вернусь к ботанью, щитпостингу, разборам интересных мне статей, и, скорее всего, к мыслям о новых пет-проектах
Добавлена поддержка headless creator'a (пока только для ВК). С флагом moderate он у меня отъедал 45-50мб ОЗУ => можно закинуть на какую-нибудь слабую VPS'ку. Работает он в одном процессе, и умеет переключаться между режимами DC и data over video "налету" - достаточно поменять режим в joiner'e и переподключиться по той же ссылке на звонок. Для работы ему нужно подсунуть куки ВК, которые можно экспортнуть нажатием кнопки из десктопного приложения. Так же обновлен интерфейс бота - для того, чтобы он применился нужно обновить десктоп и отправить ему какую-нибудь команду.
И, по класские, спасибо за реквесты, а релиз [здесь]
Ого, ты переименовал свой ТГ канал на 100 подписчиков в "ГЕИ АСТАНЫ" и пошутил про "у вас списки белые"? Какой ты смешной. Закажешь мне еще цезарь с креветками?
"Мы оптимизировали наш key value storage, добавив в него механизм Stochastic Access-Time Load Balancing. Теперь при попытке запросить объект с перегруженного сервера, мы будем отдавать случайный объект с наиболее свободного сервера. Эта инициатива позволила IT-компании сэкономить миллионы рублей на инфраструктуре" - прокомментировал ситуацию техлид
 МА