#kubernetes #azure #troubleshooting
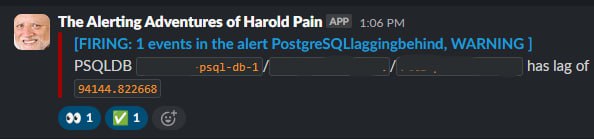
Материал уровень крепкий джун(на который я тут не потянул, лол, самоуверенное овно)Никого не трогаю, прилетает алёрт.
"Лаг между репликами на Patroni кластере в кубере".А я дежурный, блин. Ладно.
Сам алёрт вида
- alert: PostgreSQLlaggingbehind
  expr: pg_replication_lag_seconds{} > 7200
  for: 5m
  labels:
    severity: warning
  annotations:
    summary: "PSQLDB `{{ $labels.pod }}`/`{{ $labels.cluster }}`/`{{ $labels.namespace }}` has lag of `{{ $value }}`"
Делаю свич на кластер кубера, NS, вижу поды.
Никаких рестартов, никаких ООМираний.
Лезу внутрь пода, смотрю
patronictl list
0 - мастер, 1 и 2 - реплики. Лаг в 900 мегабайт на каждой реплике.
Пытаюсь сделать реинит для 1 реплики.
patronictl reinit clustername instancename
Впервые в жизни вижу ошибку - нет соединения, спустя минут 15 ретраев всё отваливается питоновскими ошибками.
Ок, пытаюсь повторить со второй репликой, через 15 минут тот же ответ.
Ладно,
семь бед - один ресет.
Мастер трогать нельзя, ребутаю POD-ы c репликами.
После рестарта снова попытка реинициализации - таймаут.
Хм. Просто так делать failover с 0 инстанса на 1 или 2 нельзя в данном случае - у нас везде лаг и мы может грохнуть то, что не надо.
Мастер так же не хочется рестартовать, я уже с этой ложки ел.
Окунаемся в логи: да, прям внутри каждого пода смотрю журналы, ошибки, файлики.
Нет ничего. Таймаут. Да как так-то.
Ныряю выше, на уровень кластера: ивенты кубера, состояние нод, на каких нодах данные поды запустились.
Смотрим нетворк полиси и прочие типичные радости кубера. Нет ничего, что мешало бы.
Да все ок, ивенты пустые, все поды патрони кластера с БД на одной нод группе.
Проверял даже наличие свободных IP адресов в кластере AKS. Всё есть.
Посидел ещё минут 20 с логами и пошёл писать в общий чат "спасити памагити".
Спустя время коллега пишет "сорри аймсорри, это я".
Оказалось вот что у нас было разделение на нод группы. Часть прожорливого перенесли на отдельные нод группы (Trino, AirFlow etc).
По стечению обстоятельств туда, на эту "edge" нод группу, по аффинити прилетел тот кластер Patroni.
Делаем быстро исправление типа такого(это
внутренний модуль террагранта)
# Allow Security rule in NSG (allows communication between pods on edge node pool)
resource "azurerm_network_security_rule" "edge_asg_allow_pod_to_pod_rule" {
  count                        = local.edge_node_pool_exists ? 1 : 0
  name                         = "allow-pod-to-pod-edge-asg"
  priority                     = 960
  direction                    = "Outbound"
  access                       = "Allow"
  protocol                     = "*"
  source_address_prefixes      = azurerm_subnet.edge.address_prefixes
  source_port_range            = "*"
  destination_address_prefixes = azurerm_subnet.edge.address_prefixes
  destination_port_range       = "*"
  resource_group_name          = "${var.kubernetes_cluster.name}-nrg"
  network_security_group_name  = data.azurerm_resources.nsg[0].resources.0.name
}
План, апплай(а что вы мне сделаете?), МР, аппрув, мерж.
Трафик начал ходить между подами внутри нод группы, лаг мгновенно пропадает, проверяем через
patronictl list
Алёрт через минуту окрашивается зеленым
resolved.
Итог:
- не стоит быть самоуверенным "синёром", если мне белым по чёрному пишут, что нет сетевой связности между подами - ну проверь, блин, дебаг контейнер кто-то отменял? Ну кто виноват, что я селюк и не знал про существование asg rules между подами в одной нод группе AKS, только я сам и виноват.
- девопс это не всегда про пайплайны, иногда это про общение. Надо общаться с коллегами и знать про подобные изменения.
* Да, у нас 99% баз данных в кубере и мы с этим живём хорошо.