Задача про градиентный спуск
С помощью градиентного спуска, как известно, можно обучать различные модели машинного обучения. Верно ли, что классический градиентный спуск всегда найдет глобальный минимум функции потерь и выдаст оптимальные параметры?
Ответ: нет, неверно.
Решение
Посмотрим на формулу градиентного спуска (картинка 1)
По основному свойству градиента с каждым следующим шагом метода мы будем двигаться все ближе и ближе к минимуму функции потерь Q, что хорошо. Но нет гарантии, что мы придем именно в глобальный минимум, а не застрянем в локальном(картинка 2).
Кроме того, градиентный спуск будет испытывать трудности в точках перегиба функции, ведь в них градиент тоже равен нулю, и метод может остановиться вблизи этой точки.
Еще одна причина неудачи метода — неверный выбор градиентного шага.
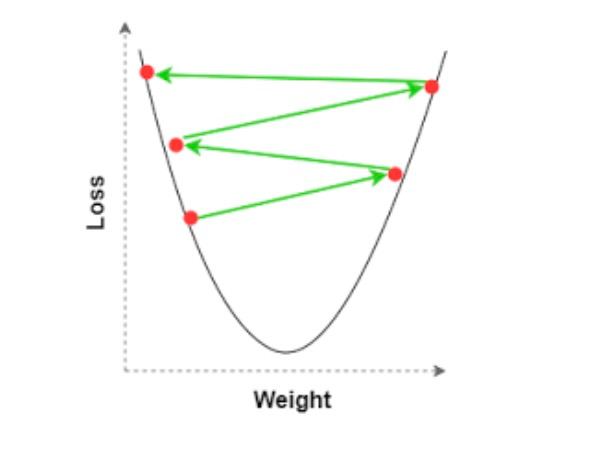
Например, при очень маленьком градиентном шаге метод будет идти в сторону минимума слишком медленно и остановится просто из-за ограничения на число итераций, не дойдя до него. А при слишком большом градиентном шаге метод может не попасть в минимум и «прыгать» вокруг него до тех пор, пока не остановится из-за ограничения на число итераций. Иногда метод при большом градиентном шаге может даже разойтись.
В классическом машинном обучении мы почти не сталкиваемся с описанными проблемами, но вот в Deep Learning этих проблем достаточно. Для их решения придумано множество модификаций градиентного спуска.
@machinelearning_interview
Post #385
3.71K


- 👍 15
- 🥱 9
- ❤ 5
- 🤡 3
- 🔥 2