
LongCat-AudioDiT - новая SOTA диффузионная TTS-модель от Meituan.
Модель генерирует речт напрямую в латентном пространстве аудиоволн (waveform latent space), без авторегрессии → меньше накапливаемых ошибок.
Ключевое:
Архитектура: Wav-VAE + Diffusion
Размеры: 1B и 3.5B параметров
Языки: китайский + английский
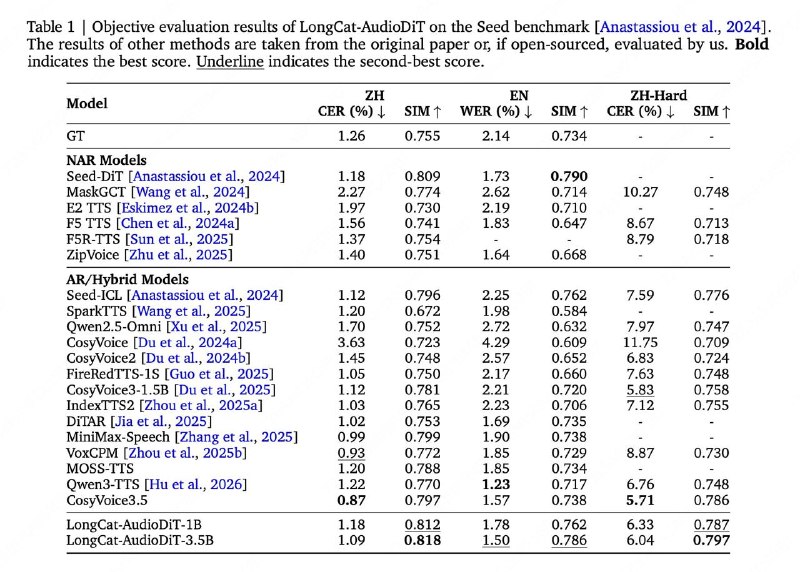
SOTA по клонированию голоса (SIM: 0.818 / 0.797 на Seed-ZH / Seed-Hard)
Алгоритм APG вместо CFG — лучшее качество и естественность звука
Решена проблема несоответствия обучения и инференса в диффузионных TTS
Неочевидный вывод: лучший VAE ≠ лучший TTS
📄 Tech Report: https://github.com/meituan-longcat/LongCat-AudioDiT/blob/main/LongCat-AudioDiT.pdf
🐙 GitHub: https://github.com/meituan-longcat/LongCat-AudioDiT
🤗 Hugging Face: https://huggingface.co/meituan-longcat/LongCat-AudioDiT-3.5B
Post #2658
4.3K


- 👍 8
- ❤ 5
- 🔥 1