
📌 Microsoft Research и Salesforce показали проблему, о которой редко говорят: диалог резко снижает надёжность LLM.
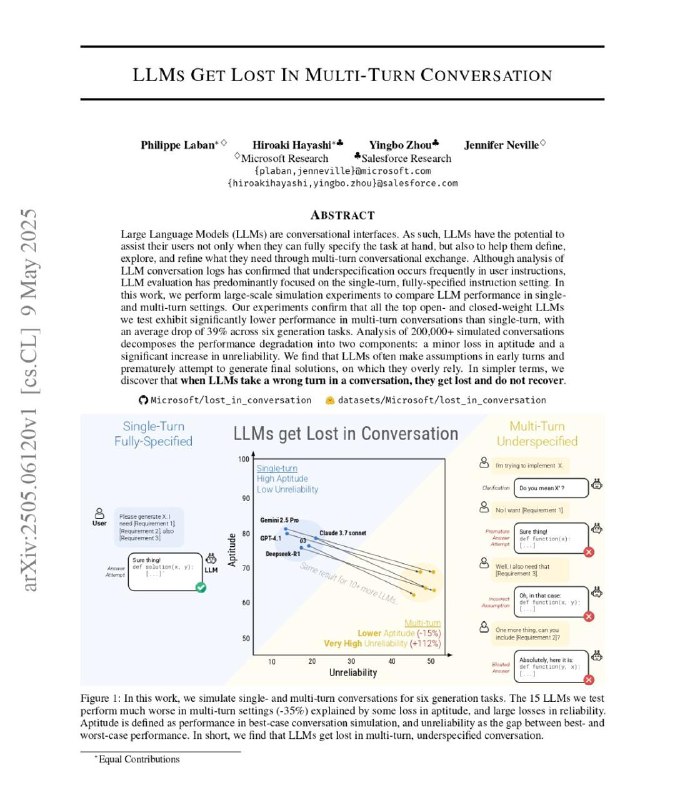
В исследовании протестировали 15 топ-моделей (GPT-4.1, Gemini 2.5 Pro, Claude 3.7 Sonnet, o3, DeepSeek R1, Llama 4) на 200 000+ симулированных разговоров.
Результат:
- Один запрос → ~90% качества
- Многотуровый диалог → ~65%
Важно: дело не в «умности» модели. Способность решать задачи снизилась всего на ~15%.
Главная проблема — надёжность: количество ошибок и сбоев выросло на 112%.
Почему диалог ломает модели:
- Модель начинает отвечать до того, как вы дали полный контекст
- Первое неверное предположение закрепляется и тянется дальше
- Теряется часть информации из середины разговора
- Длинные ответы добавляют новые допущения → растёт вероятность ошибок
Что не помогает:
- reasoning-модели (o3, DeepSeek R1)
- больше «thinking tokens»
- температура = 0
Практический вывод:
Если нужна стабильность, давайте весь контекст, требования и ограничения одним сообщением, а не через длинную переписку.
Большинство бенчмарков тестирует single-turn в идеальных условиях.
В реальных диалогах надёжность падает у всех моделей и это критично для AI-агентов и продакшена.
https://arxiv.org/abs/2505.06120
Post #2579
4.24K
- 🔥 21
- 👍 8
- ❤ 2