
یه روش جدید به اسم MiCA یا (MinoCA Component Adaptation) به کتابخونه PEFT هاگینگفیس اضافه شده و نتایجش چشمگیره.
ایده اصلی
تکنیک LoRA روی بخشهایی از مدل تمرکز میکنه که بیشترین استفاده رو دارن. MiCA برعکس عمل میکنه — روی فضاهای کمتر استفادهشده (minor singular subspace) تنظیم میکنه تا دانش جدید جذب بشه بدون اینکه دانش قبلی از بین بره.
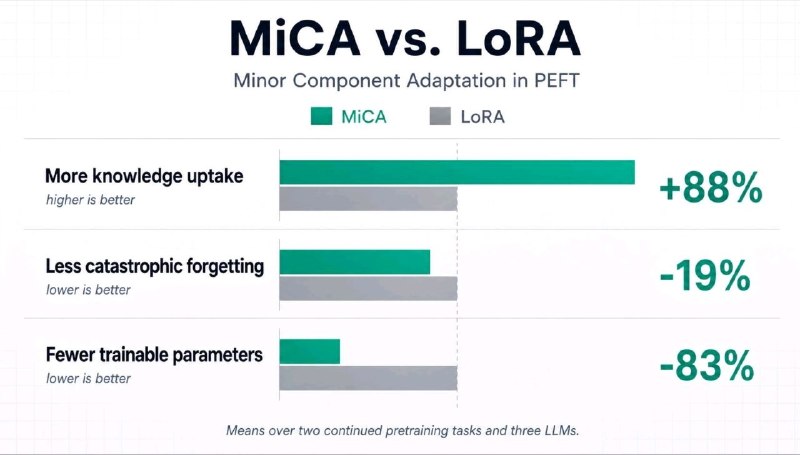
نتایج روی ۳ مدل مختلف:
📈 +۸۸٪ یادگیری دانش جدید نسبت به LoRA
🧠 -۱۹٪ فراموشی فاجعهبار (Catastrophic Forgetting)
⚡ -۸۳٪ پارامتر قابل آموزش
استفاده ازش سادهست. فقط یه خط تغییر کافیه:
init_lora_weights="mica"کاربرد اصلی:
بهخصوص برای continued pretraining و domain adaptation — جایی که میخواید مدل دانش جدید یاد بگیره ولی تواناییهای قبلیش رو حفظ کنه.
🔗 لینکها:
📄 Paper (arXiv): https://arxiv.org/abs/2604.01694
🤗 HuggingFace: https://huggingface.co/papers/2604.01694
💻 PEFT Example & README: https://github.com/huggingface/peft/blob/main/examples/mica_finetuning/README.md