
Задачка для ИТ-профессионалов (ОТВЕТ)
Ответ на задачку выше:
1. Действительно, как уже предположили в комментариях, первой версией была история с бэкапами. Систему резервного копирования не так давно ревизировали, так что можно было предположить. В итоге - анализ временных окон из расписания системы резервного копирования и инцидентов с просадкой дисковой системы по времени не совпадали - версию отмели.
2. Дальше под прицел попали конкретные хосты. Как вы помните сперва заметили на конкретных серверах проблемы. Проверили есть ли ошибки на конкретных hba-адаптерах FibreChannel. Ничего не выявили, разве что прошивки попробовать обновить. Решили искать дальше
3. Дальше стали анализировать уже сами СХД, нет ли деградировавших RAID-групп, нет ли просадки на бэкенде по дискам, нет ли переполнения и сброса кэша, не загружены ли процессоры контроллеров.
СХД показали себя молодцом, нагрузка хорошая на них шла, но запас по прочности и производительности вполне себе был достаточный.
А количество жалоб при этом продолжает расти...
4. Перешли к FibreChannel фабрике, той самой, с помощью которой серверы подключаются к СХД. Запустили анализаторы и коллекторы логов. Ну а дальше - внимательное чтение подробных отчётов и таблиц.
В итоге, в фабрике обнаружилось аномально большое количество отброшенных фреймов.
Выявили сбойную пару портов - это оказался транк между двумя коммутаторами одной фабрики.
Круг сузился 🙂.
Осталось два варианта - или SFP-модуль FibreChannel, или потрескавшийся патч-корд.
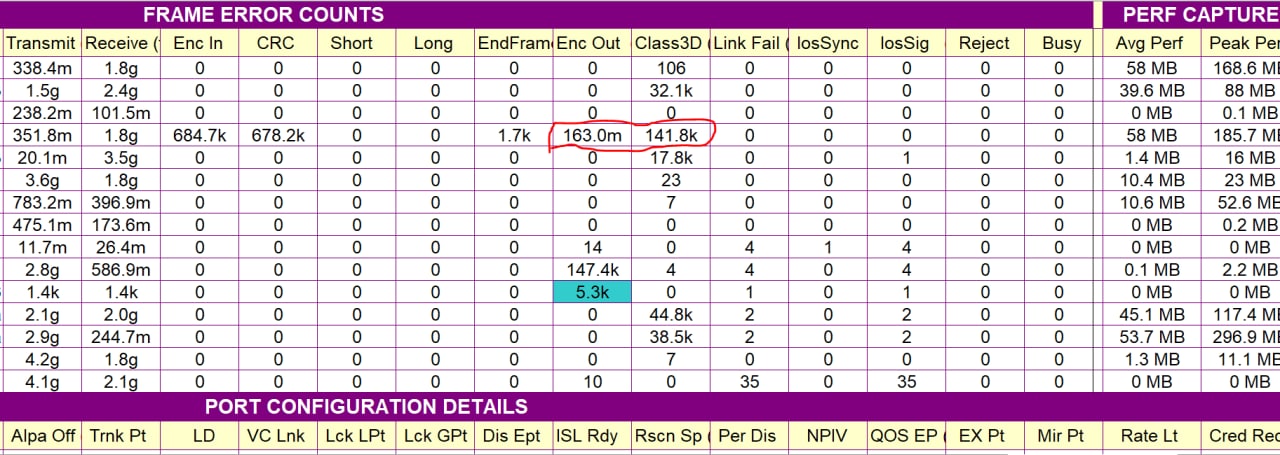
Ниже скриншот ошибок на выявленном порту, за 5 минут их набегало 200 тысяч 😣
Красным выделил пару параметров, которые позволяют точно понять в чем проблема. Если ошибки только в одном параметре - это патч-корд. Если в обоих, то смотри SFP-модуль.
В итоге капризная дама, мадам SFPшка, была найдена и заменена.
Как видно было из графика, производительность кардинально улучшилась. Фото героини ниже. Модуль не вышел из строя до конца, поэтому фабрика не отработала второй путь и ошибку не сгенерировала.
Вот такая небольшая мелочь в уязвимом месте сгенерировала проблем для нескольких сотен виртуальных серверов. Мелочи важны, главное их знать и успевать за ними следить. 😉
Post #29
141
- 🔥 1