Продолжим разбирать кабанчика? («Высоконагруженные приложения» Мартина Клепманна)
В восьмой главе рассматриваются проблемы, которые могут возникнуть в распределенной системе.
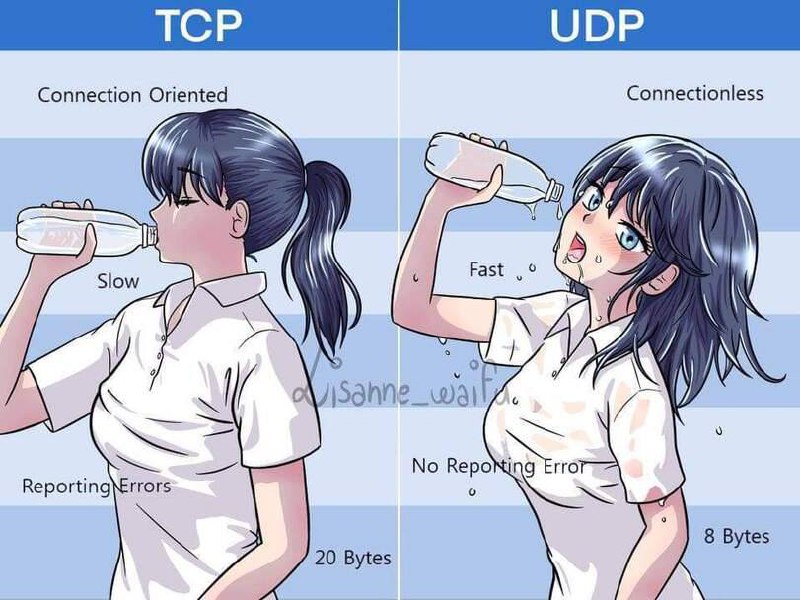
В первой части главы рассказывается про сети, поэтому в конце поста я нашла для вас пару мемов про отличия транспортных протоколов.
В распределенной системе некоторые части системы могут перестать работать совершенно непредсказуемым образом, хотя остальные продолжают нормально работать. Такая ситуация называется частичным отказом (partial failure).
При разработке нужно учитывать возможность частичных отказов и добавлять механизмы обеспечения отказоустойчивости.
Ненадежные сети
Внутренние сети ЦОДов и сам Интернет — это асинхронные сети пакетной передачи данных. В таких сетях узел может отправлять сообщения (пакеты) другим узлам, но сеть не дает гарантий, когда они будут доставлены и будут ли доставлены вообще.
Если мы отправили запрос и не получили ответ, то не знаем, почему так произошло:
🔹 потерян запрос?
🔹 не работает удаленный узел?
🔹 потерян ответ?
Во многих системах необходимо автоматически обнаруживать, что какой-то узел отказал.
Например:
➡️ балансировщик нагрузки должен прекращать отправлять запросы узлам, которые не отвечают
➡️ в распределенной БД при репликации с одним ведущим узлом в случае его сбоя нужно «повысить в ранге» один из ведомых узлов до нового ведущего (глава 5 про репликацию)
Обычно для обнаружения сбоев используют способ с ограничением время ожидания. По истечении этого времени вы перестаете ждать ответ и считаете, что он вообще не будет получен.
Если ограничение времени ожидания — единственный надежный способ обнаружения сбоев, то насколько коротким оно должно быть? К сожалению, простого ответа на этот вопрос не существует.
😵💫Длительное время ожидания означает, что нужно долго ждать, прежде чем объявить узел вышедшим из строя и все это время пользователи должны ждать или видеть сообщение об ошибке.
🫠 Более короткое время ожидания позволяет быстрее обнаруживать сбои, но и повышает риск ошибочного объявления узла вышедшим из строя, в то время как он просто временно замедлил темп работы, например, вследствие пика нагрузки в узле или в сети.
Преждевременное объявление узла неработающим способно потенциально привести к проблемам: если узел на самом деле работает и как раз выполняет какое-либо задание, а это задание будет передано другому узлу, то оно может оказаться выполненным дважды.
При объявлении узла вышедшим из строя необходимо делегировать его обязанности другим узлам, что увеличивает нагрузку на них и на сеть. Если окажется, что узел на самом деле работал, но медленно отвечал вследствие перегруженности, то передача его обязанностей другим узлам способна привести к каскадному сбою.
✅ В подобных средах время ожидания подбирается экспериментальным образом, то есть оценивать время отклика за большой промежуток времени и на множестве машин, чтобы определить ожидаемую задержку.
⭐️Или даже лучше: вместо того чтобы использовать заранее заданное время ожидания, система может непрерывно измерять время отклика и и автоматически подстраивать под него время ожидания. Для этого есть специальное ПО.
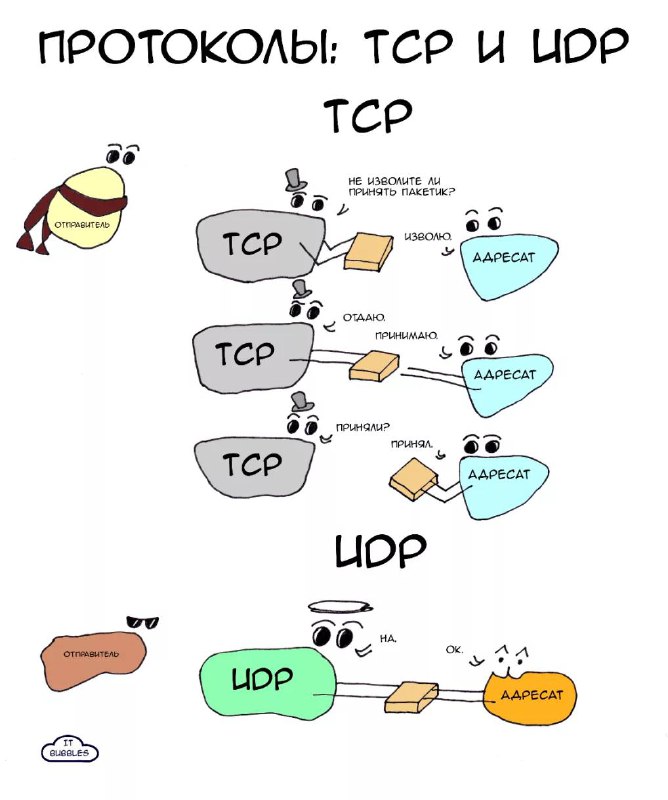
Здесь уместно сказать об отличии транспортных протоколов TCP и UDP.
✅TCP является более надежным, поскольку следит за потерянными пакетами и отправляет их повторно. Для того чтобы считать пакет потерянным как раз используется время ожидания ответа, рассчитываемое на основе наблюдаемого времени отклика.
✅В UDP нет повторной отправки потерянных пакетов, за счет этого он работает быстрее, но может потерять часть данных. UDP имеет смысл выбирать в случаях, когда запоздавшие данные теряют всякую ценность. Например, для стриминга видео или онлайн-игр.
#кабанчик #сисдиз
Post #108
1.55K

- 🔥 10
- ❤ 7
- 👍 7
- 😁 5
- 🐳 1