TGViewer
Channel Public Channel
Чайник из Юты

Чайник из Юты

@irrationalthings

Не смешно
Subscribers
121
Photos
216
Videos
3
Links
144

Showing posts older than #150 · Back to latest

Older Posts 20 shown
Post #149 59
Ну и чего оно мне вот этот вот текст некрасивый рисует. Причём исключительно под виндой
Post #148 50
Ого, к полю с типом types.DefaultHeaders (newtype от []string) можно спокойно присваивать результат функции с типом []string
Post #147 49
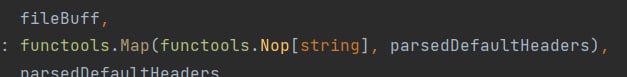
У меня во фреймворке постепенно начал вырисовываться пакет functools. Да, именно с функциональными штучками - с дженериками, такая штука очень даже может существовать, как оказалось, даже в го. И этим очень удобно пользоваться! Во всяких мелких деталях, например, "применить на каждый элемент слайса функцию". Или, например, скопировать слайс, как на пикриле🤭
Post #146 47
Встретился с выбором: а реализовывать ли https и ограничение на максимальное количество подключений с одного ip-адреса. С одной стороны, веб-фреймворк этим заниматься не должен, а должен реверс-прокси. С другой - такой подход теряет в самостоятельности. То есть, если условно какому-нибудь проекту понадобится сервер для вебхуков (привет фреймворкам для телеграм-ботов), никто тащить в поставке нжинкс не будет. Заставлять пользователя его ручками настраивать - и подавно.

А что об этом думаете вы?
Post #145 88
Продолжая тему предыдущего поста, я хочу рассказать, как я пришёл к тому, чтобы переписать парсер под безусловные переходы и получить до 2х буста производительности

Для начала, стоит рассказать, как у меня этот самый парсер вообще устроен. Кратко - это обычный for-range по слайсу байт, и вложенный большой свитч по состояниям парсера.

Занимаясь предельной оптимизацией парсера (в который у меня всё по итогу и упирается), я додумался, что вместо того, чтобы при каждой итерации делать свитч по состоянию, я могу воспользоваться тем, что состояние обычно редко меняется (проход по пути запроса, ключу/значению заголовка, etc.), а значит, свитч в теле цикла у меня лишний. А свитч-то не маленький, на 32 состояния.

Подумал, и решил вынести независимые циклы по слайсу байт в кейсы свитча по состояниям. И тут я столкнулся с проблемой: я в парсере сохраняю негласную конвенцию о написании кода - практически везде, где нужно сравнение байта с 1 и более вариантов, я пишу свитч. А как известно, break в свитче прерывает этот самый свитч. А мне надо прерывать также цикл. Идея использовать if-else цепочку меня категорически отталкивает.

И тут я вспомнил о безусловных переходах! Панацея, подумал Штирлиц. И начал вставлять лейблы в парсер. Как оказалось позже, это вам не шахматы, тут думать надо. Решил проблему кардинально: убрал полностью главный цикл, свитч по состояниям вынес в начало функции для того, чтобы исходя из последнего состояния, сделать переход в нужную часть кода. Для "одноразовых" участков (участков, которые сразу же меняют состояние дальше), правда, пришлось немного покопипастить, но в целом терпимо. Запустил бенчмарки - парсер стал от 14% до 300% быстрее. Великолепно, подумал Миллер
Post #144 73
Безусловные переходы

...или просто goto. Ненавистная, однако, штука у разработчиков!

Но почему же? Да потому, что в далёкие и бородатые времена, у программистов не была столь развита культура написания кода. Соответственно, народ бывало переборщивал с безусловными переходами, в следствии чего мы получали отменный спагетти-код, сваренный в аль-денте.

Но ведь сейчас всё не так, сейчас такого не будет, верно? А вот и нет. Программы, построенные на безусловных переходах, легко превращаются в goto hell: это когда непонятно, что и куда идёт.

Но ведь goto hell можно не допускать, если ты знаешь, что ты делаешь, верно? Да, абсолютно верно. Но количество кейсов, где не прибегая к гото, нам приходится костылить жуткий код с булевыми флагами, столь мизерное, что люди стараются не использовать эту штуку совсем с тех пор, когда появились процедурные языки, позволяющие писать Тьюринг-полные программы, не применяя безусловные переходы.
Post #143 76
//go:nosplit

Думаю, все мы знаем про safe- и unsafe-участки функций. Вкратце - unsafe-участком функции считается участок, находясь в котором, гц не может очищать мусор (иначе получим кровь кишки). Такие места также называют "атомарными"

Также все мы знаем, что находясь в unsafe-участке, шедулер не может переключать горутину - даже при условии, что время пришло. И всё, что делает nosplit - указывает компилятору, что функцию не следует прерывать по таймеру. Каким образом? Тело функци целиком помечается, как unsafe-участок
Post #142 77
У меня тут память текла. И текла очень ощутимо

Текла она от подключений. А точнее даже - после их закрытия, она не освобождается. Первым делом начал грешить на таймеры в tcp сервере - я их там на каждое чтение создавал. Починил, просто обнуляя один таймер на клиента каждый раз. Сервер стал выдавать на ~10к рпс больше, но проблему это не решило

Почитав пару статей об утечках памяти, подумал - а у меня ведь 3 горутины на клиента, и все они общаются по каналам. Ну, думаю, точно где-то какая-то горутина в дедлоке остаётся. Поставил маркеры на выход из каждой горутины

И - да! Две горутины нормально себе завершали выполнение, кроме одной - httpServer.requestProcessor. Она ответственена за то, чтобы когда ядро уведомляет её о готовности запроса, она вызвала обработчик, и при окончании работы которого оповестила обратно ядро

При отключении клиента, ожидалось, что в ядро прилетит nil-слайс, и, соответственно, проверка у нас была if data == nil {}, которая слала сигнал об отключении нашей httpServer.requestProcessor. Посмотрев в tcp сервер, оказалось, что при дисконнекте, он передаёт просто пустой слайс 😃

Поменяв буквально одну строчку кода, проблема утечки памяти решилась. А вот профайлером пользоваться стоит
Post #141 61
Раз уж заговорили за бету, то держите ликбез о семвере

Semver - semantic versioning. Суть данного подхода к версионированию состоит в том, что у нас есть три разряда - major.minor.patches.

Инкрементируем patches, когда сделали изменения, не добавляющие ничего нового для пользователя - внутренние изменения, не влияющие на использование. Например, оптимизация, или фикс баги

Инкрементируем minor, когда добавили новую фичу, которая НЕ ЛОМАЕТ обратную совместимость - изменения, влияющие на удобство пользования, но не ломающие существующий пользовательский код. Например, добавили новый метод для класса, делающий какую-нибудь полезную работу

Инкрементируем major, когда добавили новую фичу, которая ЛОМАЕТ обратную совместимость - изменения, ломающие существующий пользовательский код. Изменение поведения, которое может сломать существующий код, также должно инкрементировать major-версию

К семверу иногда также добавляют build number (обычно это то самое страшное пятизначное число), добавляется оно, как ещё один разряд версии - major.minor.patches.build-number

Но не номером билда едины, так ведь? А мы докинем ещё tag!. Фактически, это те самые alpha, beta, prerelease, release, и как их там только не называют. Докидывают их через слэш, major.minor.patches[.build-number]-tag

Стоит упомянуть, что при инкрементации старшего разряда, принято обнулять младшие. Но учитывая страшные пятизначные build number, не все любят обнулять все младшие разряды

А, ну и любят докидывать префиксом v - v1.0.0, например.

ПыСы: гитхаб не любит вариант v.1.0.0, лучше пишите без точки между v и мажорной версией, предпочитая v1.0.0
Post #140 54
Вот значения заголовков у меня лежат в одном-большом пространстве, все вместе. Это решает проблему с уменьшением аллокаций, и убирает надобность в обжект пуле (реализация которого всё равно была бы сложной, либо сам обжект пул был бы тупым). Ну и можно указывать максимальное пространство, доступное для них, прикольно

Но вот с ключами я, почему-то, того же самого сделать не додумался. Я просто шёл по запросу до двоеточия, добавляя каждый символ индивидуально. Потом аллоцировал новую строку под ключ. Зачем? Не знаю

Ну сделал то же самое, что и со значениями - заводим отдельный большой байтовый массив, кладём туда из входного потока ключ, берём на эту область слайс и свапаем к строке через ансейф. И - вуаля! - количество аллокаций снижается в два раза! Да и памяти оно теперь меньше на запрос жрёт

А ещё, индюшка теперь в бете🎉
Post #139 57
Вот что называется приятно
  • 👍 2
Post #138 58
Чайник из Юты Я тут заголовки переделал В первую очередь, все значения заголовков теперь хранятся в одном большом слайсе байт. Это уменьшает нагрузку на гц за счёт того, что теперь меньше указателей и разрозненных участков в куче (не забываем, что слайс держит указатель…
Я ошибся. Моё решение не снижает количество указателей, ведь слайс всё равно указывает на память. Но теперь она хотя бы менее фрагментирована, тут большой слайс для всех всё же хорош
Post #137 56
Я тут заголовки переделал

В первую очередь, все значения заголовков теперь хранятся в одном большом слайсе байт. Это уменьшает нагрузку на гц за счёт того, что теперь меньше указателей и разрозненных участков в куче (не забываем, что слайс держит указатель на низлежащий массив).

Это также нам дало возможность подстроить не просто максимальную длину значения заголовка, а выделить конкретное количество пространства под значения. А значит, возможен более гибкий контроль над количеством используемой памяти

Ну и ещё изменений по мелочи, благодаря которым сервер стал в два раза меньше памяти на запрос тратить
Post #136 57
Голанд хороший, голанд умный

Написал бенчмарки, и можно тут же запустить с профилировщиком. Полезно, теперь я знаю, насколько херовый у меня код
  • 🥰 1
Post #135 60
https://github.com/golang/go/discussions/56010


var all []*Item
for _, item := range items {
all = append(all, &item)
}


Здесь, в all будет len(item) одинаковых указателей, равных указателю на последний элемент в item, потому что item - переменная цикла - является не per-iteration, а per-loop. То есть, переменная item у нас одна-единственная на все итерации, и при каждой итерации её значение затирается.

Это, кстати, как раз та штука, почему надо быть аккуратным с замыканиями в циклах

Кстати, чинится добавлением в теле цикла item := item

А вот ишью, кстати, советую глянуть. Интересная штука
GitHub redefining for loop variable semantics · golang go · Discussion #56010 Update 2023-06-06: Go 1.21 is expected to support GOEXPERIMENT=loopvar as a way of trying out these new semantics. See #57969 and https://go.dev/wiki/LoopvarExperiment. We have been looking at what...
  • 👍 1
Post #134 48
А вот интереснее у меня устроен сам роутинг. Ведь если у нас только статические пути, то зачем, спрашивается, использовать префиксное дерево, если оно медленней обычной хешмапы?

Вот и я так подумал. И сделал такую штуку, что у нас динамически, при старте сервера, выбирается имплементация роутинга. Это - просто функция, которая лежит полем в структуре, и мы её вызываем, чтобы получить обработчик для запроса
Post #133 50
Чайник из Юты Я не я, если нет оптимизаций. Для роутинга я решил сделать три уровня поведения: - Пути все статичные. В таком случае, динамический роутинг нам не нужен, мы его отключаем и фоллбекаемся к текущей реализации - Пути динамические, но least unique string (самый…
В общем, с least unique string я решил забить, ибо ну его нафиг. А вот по поводу префиксного дерева, я сделал следующую штуку:

Делим путь на сегменты. Сегмент - это кусочек между слэшами. Каждый сегмент может быть как статическим, так и динамическим. Если статический - мы берём из хэшмапы следующий узел, и идём дальше. А вот если динамический - кладём этот самый сегмент в контекст, и точно также идём дальше

получилось не слишком медленно, что-то около 390нс в самом длинном шаблоне, представленным у меня в тестах. Производительность всего роутера с фоллбеком к префиксному дереву я пока не мерял
Post #132 45
Зашли-вышли, приключение на 20 минут
  • 😁 1
Post #131 54
Я не я, если нет оптимизаций. Для роутинга я решил сделать три уровня поведения:
- Пути все статичные. В таком случае, динамический роутинг нам не нужен, мы его отключаем и фоллбекаемся к текущей реализации
- Пути динамические, но least unique string (самый короткий уникальный префикс) не включает в себя динамическую часть. Тогда мы берём из мапы по этому least unique string нужный нам шаблон, и сверяем
- Пути динамические, и least unique string вмещает в себе динамическую часть. В таком случае, берём это самое наше префиксное дерево, о реализации которого я отпишусь позже
Post #130 51
Чайник из Юты В общем, сравнение пути по шаблону я сделал, и вроде шустрое (само по себе - 80-90нс в худшем случае выдаёт). До 245нс жиреет из-за контекстов (без пропатченных - там до 700-800нс вырастает, прям как регулярки). Сейчас буду пилить префиксное дерево, потому…
Кстати, по поводу пропатченных контекстов - мне нужен конкретно WithValue. О нём я уже писал. Он всё ещё был медленным из-за того, что использовал any (просто any, а не как дженерик), а это интерфейс. А интерфейс под капотом хранит указатель. А указатель утекает на кучу. А утекание на кучу приводит к аллокациям

Переделал под дженерики. С 635нс производительность улучшилась до 245нс, количество аллокаций с 6-10 уменьшились до 3-5, т.е. в два раза. Пока что перемога, посмотрим, насколько префиксное дерево будет влиять на итоговый перфоманс
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →