
Повторное использование данных: скрытый ресурс цитируемости
За последние два десятилетия открытые данные стали одним из ключевых инструментов преодоления кризиса доверия к науке: их повторное использование повышает воспроизводимость результатов и снижает расходы на исследования. При этом, согласно данным Data Citation Index (DCI), около 85 % размещенных там наборов данных остаются без цитирований и, соответственно, не используются. Такая тенденция может быть связана с предубеждением по отношению к «вторичному» анализу данных: не до конца ясно, как он отражается на восприятии итоговой работы. Станет ли такая публикация казаться менее оригинальной и престижной? Будут ли её читать и цитировать?
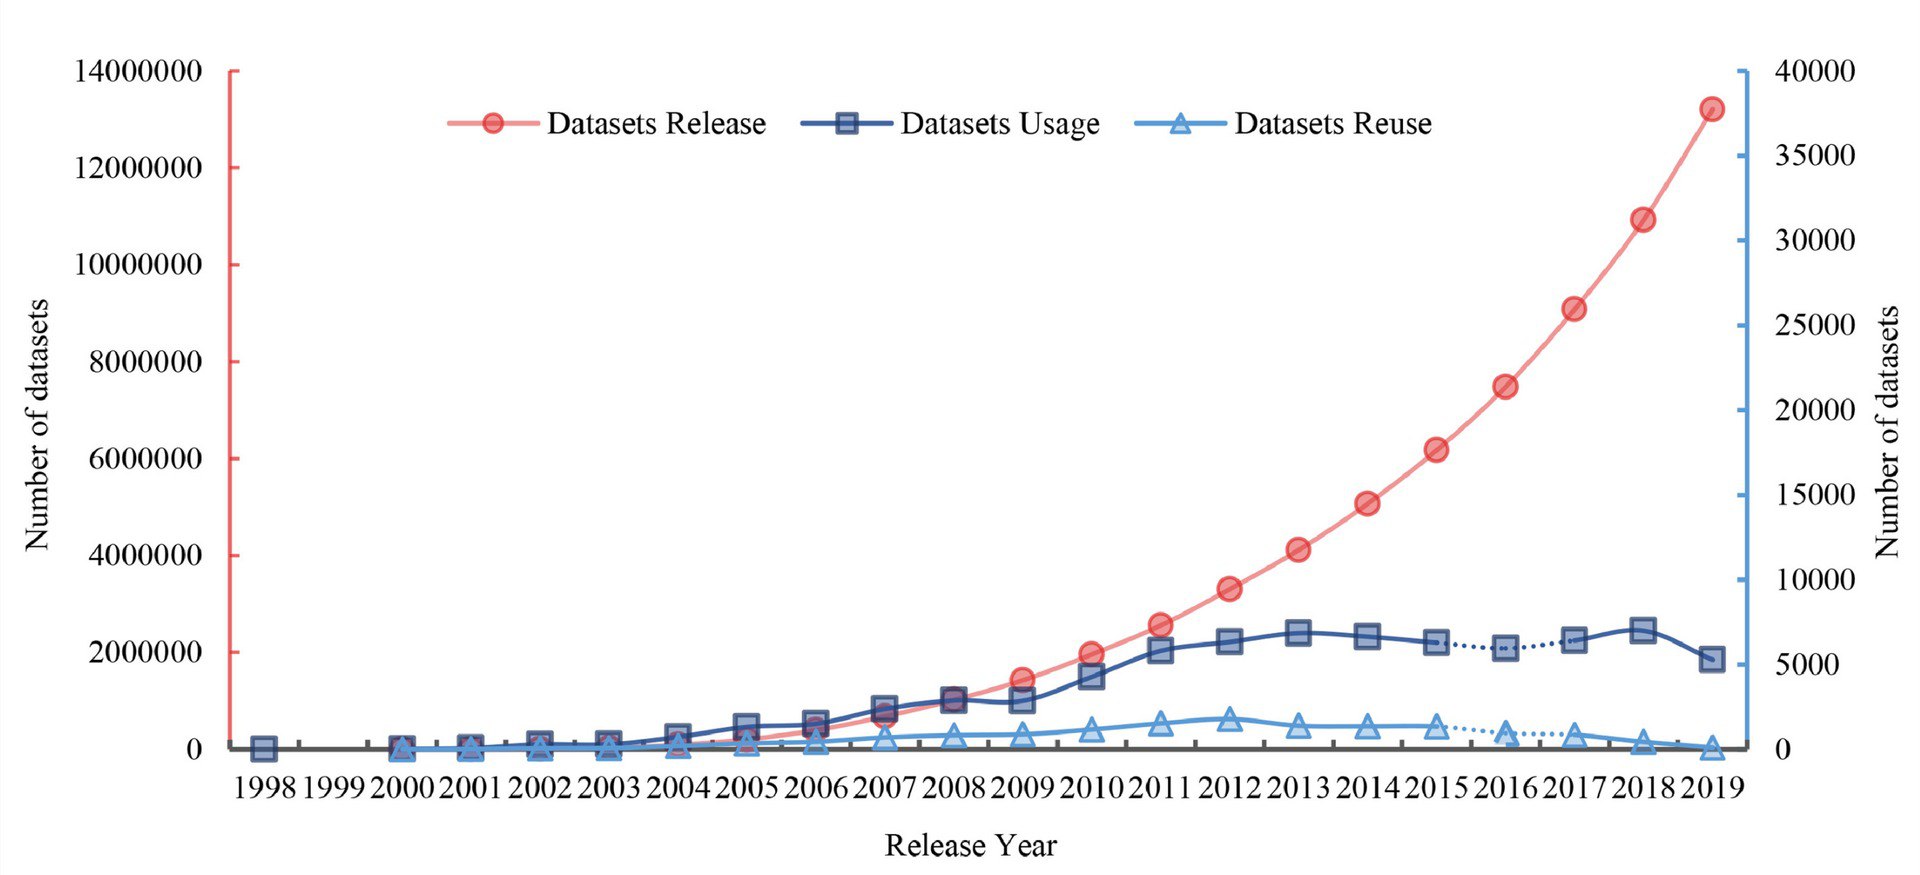
Недавно в Journal of Informetrics вышла статья, в которой оценили, как повторное использование данных отражается на научном влиянии публикаций (т.е. количестве цитирований). Авторы проанализировали наборы данных GEO за период с 1998 по 2017 год (данные за 2018–2019 годы приведены дополнительно на рисунке). По их оценкам около 65 % наборов данных (47 642) были процитированы хотя бы один раз в течение двух лет после публикации.
Несмотря на резкий рост числа открытых наборов данных на площадке (с 15 до 13 206 769 за два десятилетия), начиная с 2009 года темпы стабилизировались и средний прирост составил около 25 % в год. При этом динамика использования данных развивалась поэтапно. C 2000 по 2013 год число наборов данных росло очень быстро (среднегодовой темп около 61 %), но затем вышло на плато: в 2014–2017 годах оно удерживалось в диапазоне 5000–7000 в год.
Повторное использование данных развивалось по схожей траектории: стремительный рост в 2000–2012 годах (около 58 %), за которым последовало замедление — до около 11 % в год в 2013–2017 годах. Т.е., несмотря на впечатляющее увеличение объёма открытых данных, доля наборов, которые находят применение в научных исследованиях, за период 1998–2017 годов почти не изменилась. Примечательно, что лишь 0,14 % всех опубликованных на GEO наборов данных когда-либо использовались в исследованиях, а повторно — всего 0,03 %.
Сравнение трех сценариев (учёные повторно используют свои данные, чужие данные или вовсе не занимаются повторным анализом) показало, что статьи с повторным использованием данных в среднем цитируют чаще — и особенно те, где авторы возвращаются к собственным наборам.
Более того, эта закономерность сохраняется даже после исключения самоцитирований. Чем чаще автор упоминает свою же работу, тем больше на неё обращают внимание другие, т. е. работает «стадный инстинкт» (sheep flock effect).
К сожалению, даже при отсутствии негативного восприятия повторного анализа со стороны научного сообщества значительная часть данных всё ещё остаётся «невидимой» — формально опубликованной, но фактически неиспользуемой. Причины лежат как в несоответствии части наборов принципам FAIR, так и в некорректных практиках цитирования, которые занижают их видимость в наукометрических системах.
#открытыеданные #воспроизводимость #цитирование
Post #569
2.58K
- ❤ 6
- 👍 5