TGViewer
Channel Public Channel
Градиентное погружение

Градиентное погружение

@gradientdip

Обсуждаем новости, рассказываем про ML с кодом и колабом, выигрываем соревы 🏆

Контакты: @Cene655, @Cucu_LaPraline
Subscribers
4.2K
Photos
179
Videos
11
Links
163

Showing posts older than #56 · Back to latest

Older Posts 18 shown
Post #55 1.19K
Как быстро спарсить фотки из гугла/яндекса? ⚡️

👉 Представим ситуацию - вам необходимо собрать набор данных для генерации картинок, но вы слишком уставши, чтобы искать готовые решения или просто писать код.

Что делать в такой ситуации? Поспать Просто следуйте следующей инструкции:

1️⃣ Откройте хром, вбейте нужный запрос в поисковую систему(я пользуюсь яндексом, так как фильтры удобные)

2️⃣ Медленно прокрутите страницу с выдачей до нужного количества изображений

3️⃣ Сохраните страницу "полностью". Создастся один файл и папка с картинками

4️⃣ Запускаем файл converter.py и указываем полный путь к папке. Скрипт создаст папку images со всеми картинками в разрешении примерно 480 * 270

Опционально: запускаем delete.py и указываем полный путь, чтобы удалить дубли по хешу

🔥 В итоге, буквально за 5 минут можно спарсить порядка 1500 изображений, что довольно дёшево и сердито.
  • 👍 10
  • 😱 1
Post #54 905
Победили в хакатоне по ИИ 🥳

👉 Тут недавно Сбер организовывал хак по распознаванию рукописного текста на тетрадных листах, ну и админы решили принять участие.

👀 В течение трех недель решали задачи сегментации(выделения слов) и их последующее распознавание(задача OCR). В качестве метрики использовалась комбинация IOU и CER.

Сегодня стал доступен приватный лидерборд и оказалось, что один из админов как был на первом месте, так и остался, а второй отлетел со второго места на четвертое(с разницей в 5/10000) 😕.

В итоге удалось унести макбук и сбер портал.

Лидерборд
  • 👏 11
  • 👍 3
  • 🔥 2
Post #53 804
VideoDalle - как генерация гифок, только лучше 🙆

Пост назад мы говорили что выпустим код, и так, теперь его можно найти в репозитории ruDalle.

Суть работы в том, что вместо генерации одной картинки мы обучаем генерировать сразу несколько. Это позволяет делать картинки более связанными и последовательными.

Спасибо каналу Love. Death. Transformers за пост и код ревью.

Колаб ноутбук
Telegram Градиентное погружение ⚡️ VideoDALLe На днях мы адаптировали модель ruDALLe, которая генерирует картинки по тексту, к генерации видео по тексту. 🔥 Скоро представим код нашей работы, а пока ловите видосики: теннис, прыжок в воду и бильярд.
  • 👍 7
  • 👏 1
Post #52 630

Forwarded from Love. Death. Transformers.

Мы наконец выкатили пример супер прикольного файнтюна Рудольфа на любопытную задачу предсказания калорийности еды по фото

тут
  • 👍 4
Post #49 862
⚡️ VideoDALLe

На днях мы адаптировали модель ruDALLe, которая генерирует картинки по тексту, к генерации видео по тексту. 🔥

Скоро представим код нашей работы, а пока ловите видосики: теннис, прыжок в воду и бильярд.
  • 👍 6
  • 👏 2
Post #48 631
  • 🔥 4
Post #46 606
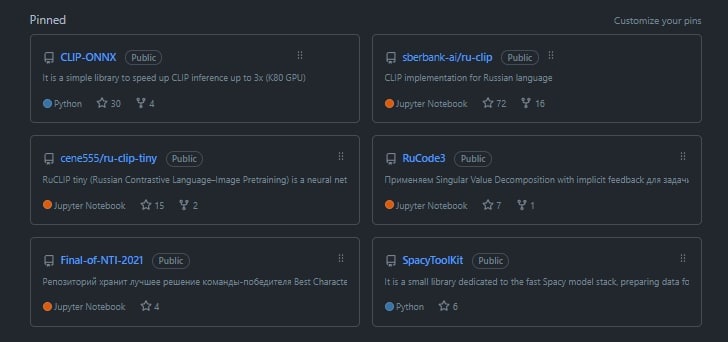
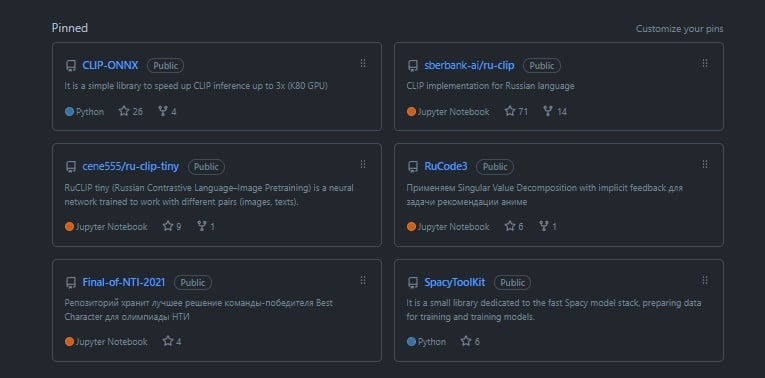
👀 Гитхаб обновил интерфейс на сайте.
Теперь описание для закрепленных репозиториев отображается одной строкой без переносов.

Если честно, не очень приятно, так как мои описания не влезают.
Post #45 634
  • 😁 7
Post #44 2.64K
MusicBot - работает за вас, крутится у нас ⚡️

Мы готовы представить вам бета версию нашего нового мультитаск бота 🔥

Что он умеет? Ну вообще 3 вещи:
1️⃣ Создавать музыку в разных жанрах: calm, jazz, classic, pop
2️⃣ Общаться на английском (диалоговый бот)
3️⃣ Радовать вас результатом

Хотим заметить, что бот будет работать только ближайшие 24 часа, но если мы увидем заинтересованность аудитории, то подумаем над расширением.

За генерацию музыки отвечает модель music composer, разработанная командой SberAI, а за генерацию текста - всеми любимая GPT2.

Попробовать бота, спросить о жизни и послушать джаз можно тут - @gpt_music_bot
GitHub GitHub - ai-forever/music-composer Contribute to ai-forever/music-composer development by creating an account on GitHub.
  • 🔥 6
Post #42 663

Forwarded from эйай ньюз

CLIPasso: AI Создает скетчи по картинкам

В этой статье комбинируется дифференциальный рендеринг и CLIP. И, конечно, никакой это не настоящий AI 😅

Вот как это работает:
По картинке предсказываются приблизительные параметры линий, составляющих карандашный набросок. Затем параметрическое представление линий растеризуется и кормится в CLIP для вычисления похожести наброска с оригинальным изображением. Ошибка пропихивается назад до параметров линий и они итеративно обновляются, увеличивая совпадение со входной картинкой.

>> Папира >> Страница проекта
Post #41 982
Это не шутка, катбуст рекламируют на стендах.
Интересно, какая у них конверсия?

Кст, оказалась, что звездочку приписывают не просто так, а потому что могут влепить штраф
  • 🤩 12
Post #40 620
Post #39 558

Forwarded from тоже моушн

исследователи из гугла на днях выложили алгоритм frame interpolation. он умеет делать что то типа оживших фото из гарри поттера - гифку из набора картинок. так вот он неожиданно хорошо показал себя при замедлении анимаций сделанных в VQGAN+CLIP, pytti или Disco Diffusion. собрал это дело в колаб!

frame interpolation on github
demo video on youtube
colab notebook
Post #38 555

Forwarded from AbstractDL

OFA: нужно лишь спросить

One For All — мультимодальная модель от Alibaba, которая умеет решать практически все CV-NLP задачи:
- text2image generating
- image captioning
- image inpainting
- VQA
- object detection
- NLU

Мало того, что она побила кучу сот, но и впервые для переключения между задачами не требуется совсем никаких архитектурных изменений (как во Florence). Нужно всего лишь текстом указать что мы хотим: «Закрась центр картинки» или «Что находится в *координаты куска картинки*?». Но САМОЕ крутое здесь это то, что модель смогла обобщиться на новые задачи, которых не было во время обучения — главное правильно сформулировать, что от неё требуется.

Технические детали:
Это энкодер-декодер архитектура — гибрид VQVAE и BART. Для слов, координат и визуальных токенов используется общий словарь репрезентаций, благодаря чему можно произвольно комбинировать модальности. Обучается это всё только на общедоступных данных, за что отдельный респект.

Статья, GitHub
Post #36 548
Код для получения примера прилагается:

# !pip install git+https://github.com/Desklop/StressRNN
from stressrnn import StressRNN
import re

stress_rnn = StressRNN()
text = "Шифровальщица попросту забыла ряд ключевых множителей и тэгов."
stressed_text = stress_rnn.put_stress(text)
print(stressed_text)
print(re.compile(r"(.)\+", re.UNICODE).sub(r"+\1", stressed_text))
# ^ формат для silero
  • 👍 1
Post #35 544
Silero может лучше

Если вы работали с text2speech или speech2text моделями, то скорее всего уже знаете о существовании такой разработки как Silero. Простая в использовании, с хорошим качеством(по мере опенсурса) и в меру быстрая библиотека. Ещё она умеет расставлять автоматически ударения(улучшает качество синтеза речи), но получается не всегда хорошо, поэтому давайте пилить костыли.

Обычно я использую для этого библиотеку StressRNN. Она инференсится на onnxruntime и имеет в себе небольшой словарь для проверки корректности.

Получается недурно, так например
Вход: Шифровальщица попросту забыла ряд ключевых множителей и тэгов.
Выход: Шифров+альщица п+опросту заб+ыла р+яд ключев+ых множ+ителей +и т+эгов.
  • 👍 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →